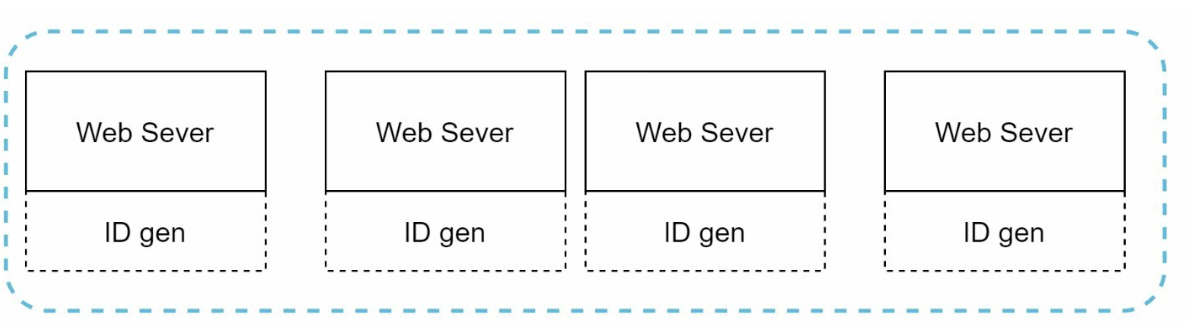
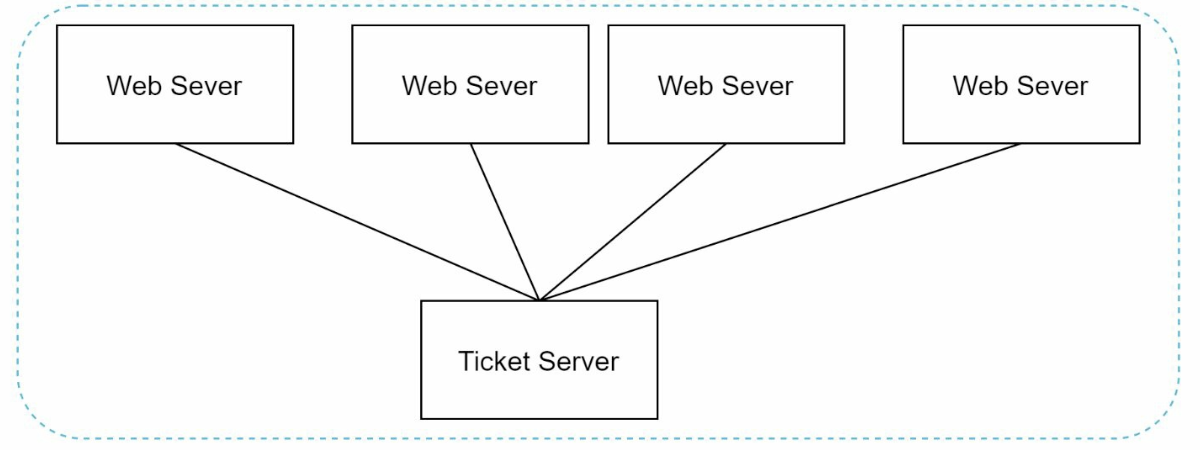
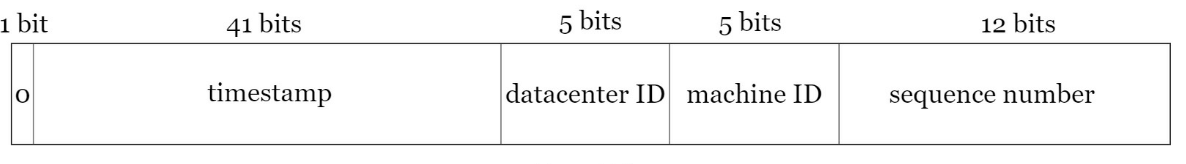
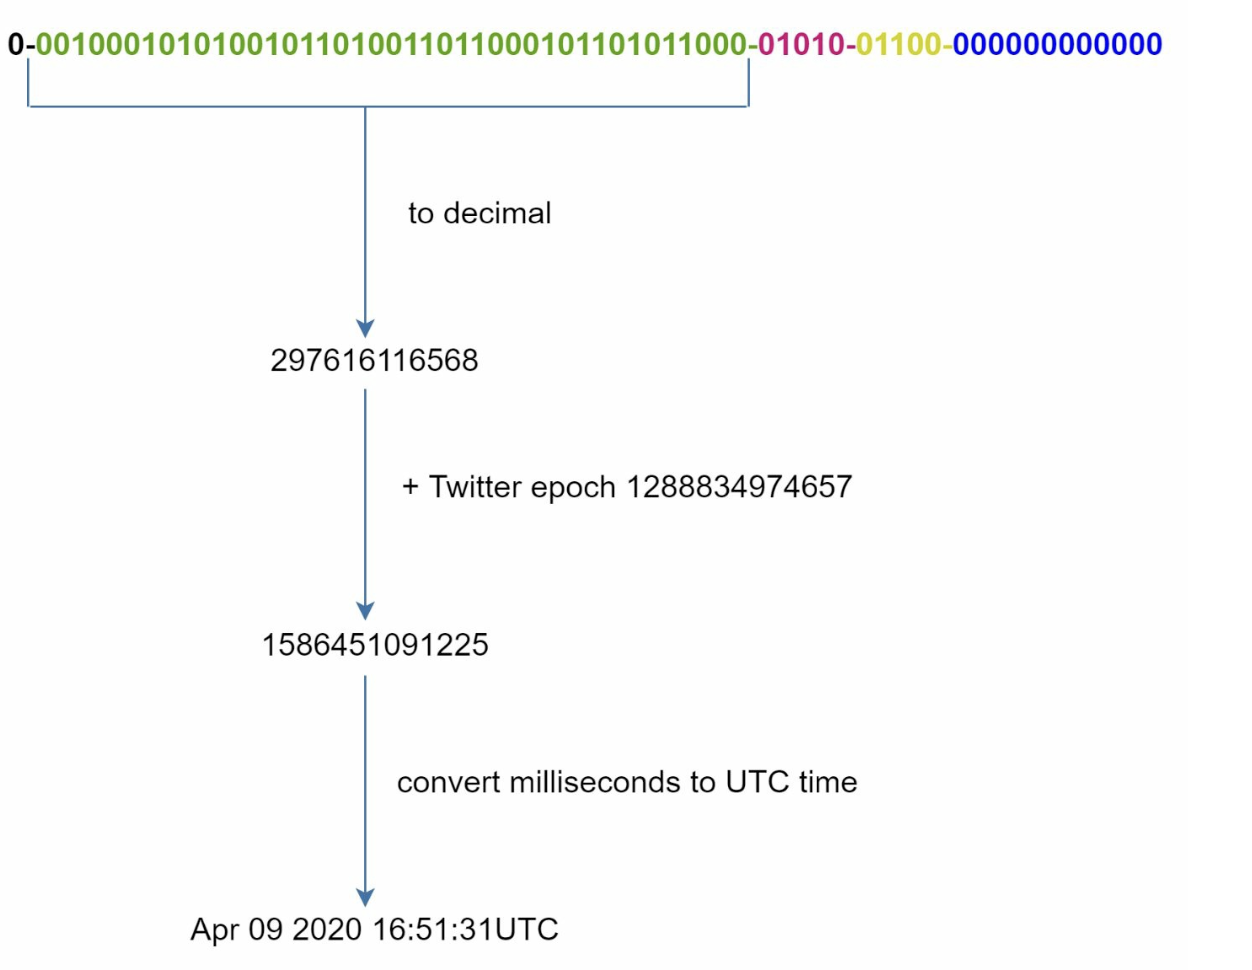
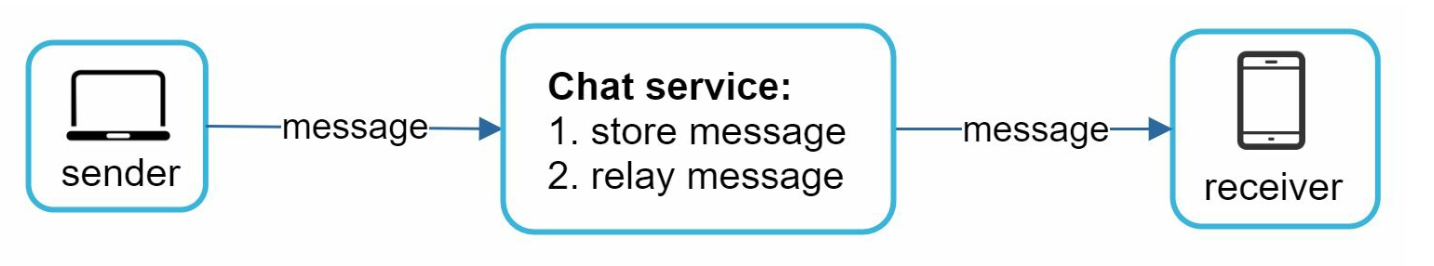
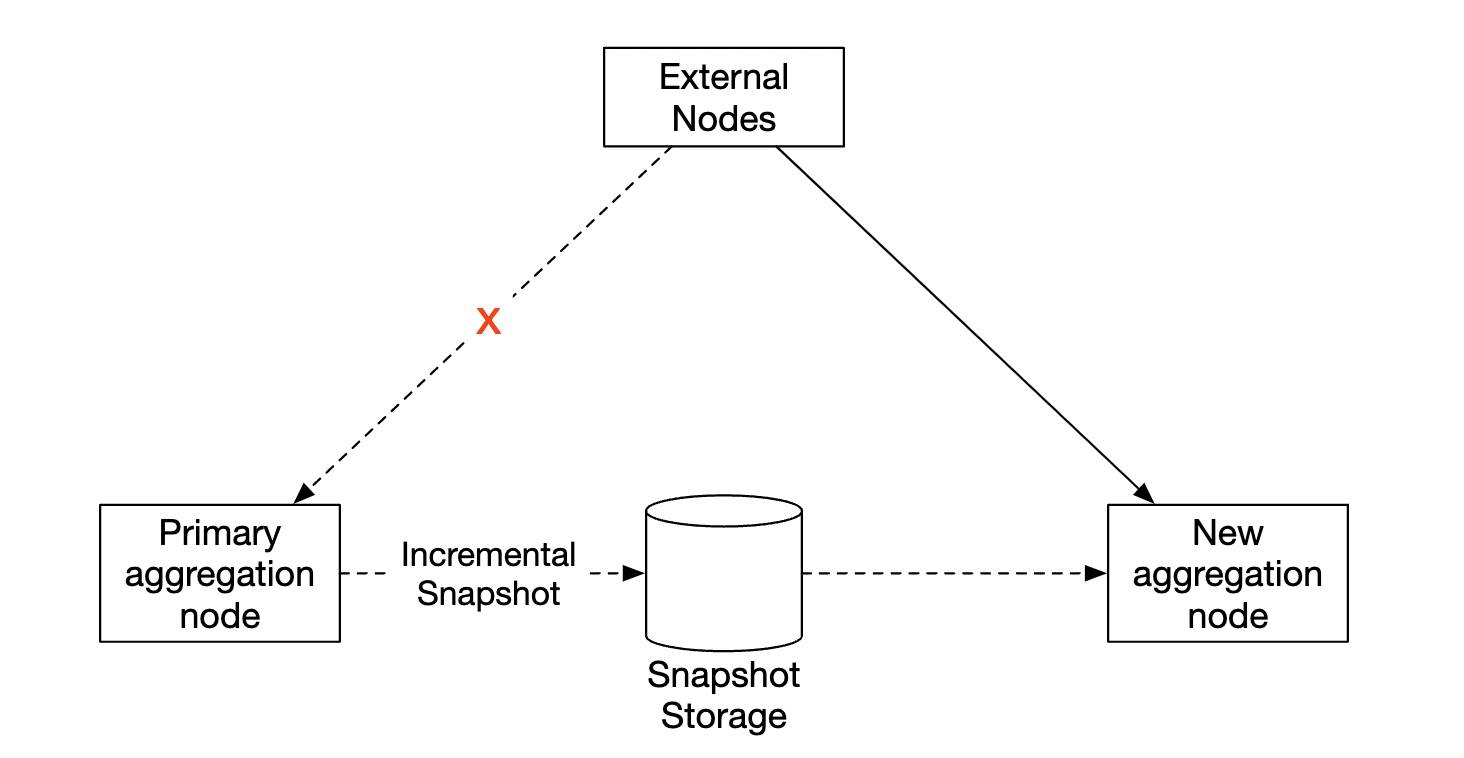
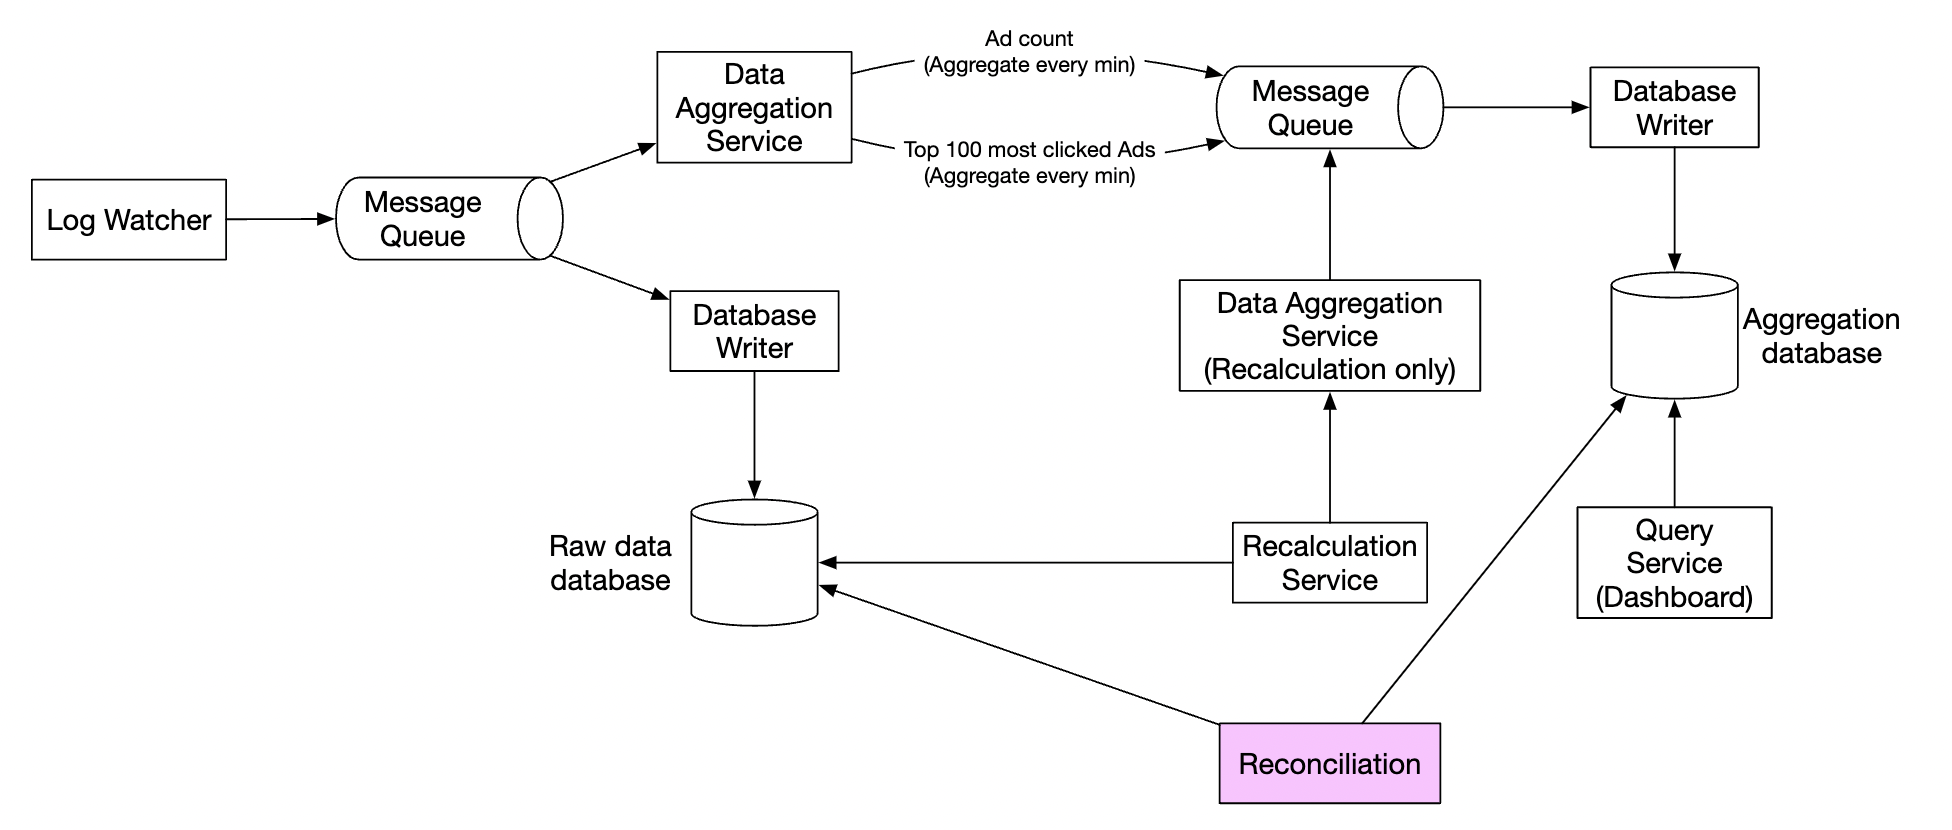
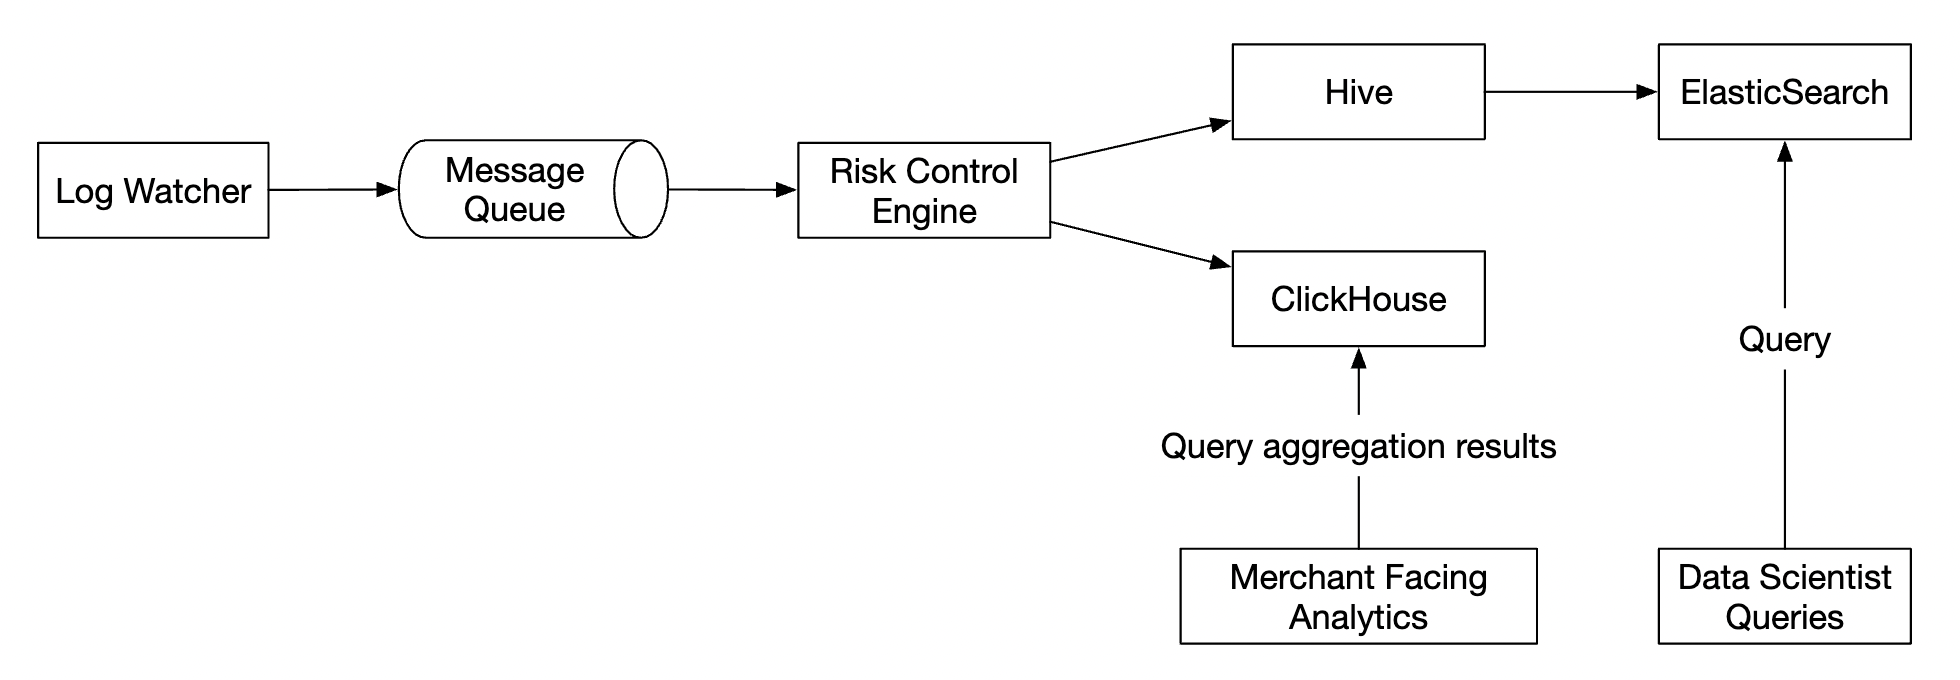
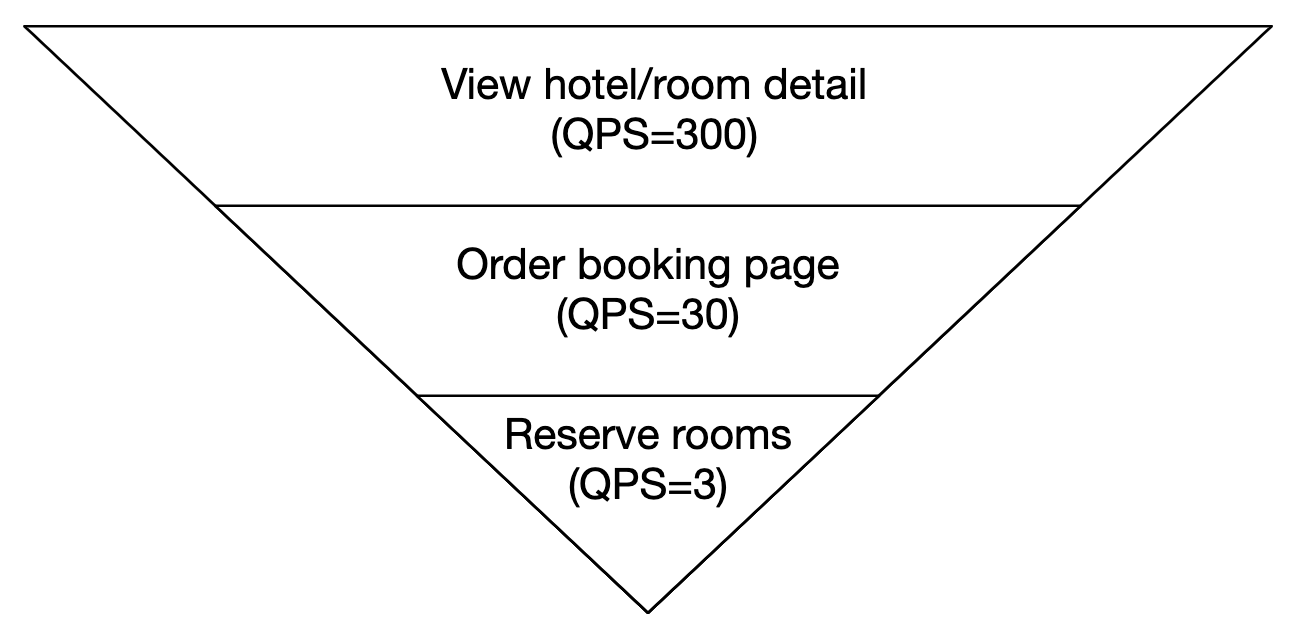
接收端:
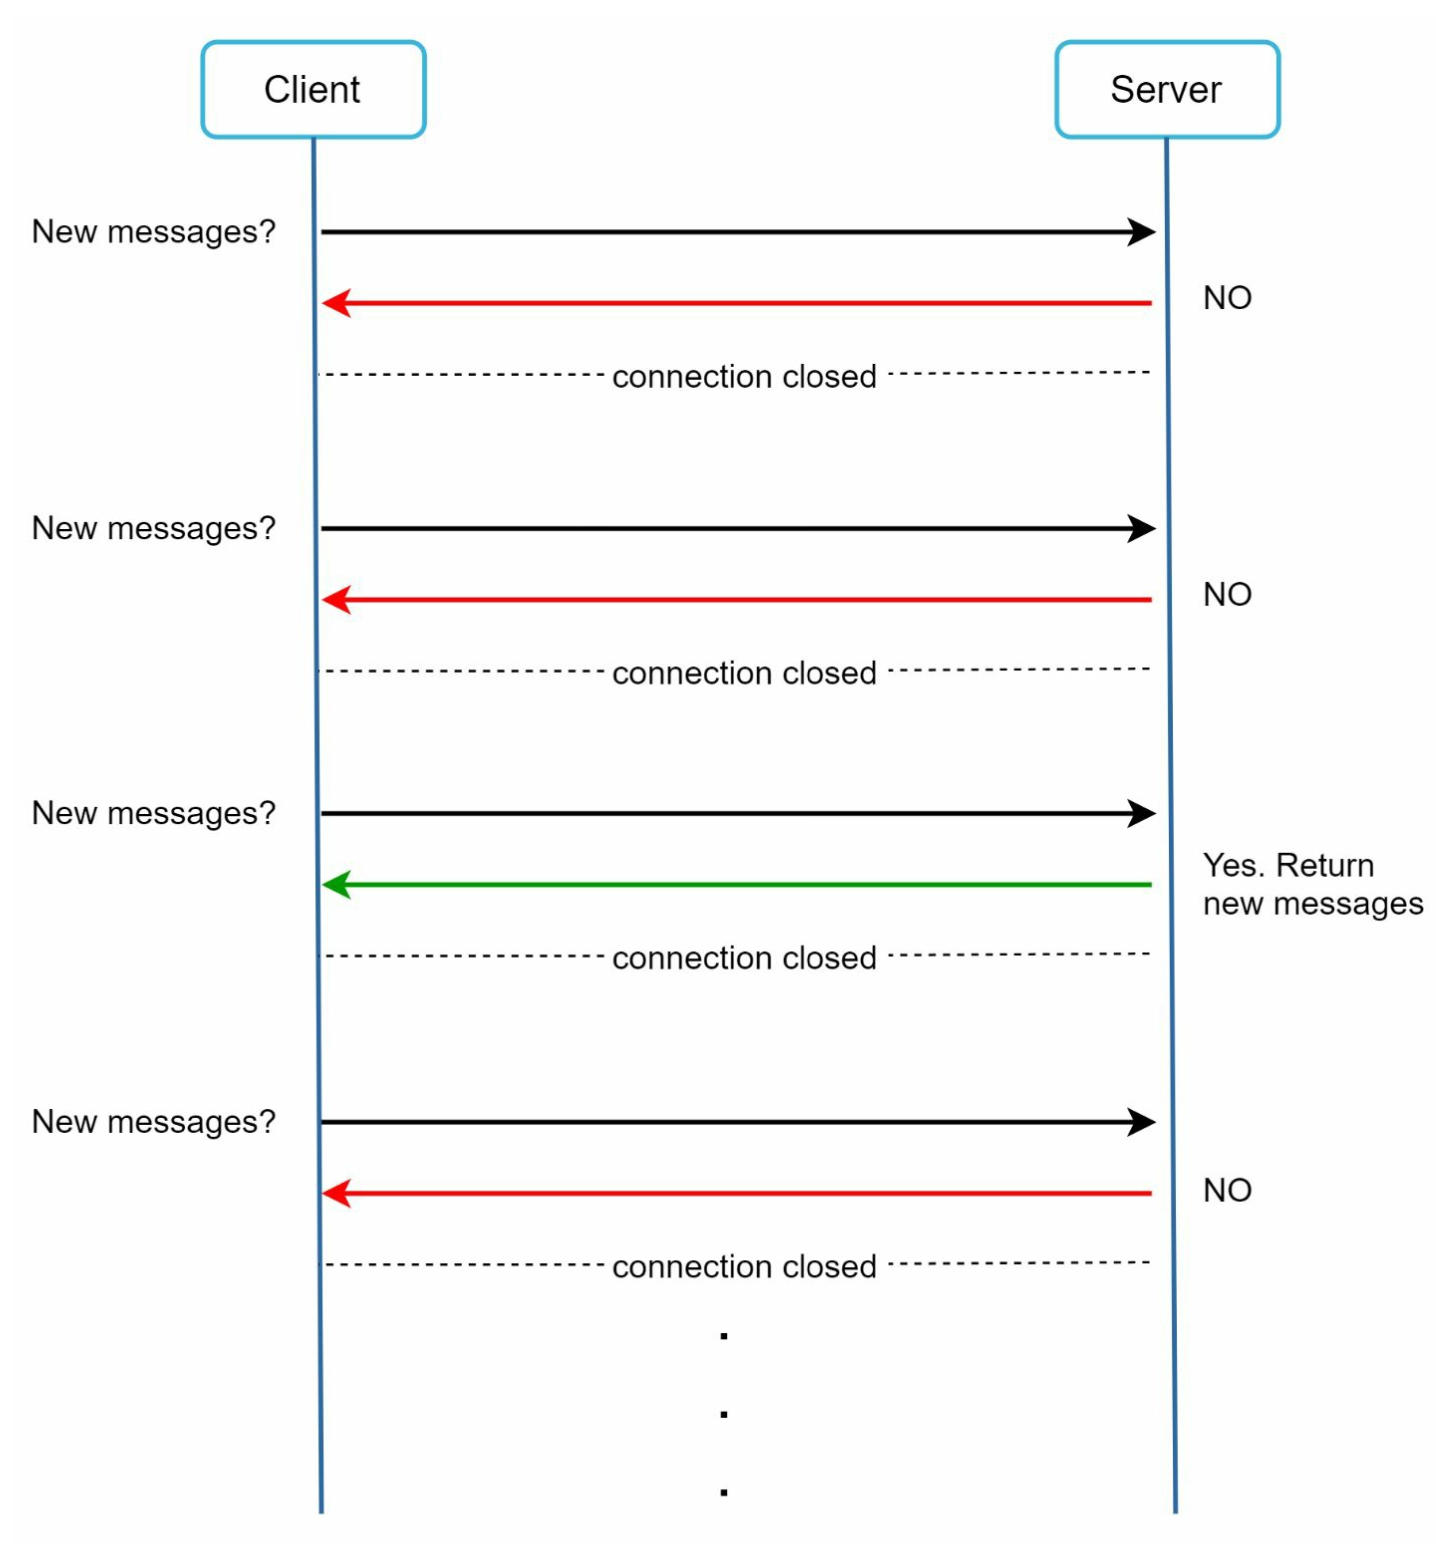
轮询:
客户端定期询问服务器是否有新消息。
由于频繁、冗余的请求,效率较低。
短轮询 客户端每隔固定时间就问一次服务器「有新消息吗」。服务器无论有没有消息都立刻返回,于是产生大量无效请求,浪费带宽与服务器资源。 客户端 定时轮询 服务器 立即响应 有新消息? 无,立即返回 有新消息? 无,立即返回 服务器立即返回,多数轮询是空跑 按 diagram-design 重绘 查看原图
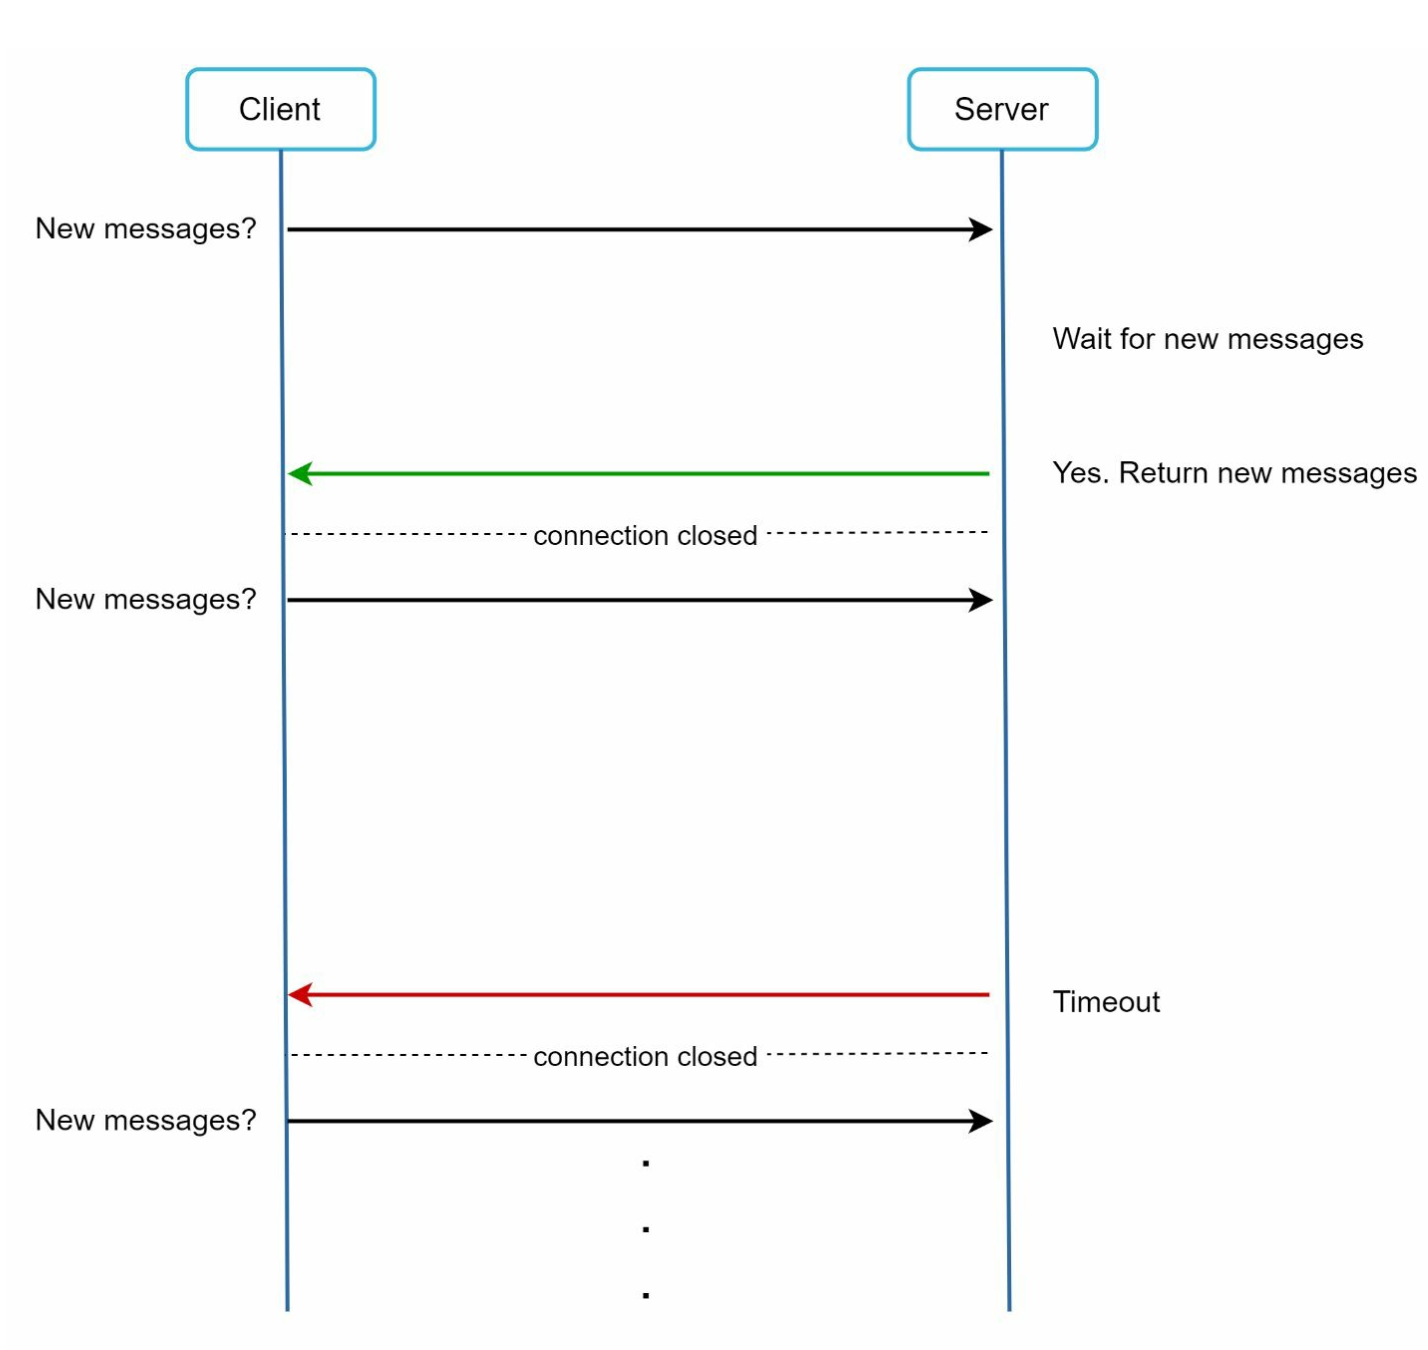
长轮询:
保持连接打开,直到有消息到达。
对不活跃用户效率较低。
长轮询 客户端发一次请求后,服务器把连接挂起,直到真有新消息或超时才返回。相比短轮询少了很多空跑,但对不活跃用户仍会反复超时重连。 客户端 发起请求 服务器 挂起等待 有新消息? 有新消息 / 超时 有新消息? 连接超时 连接挂起直到有新消息或超时 按 diagram-design 重绘 查看原图
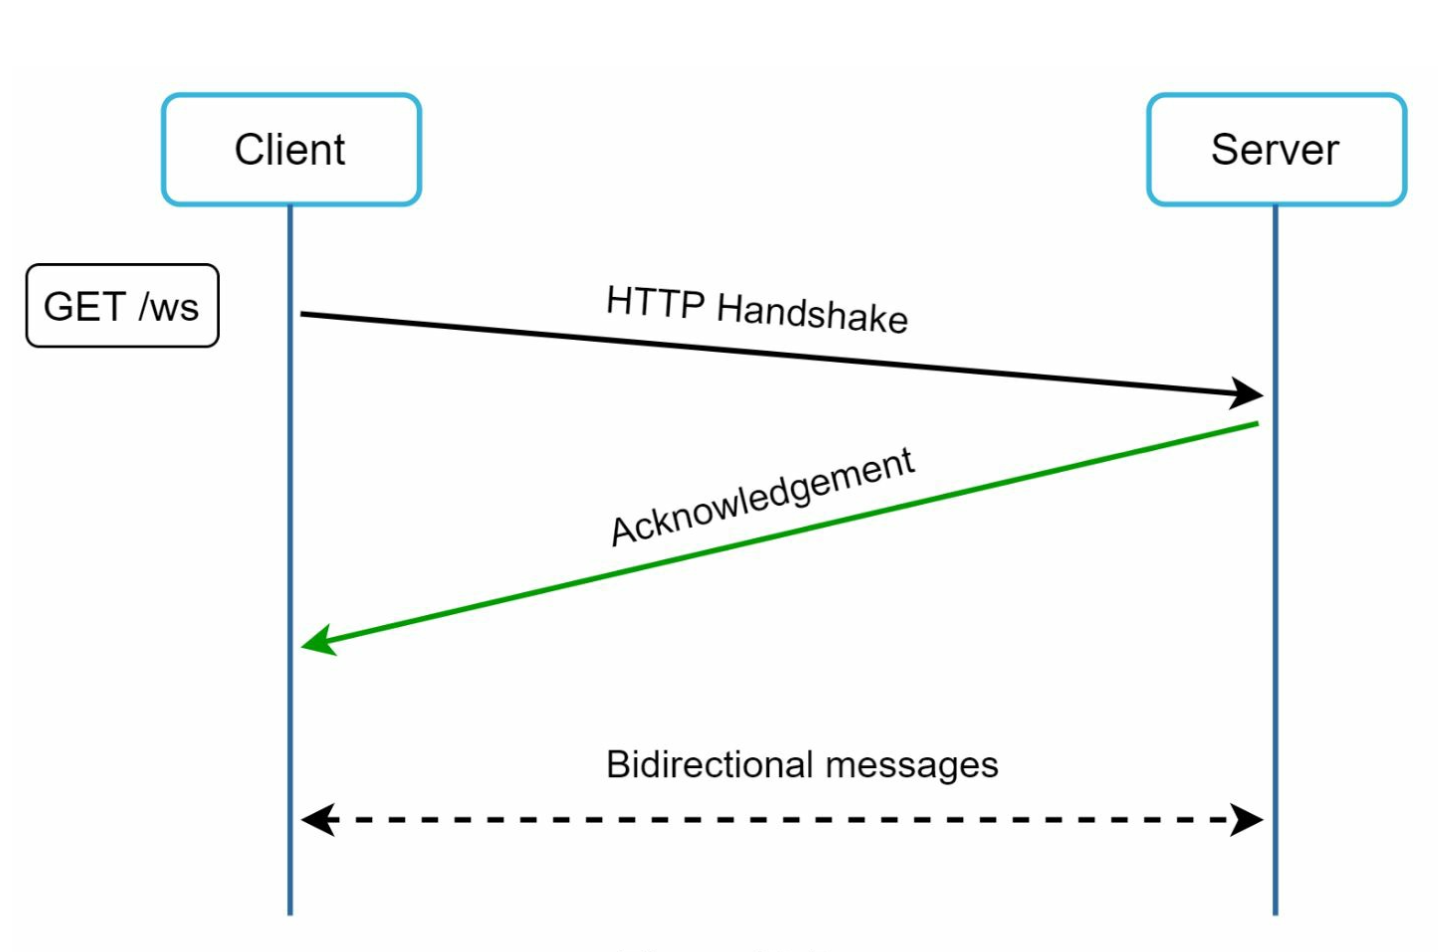
WebSocket:
组件
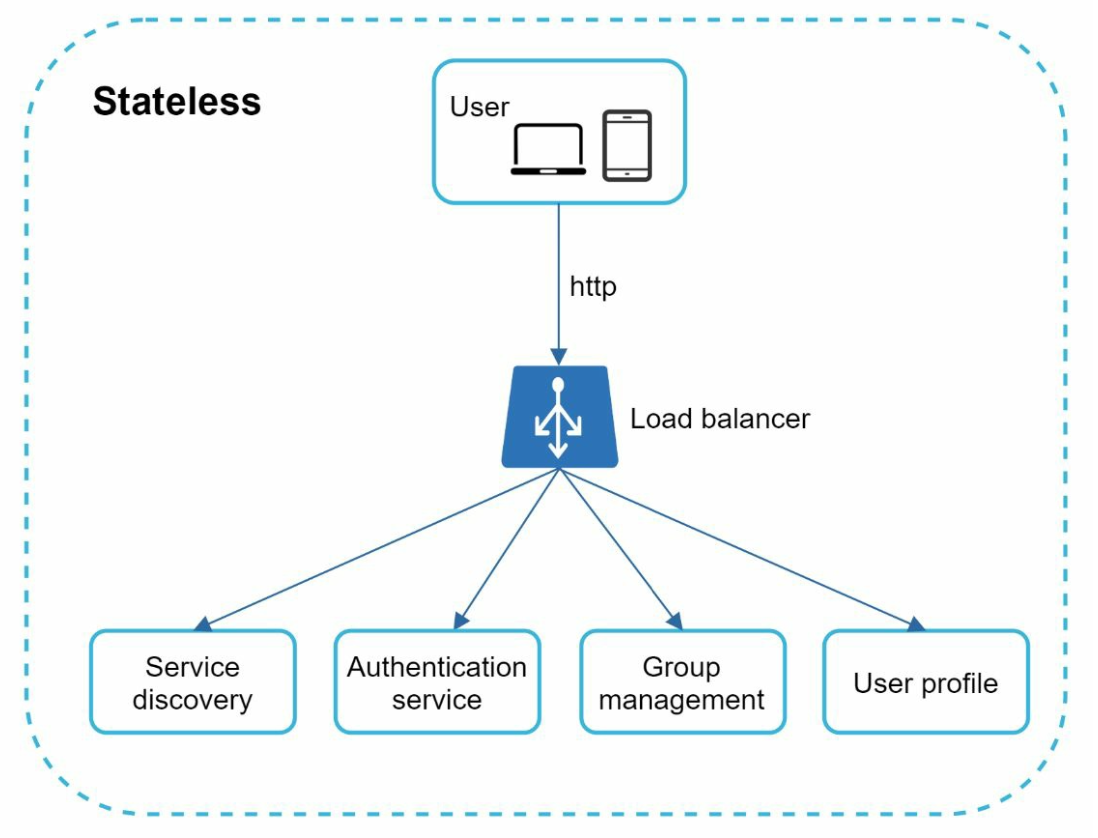
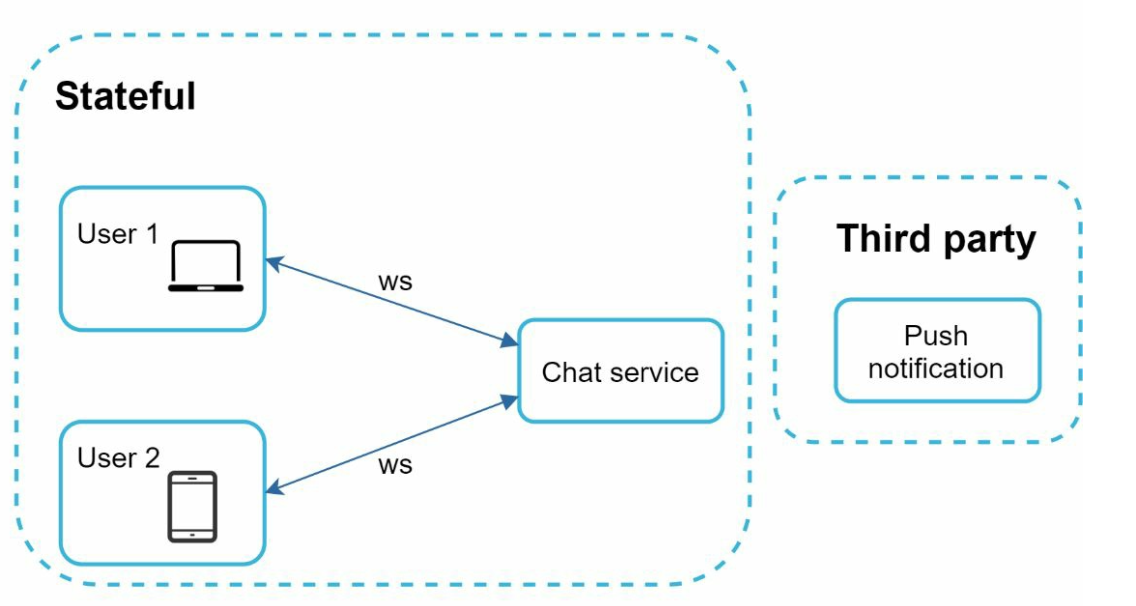
无状态服务 无状态层负责注册、登录、资料管理等与连接无关的事:用户请求先经负载均衡,再分发到服务发现、鉴权、群组管理、用户资料等服务。它们不保存会话状态,因此可以随意水平扩容。 无状态 用户 登录 / 注册 负载均衡 服务发现 鉴权服务 群组管理 用户资料 http 负载均衡把请求分发到各无状态服务 按 diagram-design 重绘 查看原图 有状态服务 有状态层的 Chat 服务与用户之间维持 WebSocket 长连接,负责消息投递与同步。用户离线时,Chat 服务转而调用第三方推送服务,把新消息通过 APNS / FCM 推给设备。 有状态 第三方 用户 1 长连接 用户 2 长连接 Chat 服务 维持 ws 连接 推送通知 ws ws 离线推送 用户离线时改走推送通道 按 diagram-design 重绘 查看原图
无状态服务:
处理注册、登录和用户资料管理。
与服务发现集成,推荐最佳聊天服务器。
有状态服务:
聊天服务器维护持久的 WebSocket 连接。
负责消息投递和同步。
第三方集成:
推送通知服务通知用户新消息。
通知实现参见“通知系统”章节。
设计
客户端与聊天服务器保持持久 WebSocket 连接以进行实时消息收发。
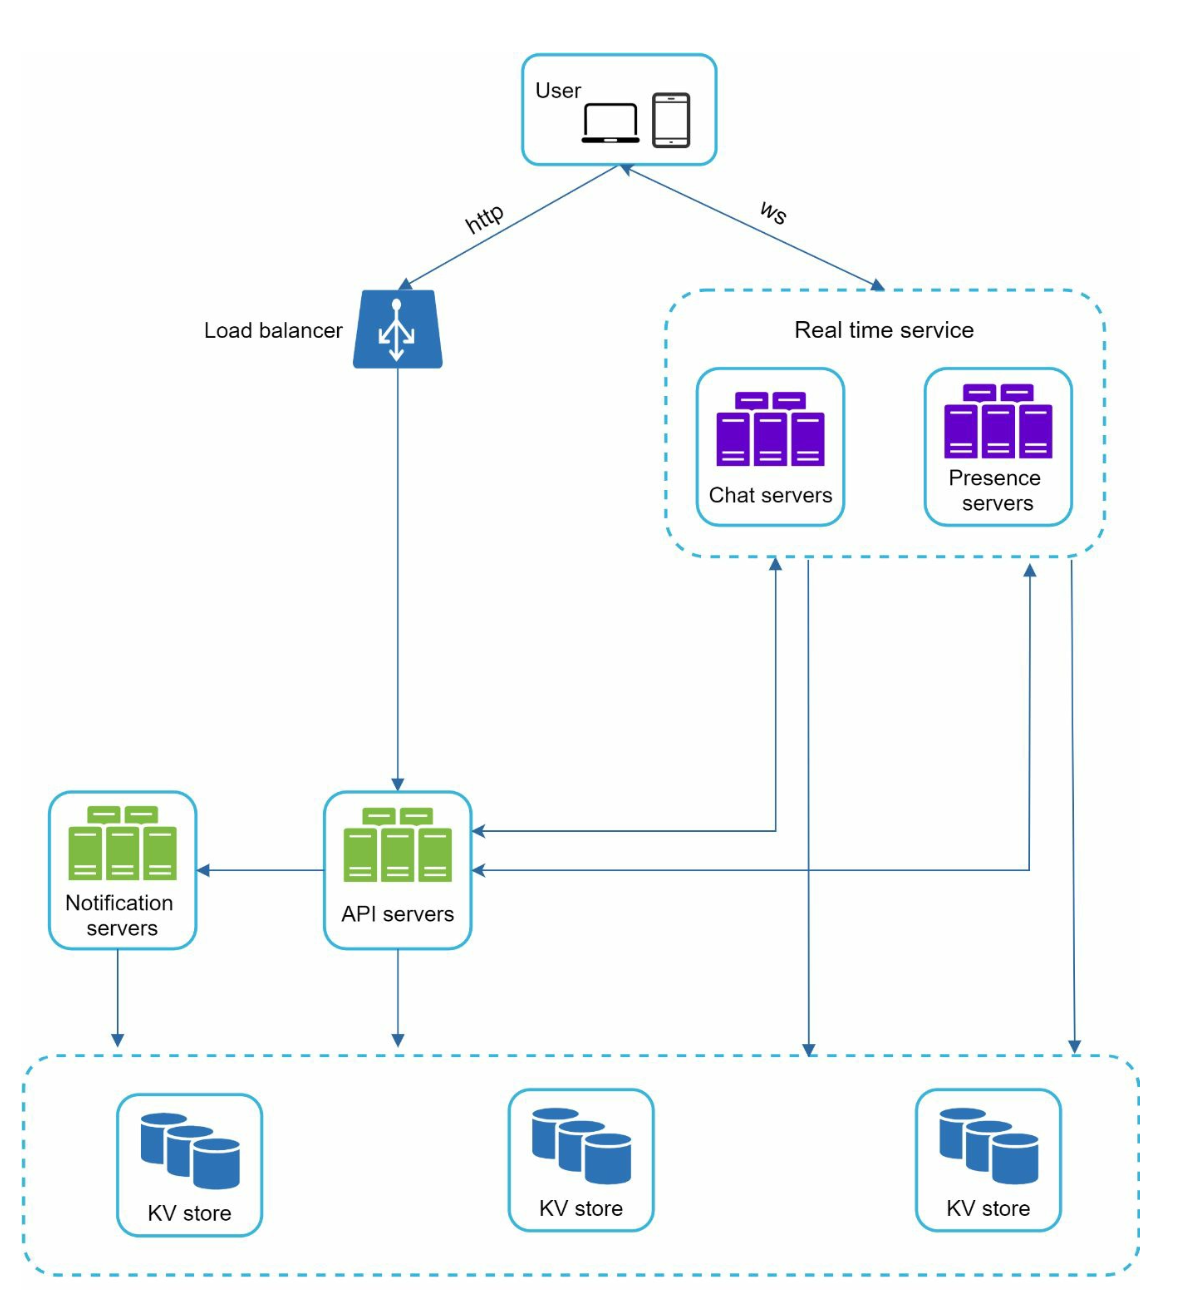
聊天系统高层设计 客户端与 Chat 服务器建立 WebSocket 长连接收发实时消息;HTTP 请求走负载均衡到 API 服务器处理登录、资料等;在线状态服务器维护在线状态;通知服务器负责离线推送;KV 存储保存聊天记录,便于水平扩展与低延迟读取。 实时服务 KV 存储(聊天记录) 用户 多设备 负载均衡 Chat 服务器 ws 长连接 在线状态服务器 API 服务器 登录 / 资料 通知服务器 离线推送 KV 存储 KV 存储 KV 存储 http ws http 存储 状态 读写 ws 收实时消息,http 走 API 按 diagram-design 重绘 查看原图
聊天服务器负责消息发送/接收。
在线状态服务器管理在线/离线状态。
API 服务器处理所有事务,包括用户登录、注册、修改资料等。
通知服务器发送推送通知。
最后,键值存储用于保存聊天记录。使用键值存储作为聊天历史数据数据库的原因如下:
便于水平扩展。
KV 存储提供极低延迟的数据访问。
关系型数据库不擅长处理长尾数据。当索引增长很大时,随机访问成本高昂。
键值存储已被其他经过验证的可靠聊天应用采用。例如,Facebook messenger 和 Discord 都使用键值存储。
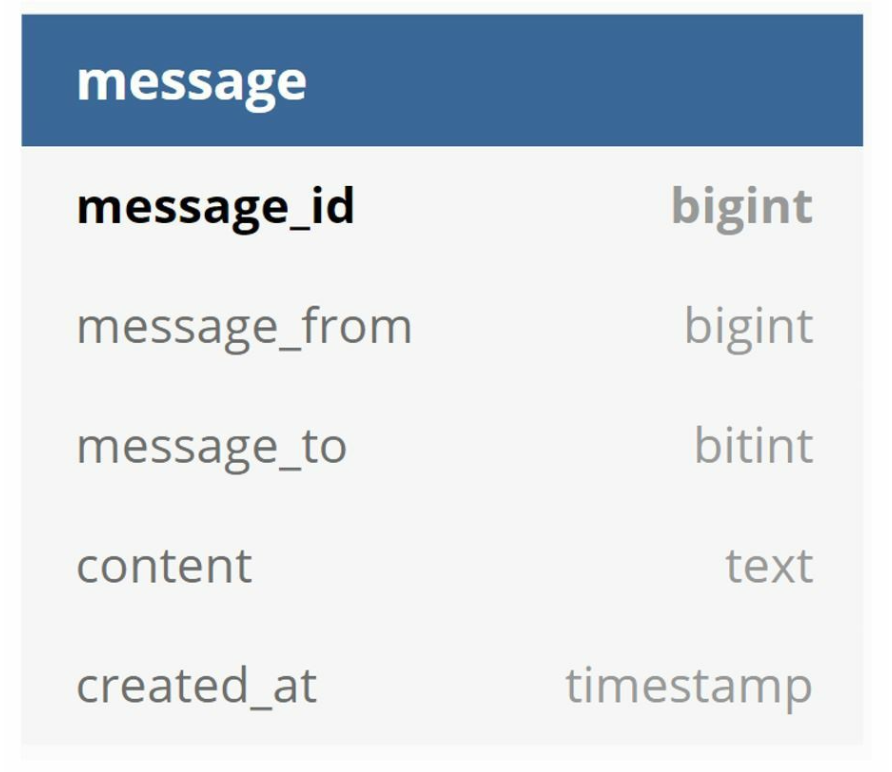
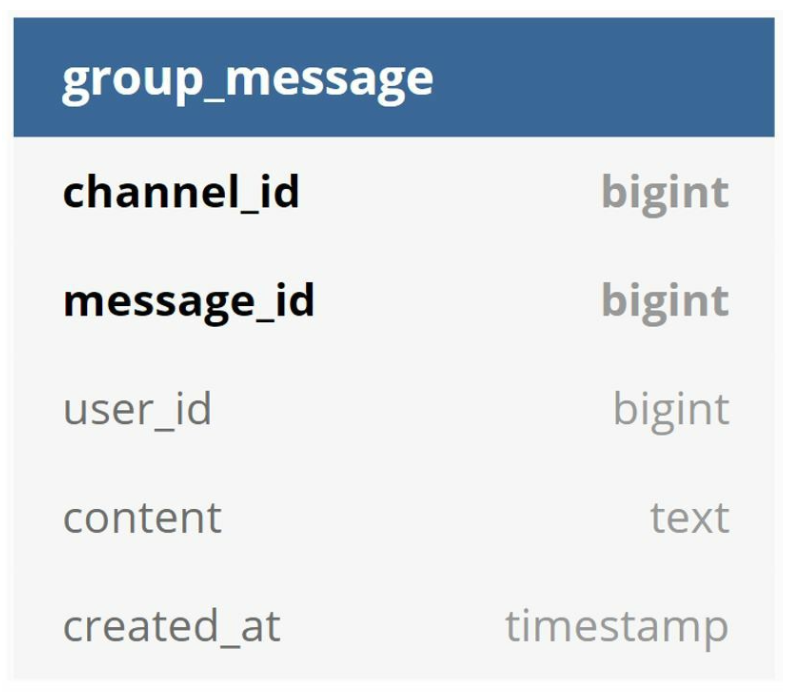
以下是一对一聊天和群聊的数据模型。
步骤 3:设计深入探讨
服务发现
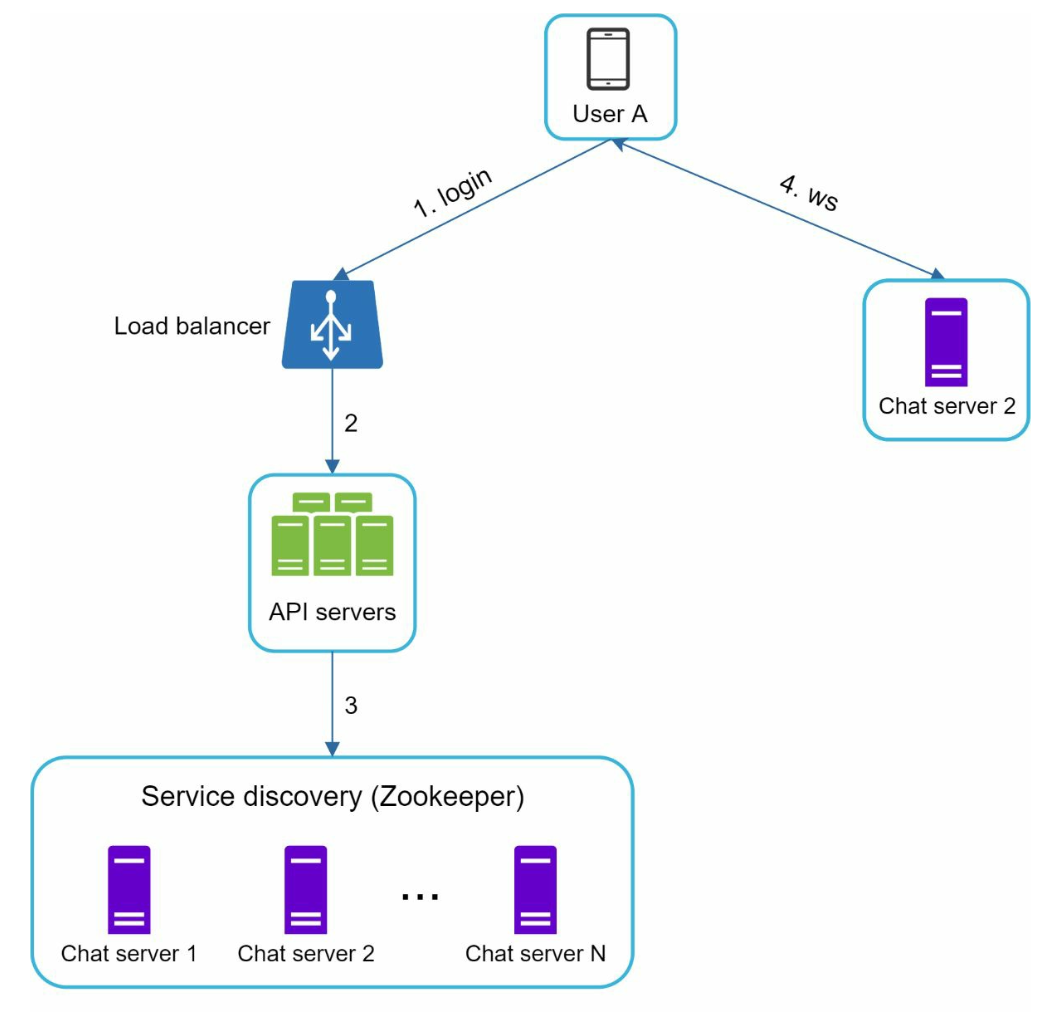
服务发现 用户登录(1)经负载均衡(2)到 API 服务器,API 服务器向服务发现(Zookeeper)(3)查询可用的 Chat 服务器;Zookeeper 按地理位置、容量等条件返回最优节点,用户再与该节点建立 WebSocket 长连接(4)。 服务发现 (Zookeeper) 用户 A 登录 负载均衡 API 服务器 Chat 服务器 1 Chat 服务器 2 Chat 服务器 2 被选中 1 登录 2 转发 3 查询 4 ws 连接 返回最优 Zookeeper 按位置与容量推荐最优节点 … N 台服务器 按 diagram-design 重绘 查看原图
服务发现的主要作用是根据地理位置、服务器容量等标准,为客户端推荐最佳聊天服务器。
使用 Apache Zookeeper 根据地理位置和服务器容量等标准分配聊天服务器。
确保高效的负载分配并最小化延迟。
消息流程
一对一聊天
用户 A 向聊天服务器 1 发送消息。
聊天服务器 1 分配唯一消息 ID,并将消息存储到键值存储。
如果用户 B 在线,消息被转发到聊天服务器 2,后者保持持久 WebSocket 连接。
如果用户 B 离线,则发送推送通知。
群聊
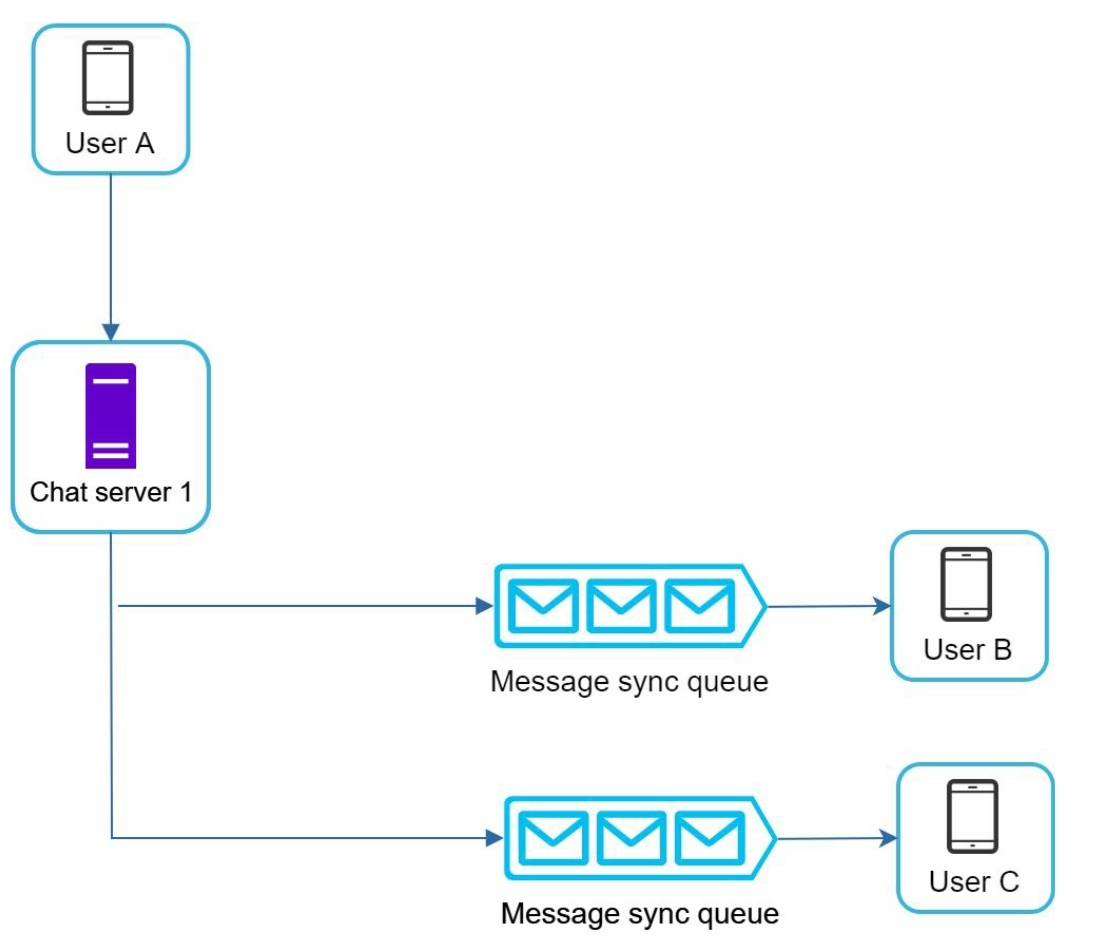
群聊消息流程 群消息在服务端被复制到每个收件人的收件箱(消息同步队列)。用户 A 发出的消息先到 Chat 服务器 1,再分别写入 B、C 的同步队列,各自从队列里拉取。这样同步简单,但群越大写扩散代价越高。 用户 A 发消息 Chat 服务器 1 复制到收件箱 消息同步队列 用户 B 收件箱 消息同步队列 用户 C 收件箱 用户 B 用户 C 消息 拉取 拉取 消息复制到每个收件人的收件箱 按 diagram-design 重绘 查看原图
消息会复制到群组中每个接收者的个人收件箱。
这简化了同步,但在群组较大时成本会变高。
在接收端,一个接收者可以收到来自多个用户的消息。每个接收者都有一个收件箱(消息同步队列),其中包含来自不同发送者的消息。
消息同步
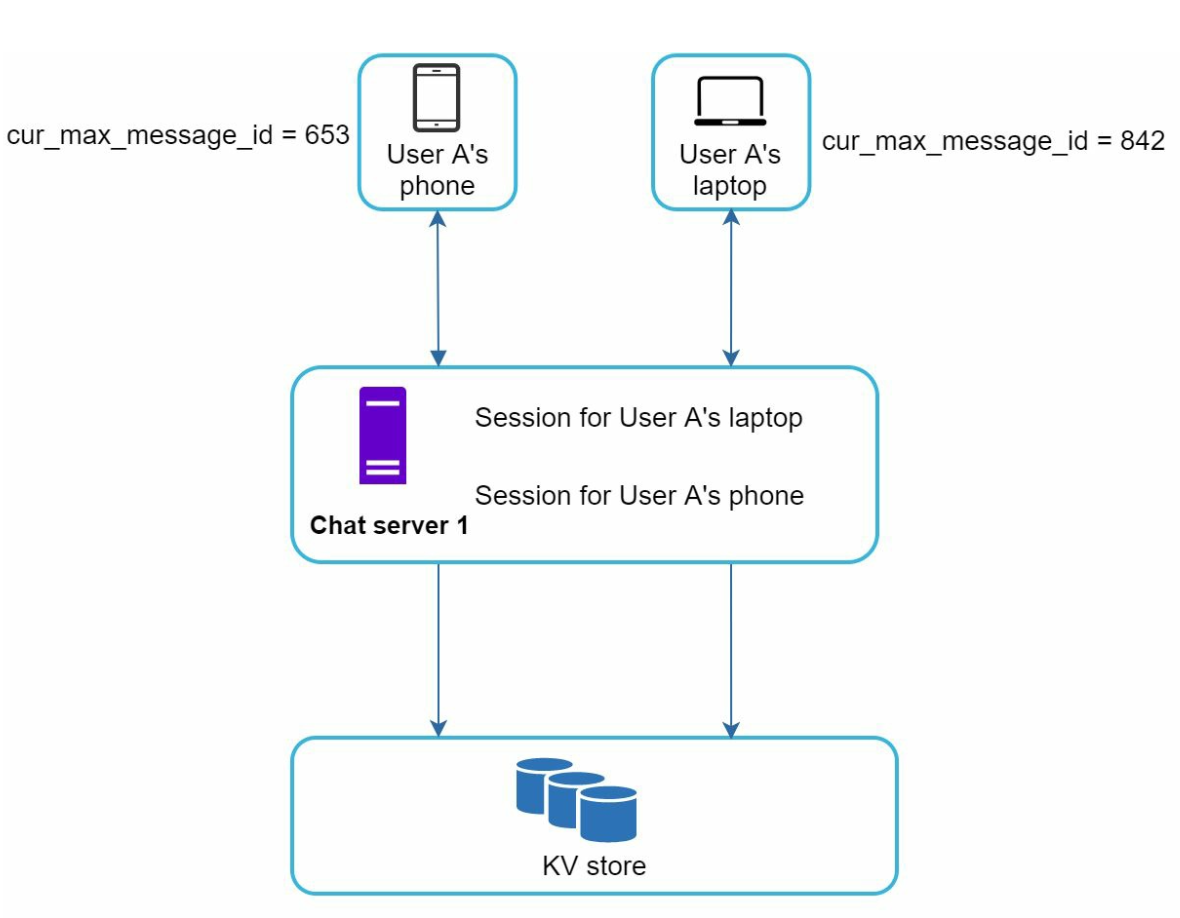
许多用户拥有多个设备。我们需要在多个设备之间同步消息。
每个设备维护一个名为 cur_max_message_id 的变量,用于记录设备上最新的消息 ID。
满足以下两个条件的消息被视为新消息:
多设备消息同步 同一个用户在手机和笔记本上各有一条会话,每台设备记录自己的 cur_max_message_id。Chat 服务器把「收件人是当前用户」且「消息 ID 大于该设备的 cur_max_message_id」的消息视为新消息,据此补齐各设备缺失的部分。 A 的手机 cur_max_message_id=653 A 的笔记本 cur_max_message_id=842 Chat 服务器 1 维护会话与设备 KV 存储 聊天记录 推送新消息 推送新消息 读取消息 每台设备各自记录已读到的最大消息 ID 新消息 = 收件人是我 且 ID 超过设备游标 按 diagram-design 重绘 查看原图
接收者 ID 等于当前登录用户 ID。
键值存储中的消息 ID 大于 cur_max_message_id
在线状态
心跳机制:
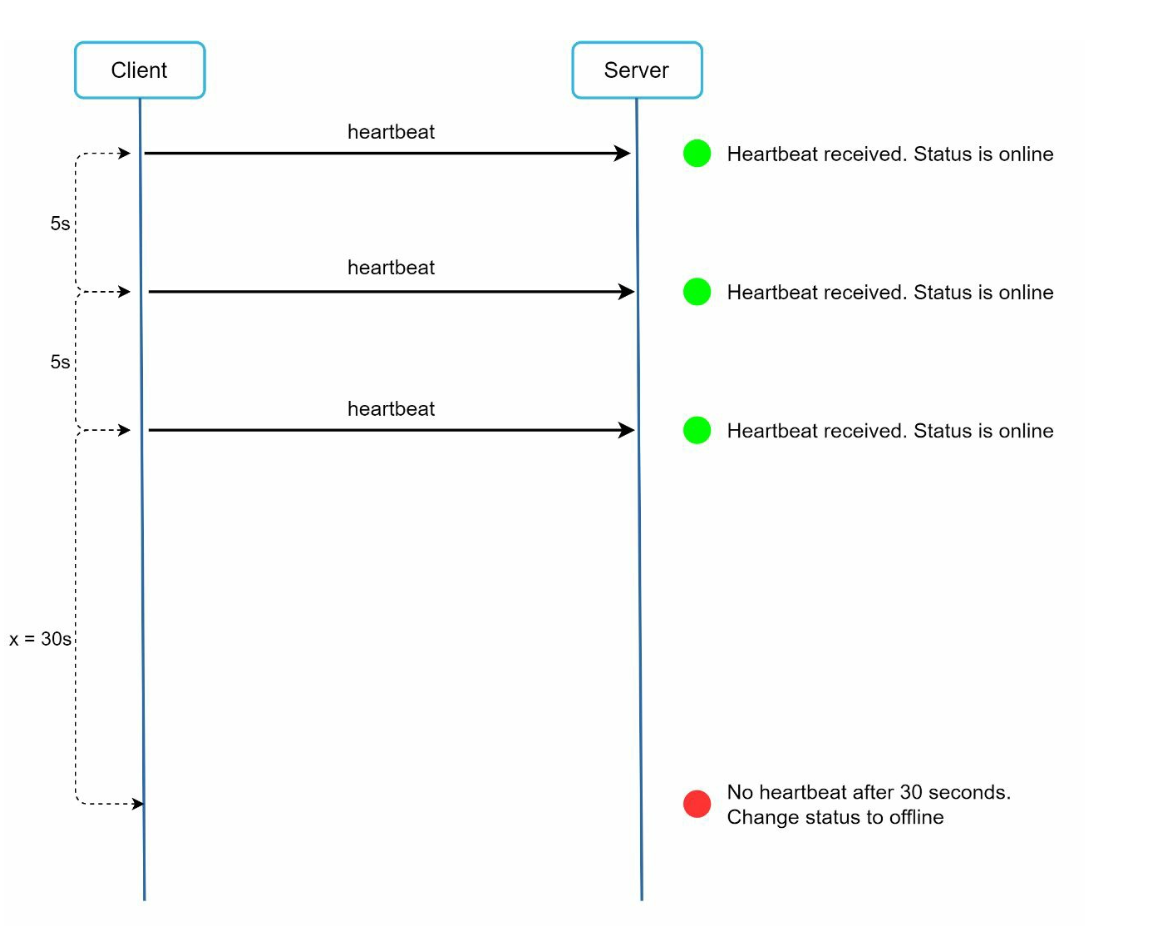
心跳机制 客户端周期性给在线状态服务器发心跳,证明自己还在线。只要持续收到心跳就维持在线;连续 30 秒收不到心跳,就把该用户标记为离线。 客户端 每 5s 心跳 在线状态服务器 维护在线状态 心跳 心跳 心跳中断 连续 30s 未收到心跳 → 标记离线 按 diagram-design 重绘 查看原图
客户端定期向在线状态服务器发送心跳,表明其在线。
如果在阈值(例如 x = 30)内没有收到心跳,则将用户标记为离线。
扇出模型:
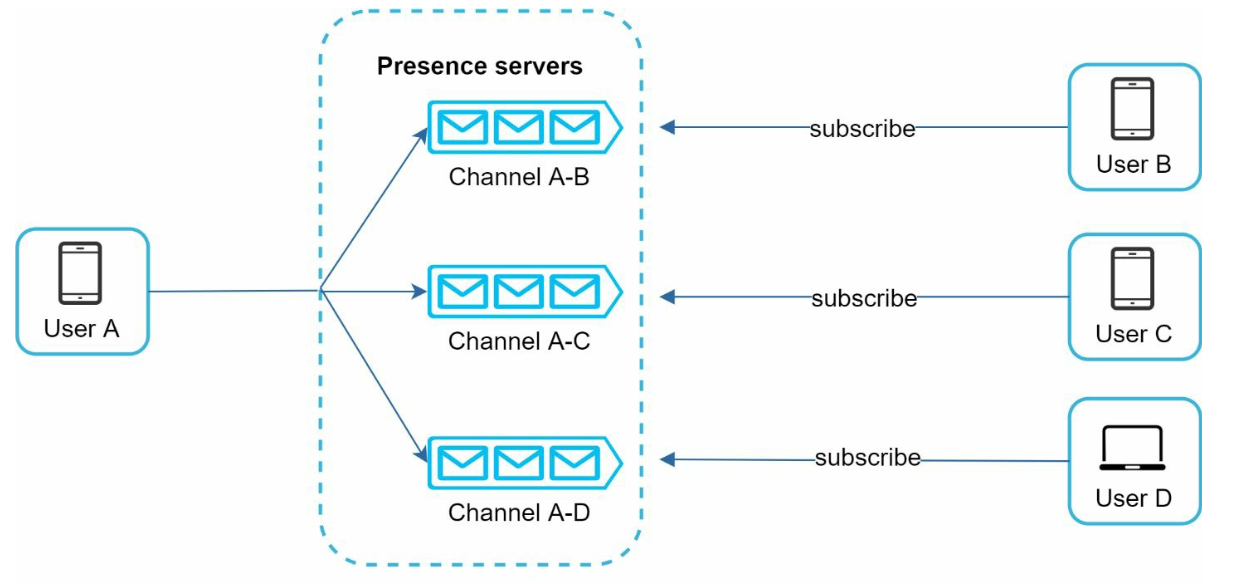
在线状态扩散 用发布订阅扩散在线状态:每对好友维护一个频道。用户 A 状态变化时,把事件发布到 A-B、A-C、A-D 三个频道,分别由 B、C、D 订阅,从而收到 A 的在线更新。这套设计适合小规模好友关系。 在线状态服务器 用户 A 发布状态 频道 A-B 订阅频道 频道 A-C 频道 A-D 用户 B 用户 C 用户 D 发布 发布 发布 订阅 订阅 订阅 A 发布状态到 3 个好友频道 按 diagram-design 重绘 查看原图
在线状态更新通过发布/订阅模型推送给好友,其中每对好友维护一个频道。
当用户 A 的在线状态变化时,事件会发布到三个频道:A-B、A-C 和 A-D。
这三个频道分别由用户 B、C 和 D 订阅,从而获得在线状态更新。
上述设计对小规模用户群有效。
其他考虑因素
可扩展性
水平扩展: 随着用户数增加而增加服务器。负载均衡: 将流量均匀分布到各服务器。缓存: 减少数据库负载并改善延迟。
错误处理
重试机制: 通过重试和排队处理消息投递失败。服务器故障: 在发生故障时使用服务发现分配新服务器。
未来扩展
媒体支持: 增加对照片和视频的处理,包括压缩和云存储。端到端加密: 确保消息隐私。客户端缓存: 减少数据传输以提升性能。改善加载时间: 使用地理上分布式的缓存网络。
第 13 章:设计搜索自动补全系统
引言
自动补全,又称输入提示或增量搜索,在用户在搜索框中输入时实时提供建议。系统必须基于历史查询数据高效地返回前 k 个相关且流行的建议。
核心特性
最多显示 5 条自动补全结果 。
基于查询热度 (频次)。
仅支持小写英文字母 。
响应时间快(<100 毫秒)且可扩展。
第 1 步:理解问题
需求
实时建议: 在用户输入时显示相关匹配项。前 k 个结果: 返回按热度排序的最多 5 条结果。可扩展性: 支持 1000 万 DAU ,峰值 QPS 为 48,000 。高可用性: 处理故障而不造成系统停机。数据增长: 支持每天新增查询数据 0.4 GB 的存储增长。
第 2 步:高层设计
在高层设计上,系统分为两个服务:
数据采集服务:
收集用户查询并实时聚合以进行频次分析。
对于大规模数据集,实时处理并不现实;不过,它是一个很好的起点
查询服务: 根据用户输入提供前 k 个建议。
数据采集服务
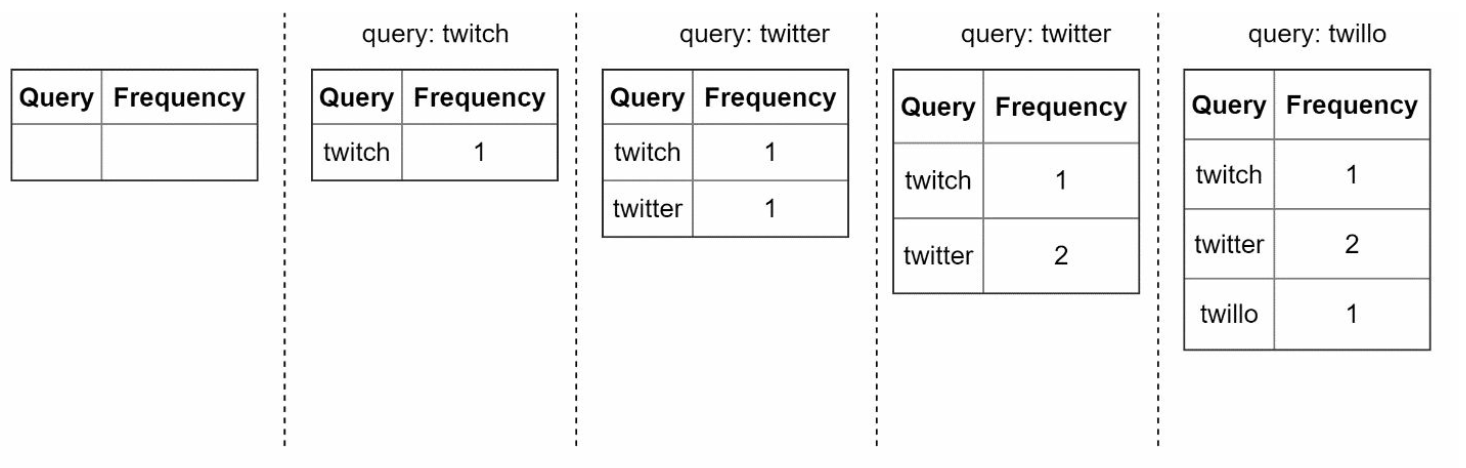
数据采集:频次表随查询累积 数据采集服务把用户的每一次查询累加进频次表:同样的查询再加一次,就把对应词频 +1;新出现的查询则新增一行。这张不断增长的频次表,正是每周离线重建 trie 的输入。 query: — 空频次表 query: twitch twitch:1 query: twitter twitch:1, twitter:1 query: twitter twitch:1, twitter:2 query: twillo twitch:1, twitter:2, twillo:1 每来一条查询就累加词频 时间 → 频次表持续增长,是每周重建 trie 的输入 按 diagram-design 重绘 查看原图
从分析日志中聚合查询数据并更新频次表。
每周处理历史数据以构建 trie (前缀树)。
查询服务
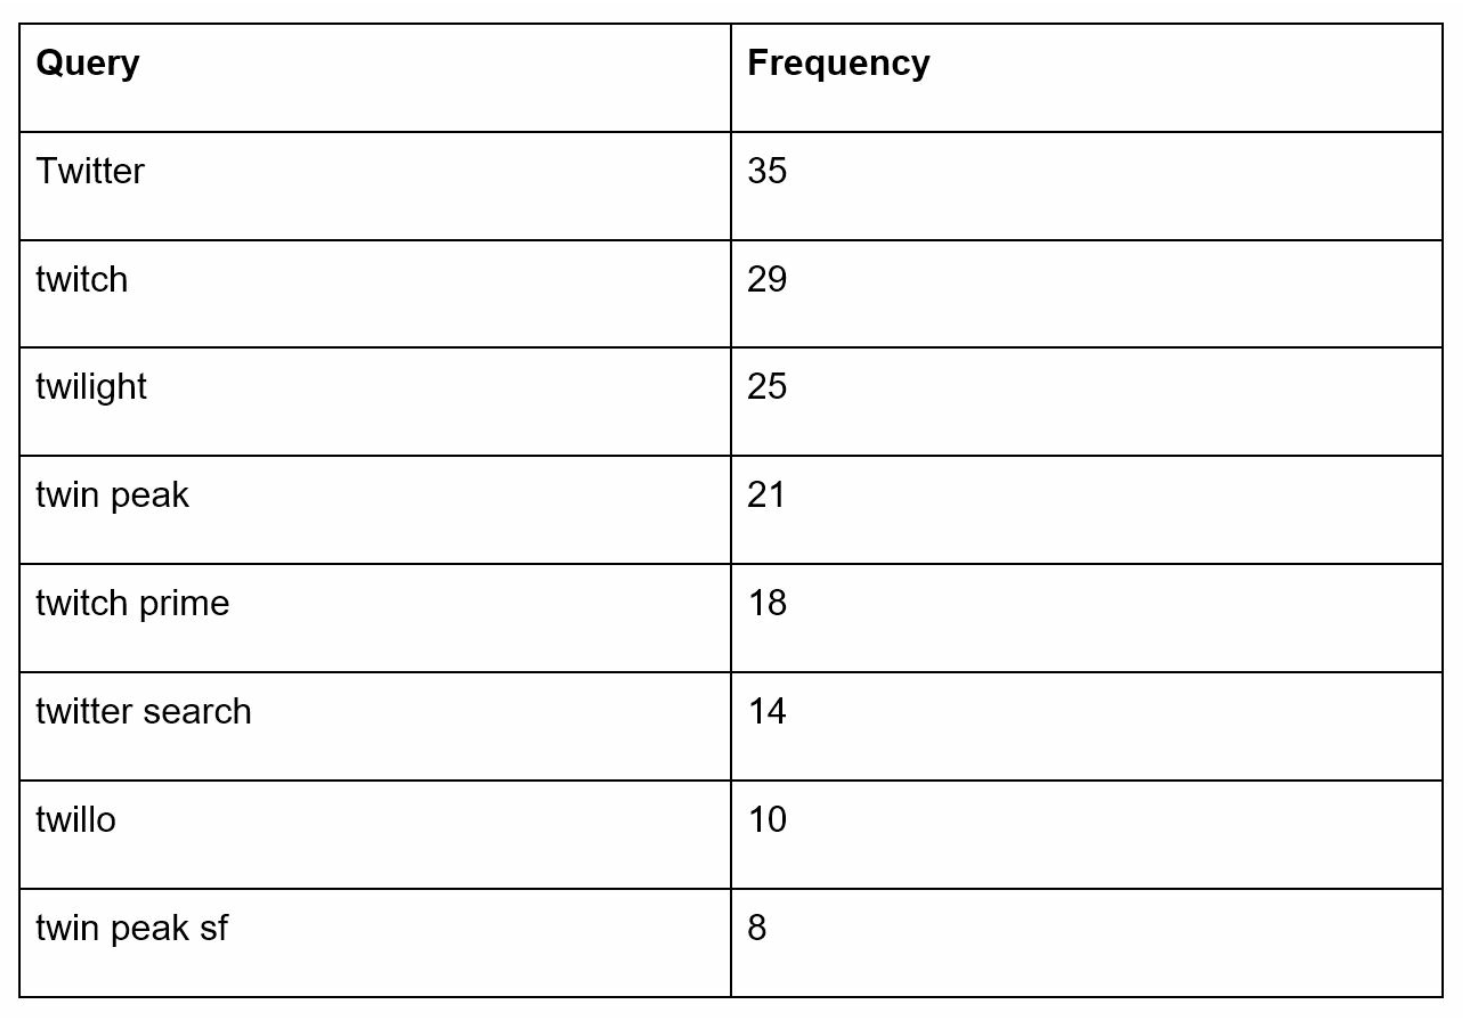
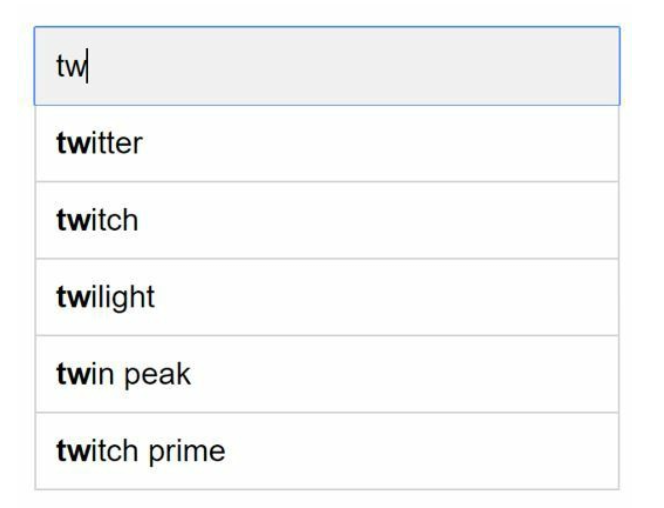
频次表:查询 → 热度 频次表记录每条查询字符串被搜索了多少次,按热度降序排列:Twitter 35 次、twitch 29 次、twilight 25 次……查询服务就是拿这张表(以及由它构建的 trie)来回答 top-k 补全的。 频次表(Query → Frequency) Twitter 频次 35 twitch 频次 29 twilight 频次 25 twin peak 频次 21 twitch prime 频次 18 twitter search 频次 14 twillo 频次 10 twin peak sf 频次 8 按热度降序:越热的查询排在越前 按 diagram-design 重绘 查看原图 输入 tw 弹出 top-5 建议 用户在搜索框里敲下「tw」,系统按查询热度(频次)实时返回最热门的 5 条补全建议:twitter、twitch、twilight、twin peak、twitch prime。这些候选都来自查询服务里预先建好的频次表与 trie,因此响应可以压到 100 毫秒以内。 下拉建议 top 5 搜索框 输入 tw twitter 频次 35 twitch 频次 29 twilight 频次 25 twin peak 频次 21 twitch prime 频次 18 实时建议 按查询热度排序,最多返回 5 条 按 diagram-design 重绘 查看原图
使用数据采集服务生成的频次表。
处理用户输入,并使用 Trie 从频次表中检索前 k 个建议。
通过缓存和高效数据结构优化快速查询。
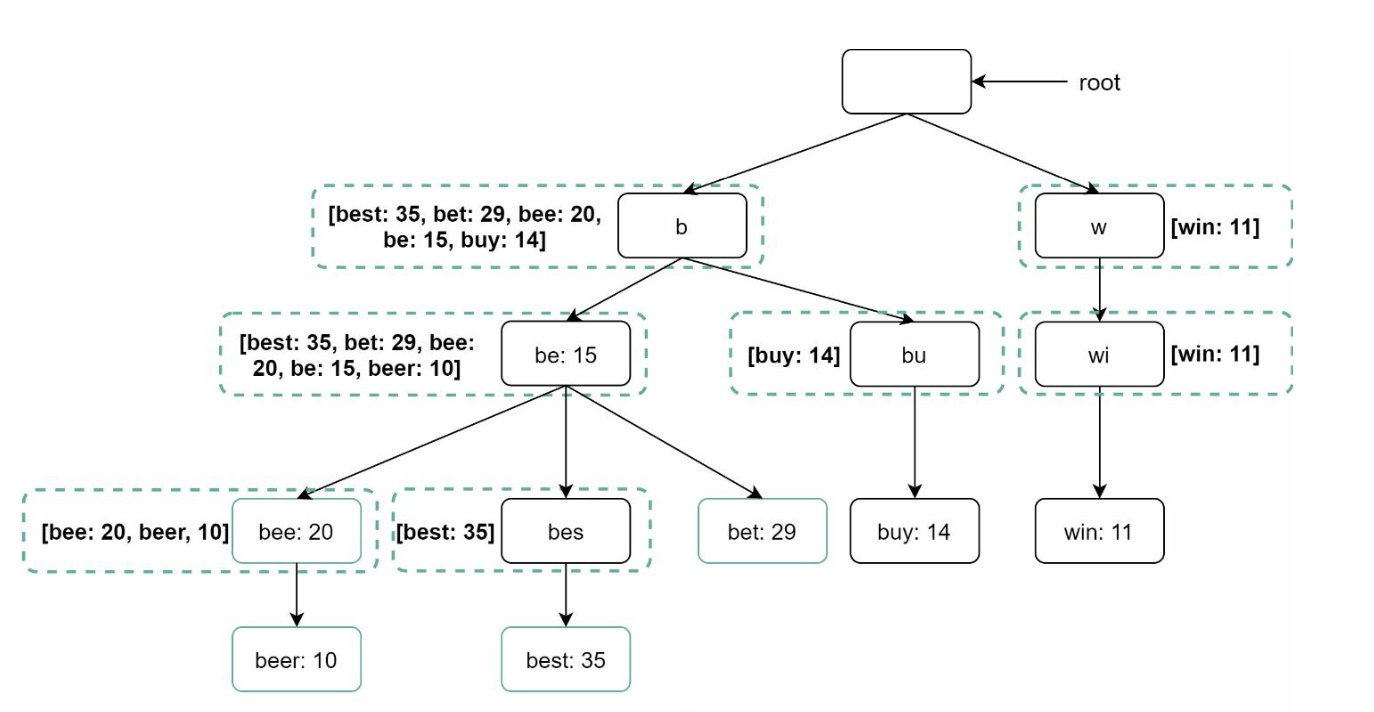
例如,当用户在搜索框中输入“tw”时,将显示以下搜索最多的前 5 条查询。
第 3 步:深入设计
Trie 数据结构
trie 是一种树形数据结构,用于高效地存储和检索查询字符串。
核心特性
紧凑存储: 按层级表示前缀以减少冗余。
频次信息: 在每个节点存储查询热度。
获取搜索最多的前 k 个查询的步骤
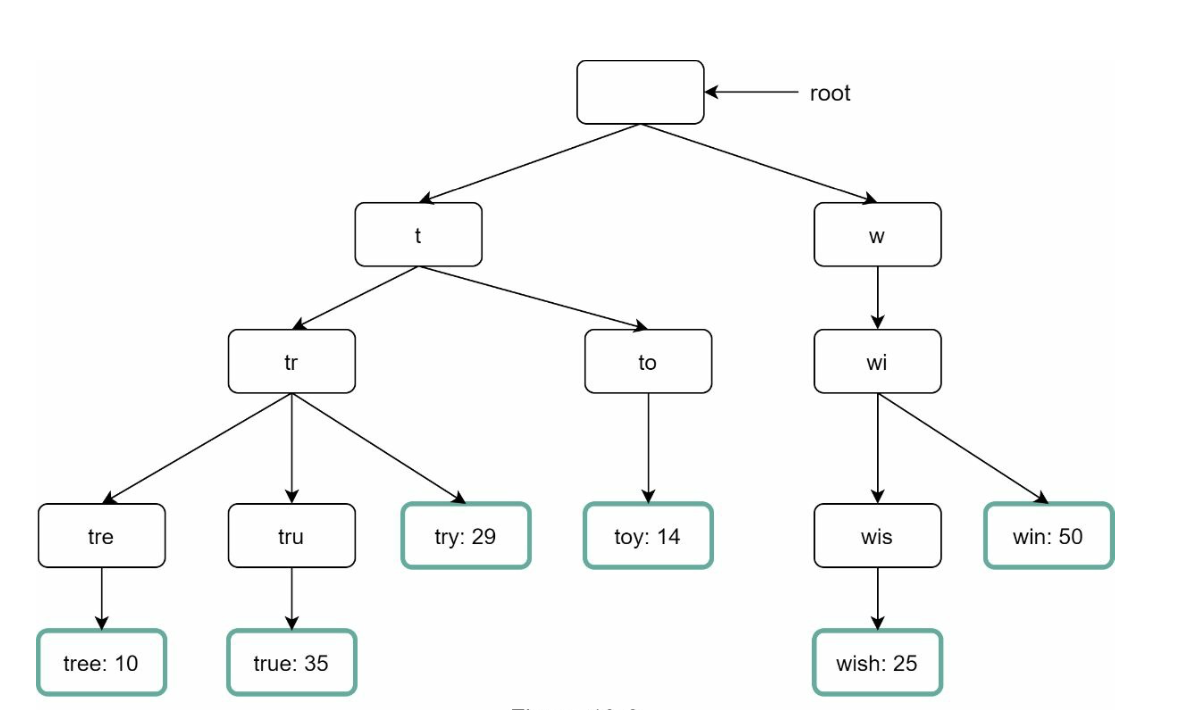
Trie 结构:取 top-k 的三步 trie 是一棵前缀树,边上的字符拼出查询串,每个叶子节点带一个频次(如 try: 29、win: 50)。取 top-k 分三步:先按输入找到前缀节点,再遍历该节点的子树收集所有合法补全,最后按频次排序取前 k 个。 root t w tr to wi tre tru try 频次 29 toy 频次 14 wis win 频次 50 tree 频次 10 true 频次 35 wish 频次 25 ① 找前缀节点 → ② 遍历子树收集补全 → ③ 按频次排序取 top-k 深色叶子 = 一个完整查询,数字为它的热度 按 diagram-design 重绘 查看原图
查找前缀
从前缀节点遍历子树,获取所有有效子节点
对子节点排序并获取前 k 个
优化:
Trie 操作
创建:
使用聚合的查询数据每周构建。
数据来源是分析日志/数据库。
更新: 很少实时更新;每周更新会替换旧数据。
删除:
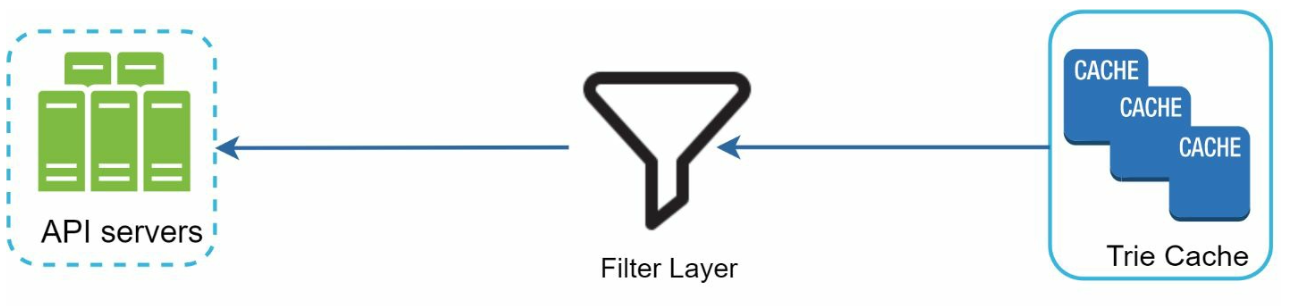
删除:经过滤层移除不良建议 候选建议从 Trie 缓存取出后,先经过一层过滤层:它按可插拔的规则(例如仇恨言论、敏感词)拦掉不该出现的建议,再把干净的结果交给 API 服务器返回。被判定为不良的条目会异步从数据库中物理删除,不阻塞在线查询。 API 服务器 返回建议 过滤层 移除不良建议 Trie 缓存 候选建议 候选 过滤后 过滤规则可插拔;不良建议异步物理删除 过滤层让删除策略与查询逻辑解耦 按 diagram-design 重绘 查看原图
过滤器会删除不需要或有害的建议(例如仇恨言论)。
拥有过滤层让我们能够根据不同的过滤规则灵活删除结果。
不需要的建议会异步地从数据库中物理删除。
查询处理流程
前缀搜索:
找到与用户输入对应的前缀节点。
遍历子树以收集有效建议。
前 k 排序:
在每个节点缓存前 k 个建议,以尽量减少排序开销。
响应构造:
优化
在每个节点缓存:
限制前缀长度:
将前缀长度限制为较小值(例如 50 个字符)以加快查询速度。
AJAX 请求:
浏览器缓存:
数据采集流水线
在高层设计中,每当用户输入搜索查询时,数据都会实时更新。这种方法并不现实。
用户每天可能输入数十亿条查询。每次查询都更新 trie 是不可行的。
一旦 trie 构建完成,热门建议不会有太大变化。
更新后的设计
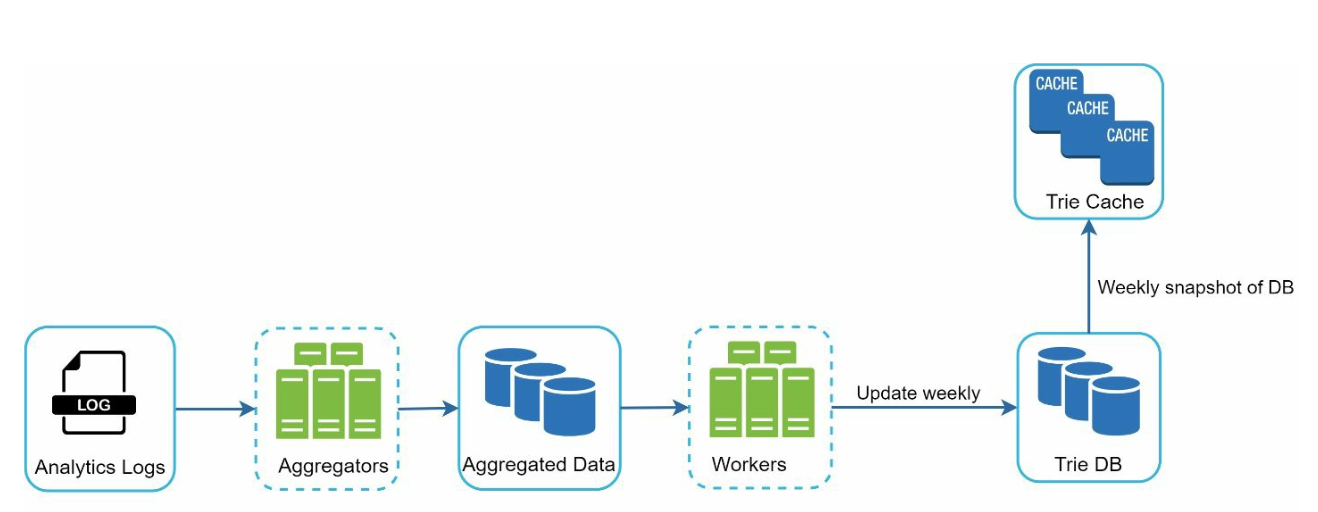
数据采集流水线 实时逐条更新 trie 不现实,于是改成离线流水线:分析日志追加写入原始查询;聚合器把日志汇总成频次表;工作线程异步按频次表重建 trie 并落盘到 Trie DB;每周再从 Trie DB 打一份快照灌进内存里的 Trie 缓存,供在线查询快速读取。 分析日志 原始查询 聚合器 日志 → 频次表 聚合数据 频次表 工作线程 异步重建 trie Trie DB 持久化 Trie 缓存 内存加速 采集 聚合 产出 每周更新 每周快照 离线管道:日志按周聚合、异步重建 trie Trie 缓存在内存里服务在线查询;Trie DB 负责持久化 按 diagram-design 重绘 查看原图
分析日志:
将原始查询数据存储为日志,用于每周聚合。
日志只会追加写入,且不建立索引
聚合器:
将日志处理为适合构建 trie 的频次表。
对于 Twitter 等实时应用,以较短的时间间隔聚合数据。
在其他情况下,不那么频繁地聚合数据,例如每周一次就足够了。
工作程序:
异步服务器重建 trie 并将其存储到持久化存储中。
存储选项:
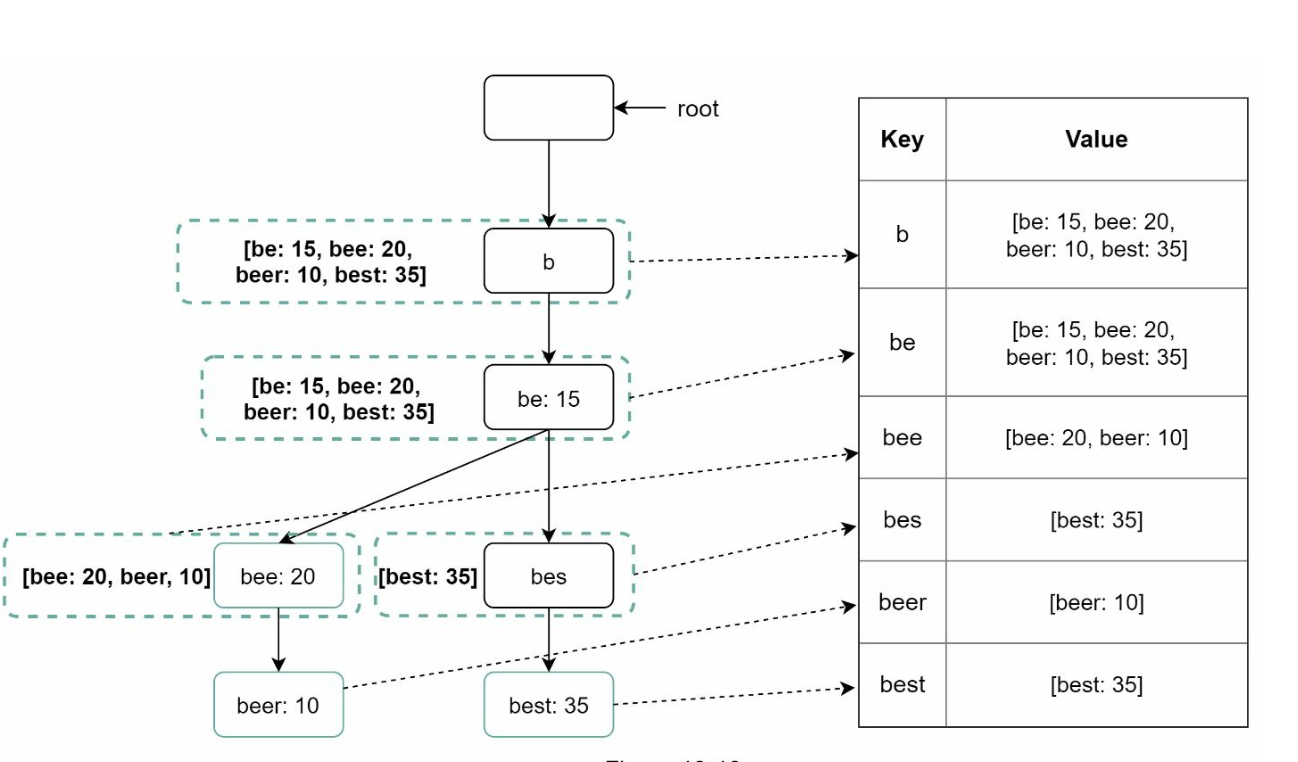
Trie 缓存 :Trie 缓存是一种分布式缓存系统,将 trie 保存在内存中以加快读取速度。Trie 数据库
文档存储(如 MongoDB) :由于每周构建新的 trie,我们可以定期对其拍摄快照,序列化后存储到 MongoDB 等数据库中键值存储:
可扩展性
分片:
根据前缀范围(例如 a-m、n-z)将 trie 节点分布到多个服务器。
在前缀内部进一步分片,以平衡不均匀的分布(例如 aa-ag、ah-an)。
负载均衡:
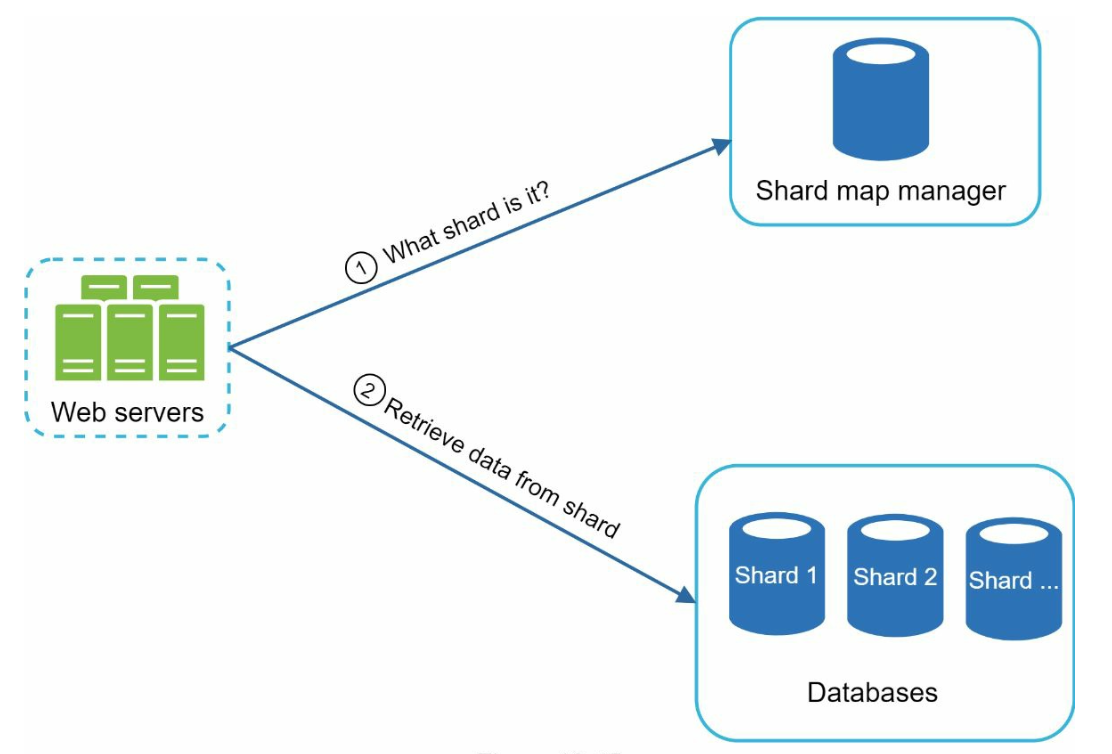
分片:前缀范围路由到不同分片 trie 按前缀范围切开分散到多台服务器(例如 a–m、n–z),前缀分布不均时再在内部细分(例如 aa–ag、ah–an)。Web 服务器先问分片映射管理器「这个前缀属于哪个分片」,再直接去对应的数据库分片取数据。 数据库 Web 服务器 查询前缀 分片映射管理器 前缀 → 分片 分片 1 分片 2 分片 n ① 是哪个分片? ② 从分片取数据 ① 先问分片映射管理器 ② 再去对应分片取数据 前缀分布不均时,可在分片内继续细分 按 diagram-design 重绘 查看原图
第 4 步:高级特性
多语言支持
Unicode 字符: 使用 Unicode 支持非英语语言。按国家/地区构建不同的 trie: 为不同国家或地区构建单独的 trie。
热门查询
通过动态更新 trie 节点或对近期查询赋予更高权重来处理实时事件。
第 14 章:设计 YouTube
引言
YouTube 是一个大规模视频流媒体平台,支持视频上传、播放和多种互动。本章重点设计一个可扩展的视频流媒体系统,具备以下核心特性:
快速视频上传 流畅的视频播放 切换视频画质的能力 低基础设施成本 高可用性与可靠性
关键统计数据(2020)
月活跃用户 20 亿 每天观看 50 亿个视频 YouTube 占移动互联网流量的 37% 支持 80 种语言
2019 年 广告收入 151 亿美元
步骤 1:理解问题与范围
核心功能
上传视频
观看视频
支持的平台
假设
日活跃用户(DAU): 500 万平均视频大小: 300 MB上传限制: 每个视频最大 1 GB每日存储需求: 150 TBCDN 内容分发网络成本: 500 万 * 5 个视频 * 0.3GB * 0.02 美元 = 150,000 美元/天(使用 Amazon CloudFront)
步骤 2:高层设计
组件
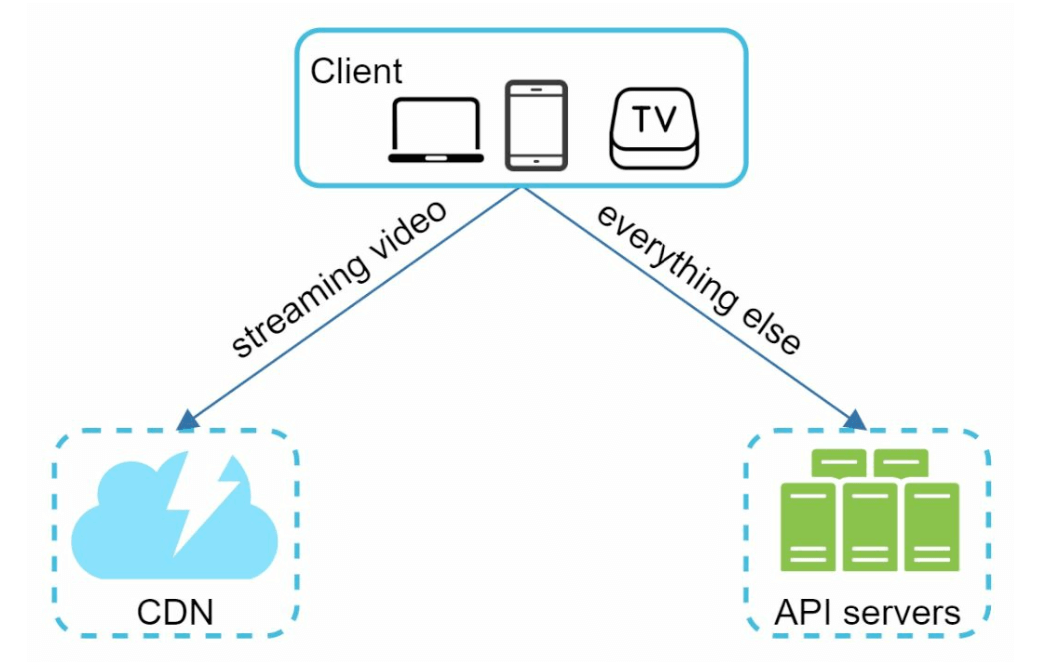
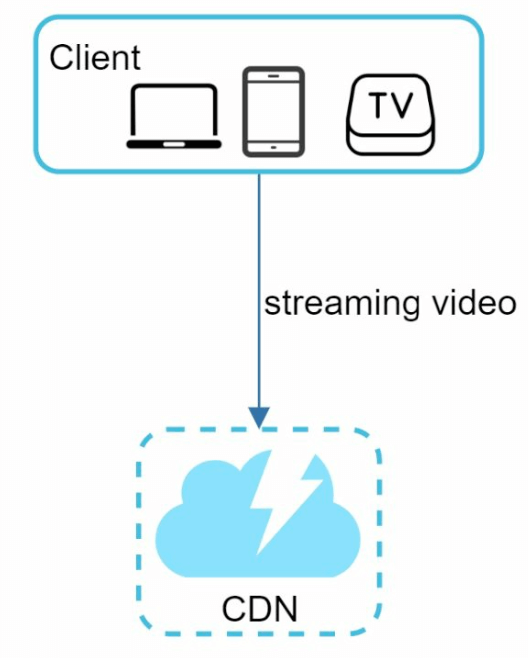
高层设计 客户端(手机、电脑、TV)连到两类后端:视频播放走 CDN,由边缘节点就近分发;上传、改元数据等其余交互走 API 服务器。CDN 只负责流媒体,API 服务器不碰视频流。 客户端 手机 · 电脑 · TV CDN API 服务器 流媒体 其他请求 视频走 CDN,其余交互走 API 按 diagram-design 重绘 查看原图
客户端: 智能手机、计算机和电视等设备。CDN(内容分发网络): 存储并流式传输视频。API 服务器: 处理除视频流播放之外的所有用户交互(例如上传、元数据更新)。元数据数据库: 存储视频元数据(例如标题、描述、大小)。原始存储: 用于存储上传视频的 Blob 存储。转码服务器: 将视频转换为多种分辨率和格式。转码后存储: 用于存储转码后视频的 Blob 存储。
核心工作流
1. 视频上传流程
并行流程:
将视频上传到原始存储。
更新数据库中的视频元数据。
视频上传(步骤):
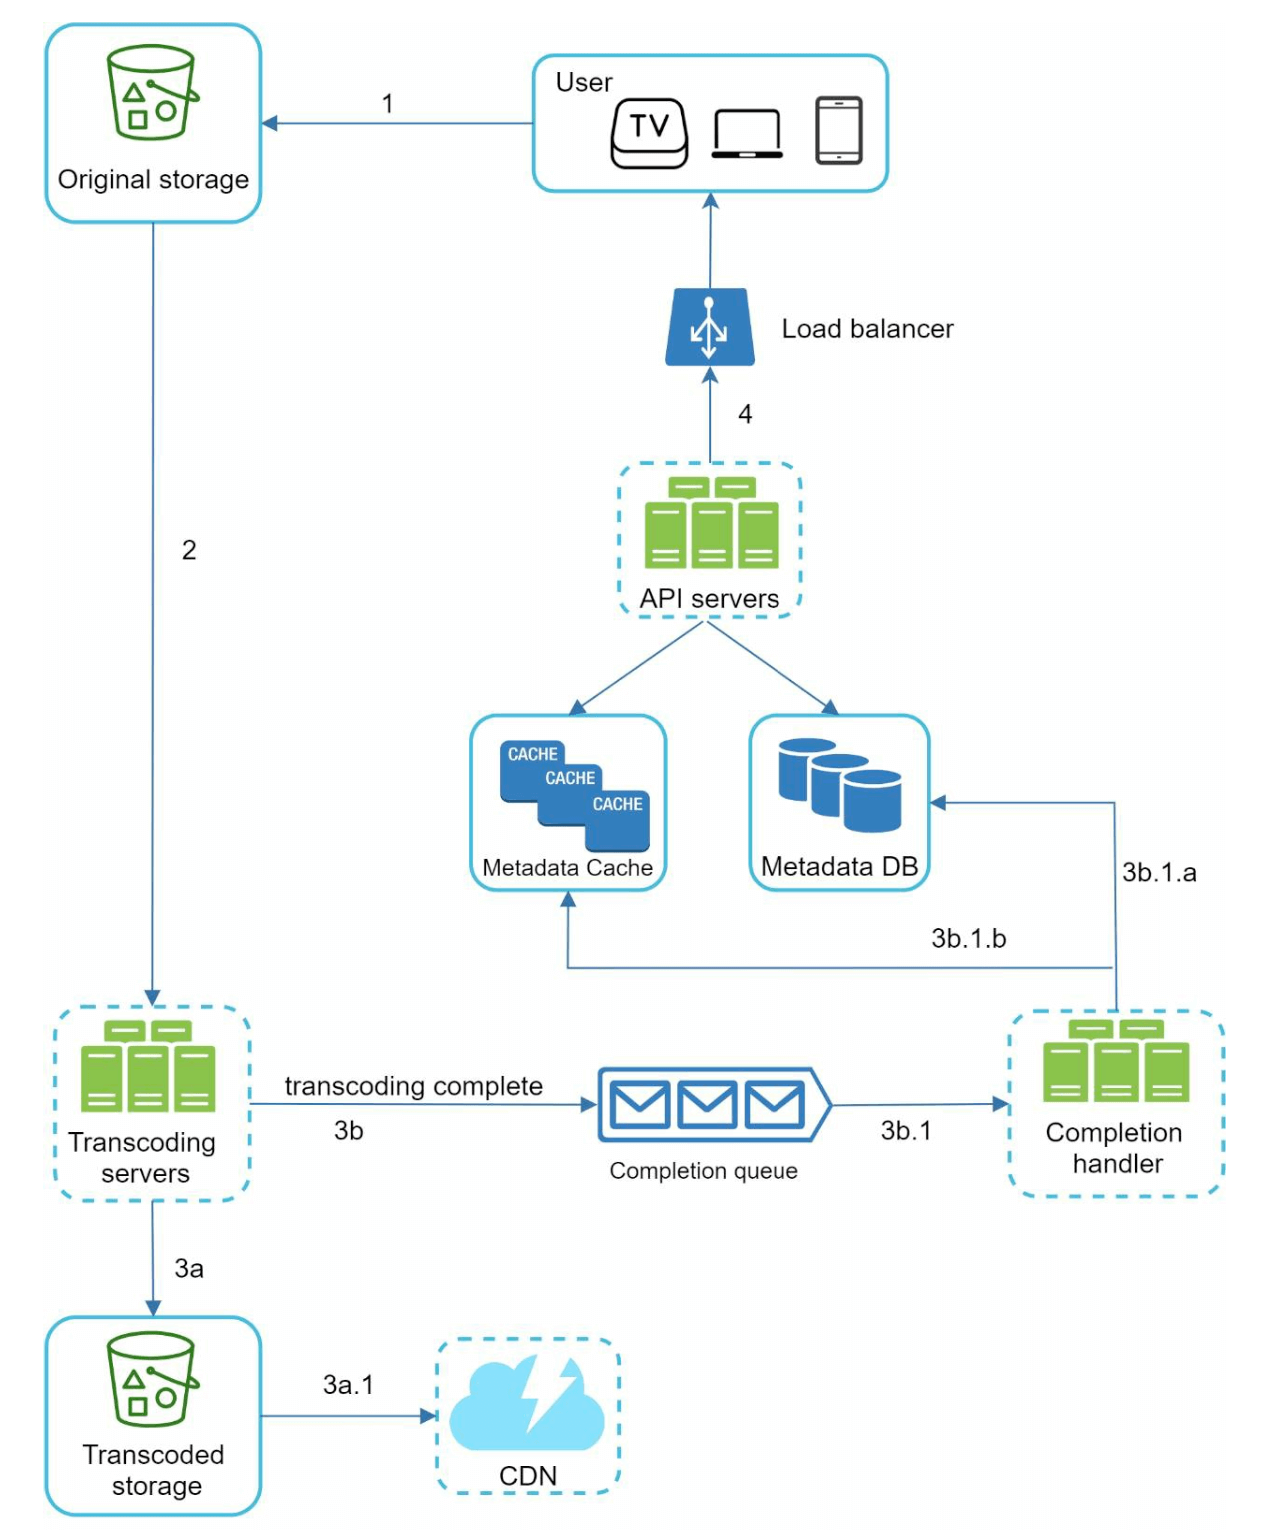
视频上传流程 上传与元数据更新并行:视频 [1] 直传原始存储,[2] 由转码服务器转成多种格式,完成后分两路——[3a] 转码结果写入转码后存储并 [3a.1] 分发到 CDN;[3b] 完成事件进完成队列,[3b.1] 完成处理器更新元数据缓存与 DB 并通知用户。另一路元数据请求经 [4] 负载均衡到 API 服务器读写元数据。 用户 上传视频 原始存储 负载均衡 转码服务器 API 服务器 完成队列 转码后存储 元数据缓存 元数据库 完成处理器 CDN 1 上传 4 元数据 2 转码 3a 3b 完成 3b.1 3a.1 4 分发 更新缓存 更新 DB 上传与元数据更新并行进行 完成处理器更新元数据并通知用户 按 diagram-design 重绘 查看原图
[1] 视频被上传到 Blob 存储。
[2] 转码服务器将视频转换为多种格式。
[3] 转码完成后,以下两个步骤并行执行。
[3a] 转码后的视频被发送到转码后存储。
[3b] 转码完成事件被放入完成队列。
[3a.1] 视频被分发到 CDN。
[3b.1] 完成处理器更新元数据并通知用户。
元数据上传(步骤):
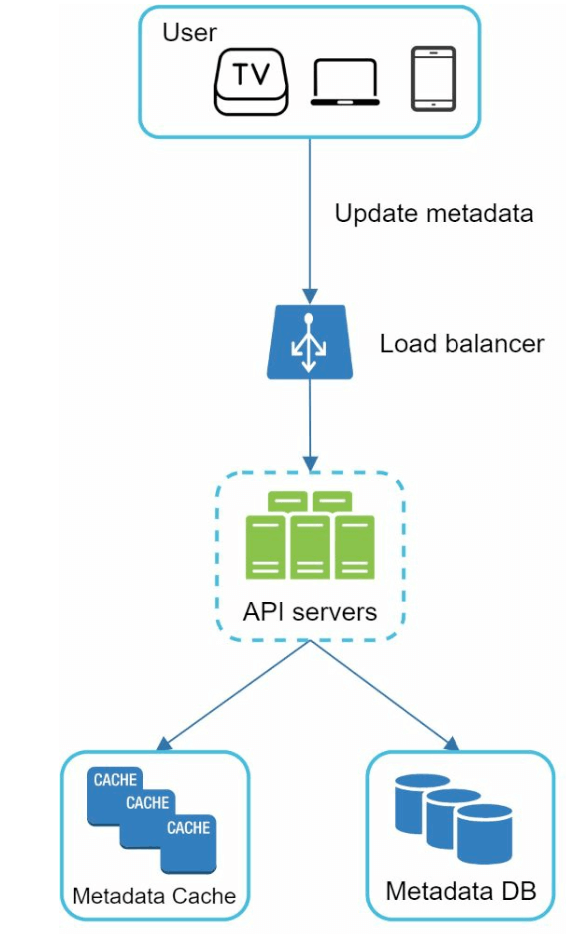
元数据上传 客户端并行提交元数据更新请求(文件名、大小、格式等):请求经负载均衡分给 API 服务器,API 服务器再并行写入元数据缓存与元数据库。 用户 更新元数据 负载均衡 API 服务器 元数据缓存 元数据库 更新请求 分发 写缓存 写 DB API 服务器并行写缓存与 DB 按 diagram-design 重绘 查看原图
客户端并行发送一个请求来更新视频元数据
请求中包含视频元数据,例如文件名、大小、格式等。
2. 视频流播放流程
视频播放流程 播放请求直达 CDN:视频从 CDN 的边缘服务器直接流式传输,尽量缩短延迟。常用协议有 MPEG-DASH、Apple HLS 与 Adobe HDS,不同协议支持的编码与播放器各异。 客户端 手机 · 电脑 · TV CDN 流媒体 CDN 边缘节点就近分发,降低延迟 协议:MPEG-DASH / HLS / HDS 按 diagram-design 重绘 查看原图
视频直接通过边缘服务器从 CDN 传输,以降低延迟。
一些常见的流媒体协议包括 MPEG_DASH、Apple HLS、Adobe HDS。
不同的流媒体协议支持不同的视频编码和播放器。
步骤 3:设计深入探讨
视频转码
重要性
原始视频占用大量存储空间;转码可以减少存储空间。
确保跨设备和浏览器的兼容性。
根据网络状况调整视频画质。
组件
容器: 封装视频、音频和元数据(例如 MP4、AVI)。编解码器: 压缩和解压缩算法(例如 H.264、VP9)。
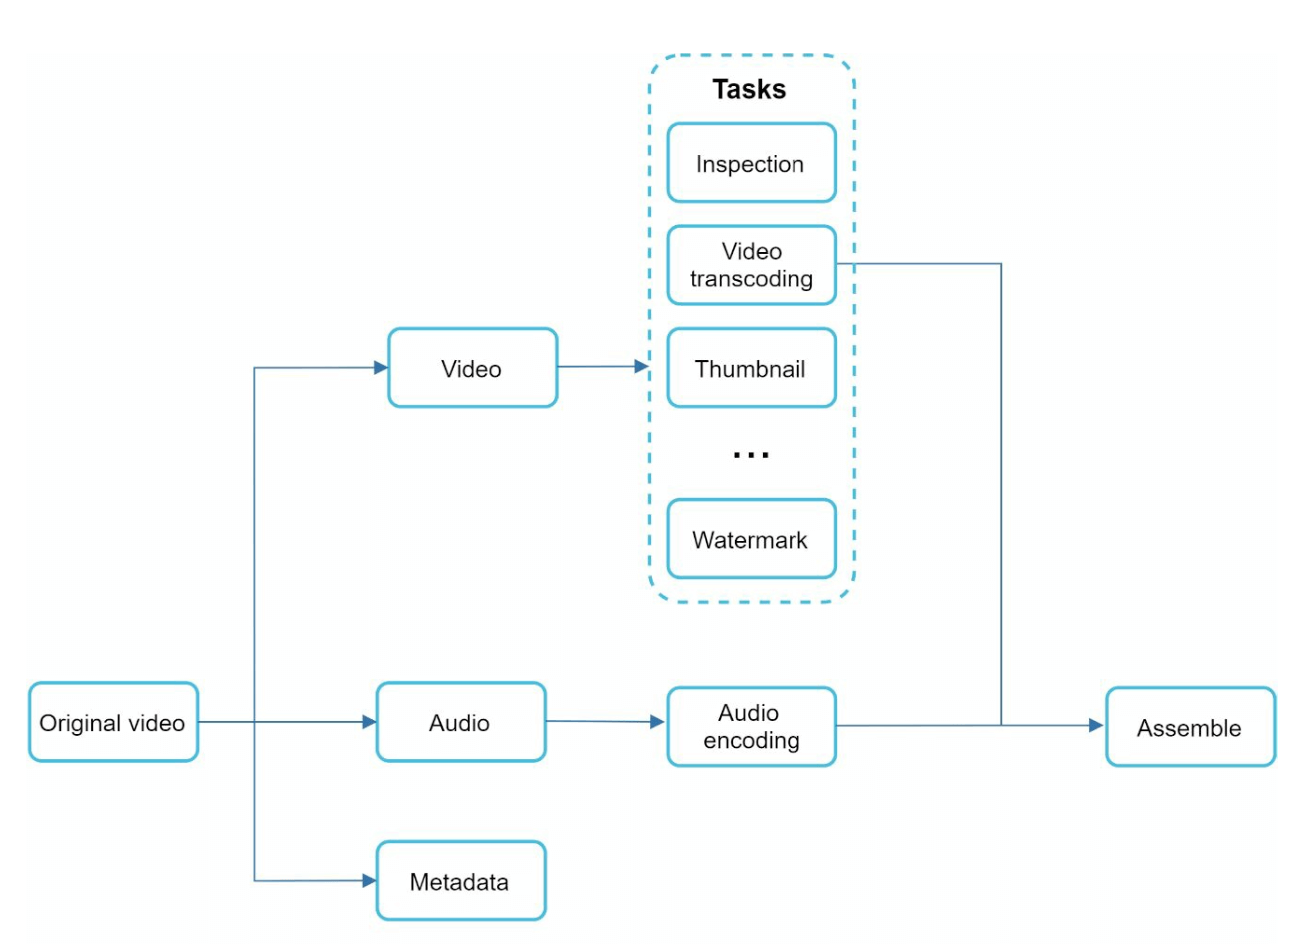
有向无环图(DAG)模型
DAG 视频转码 原始视频先拆成视频、音频、元数据三路。视频分支进入任务集:检查、视频转码、缩略图、水印等任务并行执行;音频分支做音频编码。视频转码与音频编码的结果汇入「组装」,拼成最终文件。DAG 让各任务高度并行。 任务 原始视频 视频 音频 元数据 检查 视频转码 缩略图 音频编码 水印 组装 转码 缩略图 编码 视频 音频 原始视频拆成 视频 / 音频 / 元数据 任务:检查 / 视频转码 / 缩略图 / 音频编码 / 水印 按 diagram-design 重绘 查看原图
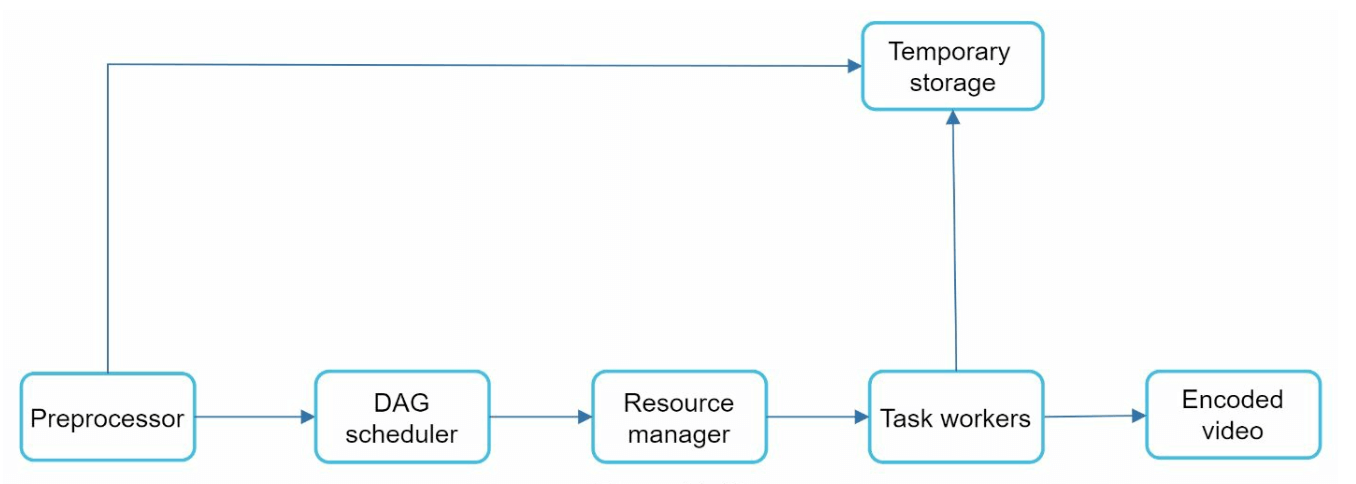
视频转码架构
视频转码架构 转码流水线:预处理器按 GOP 拆分并生成 DAG,同时把 GOP 与元数据写入临时存储以便失败重试;DAG 调度器把任务分阶段入队;资源管理器分配最优任务与 worker;任务 worker 执行转码;最终产出编码后视频。 预处理器 DAG 调度器 资源管理器 任务 worker 编码后视频 临时存储 调度 入队 分配 输出 GOP 与元数据 中间数据 预处理器按 GOP 拆分并生成 DAG,中间数据存临时存储 按 diagram-design 重绘 查看原图
预处理器: 将视频分割为更小的块(GOP 对齐)。它有 4 项职责。
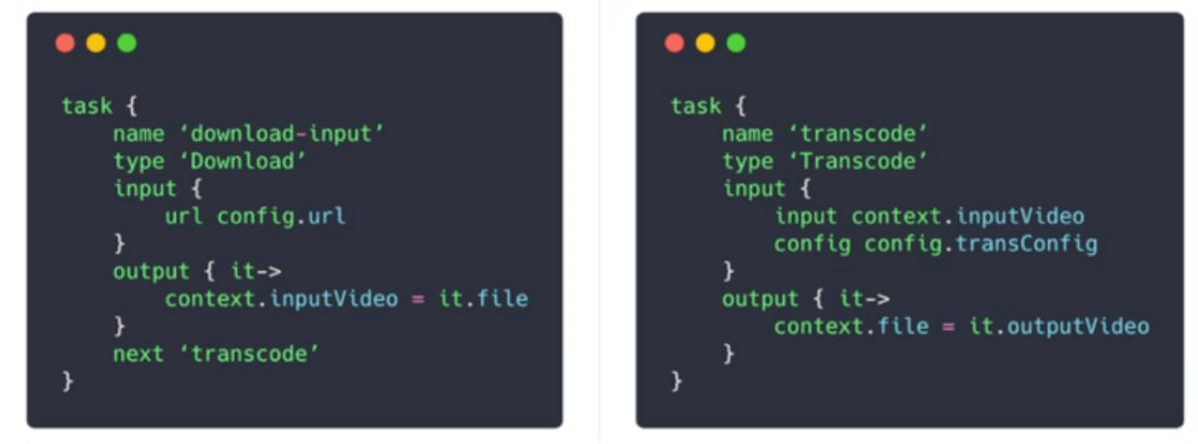
DAG 配置 DAG 由客户端程序员写的配置文件生成。每个任务声明名称、类型、输入与输出:第一个任务 download-input 从 config.url 拉取输入并写入 context;第二个任务 transcode 读取上游输出、按配置转码,再用 next 串到下一个任务。 任务配置 download-input 任务配置 transcode next type=Download,输入取 config.url 输出写入 context.inputVideo type=Transcode,读上游输出 输出写入 context.file 按 diagram-design 重绘 查看原图
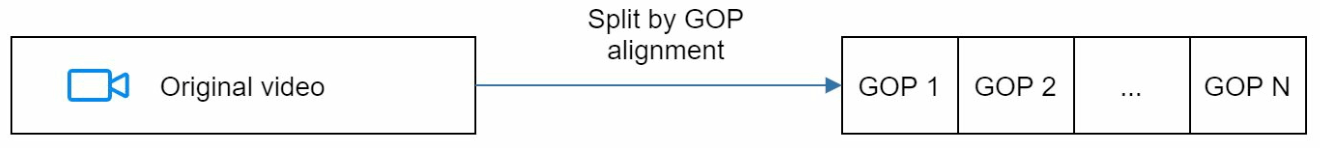
视频分割:视频流被分割或进一步分割为更小的图像组(GOP)对齐。
针对旧客户端,按 GOP 对齐分割视频。
它根据客户端程序员编写的配置文件生成 DAG。
它将 GOP 和元数据存储在临时存储中;若编码失败,系统可以使用持久化数据进行重试操作。
DAG 调度器: 将任务组织为顺序或并行阶段。
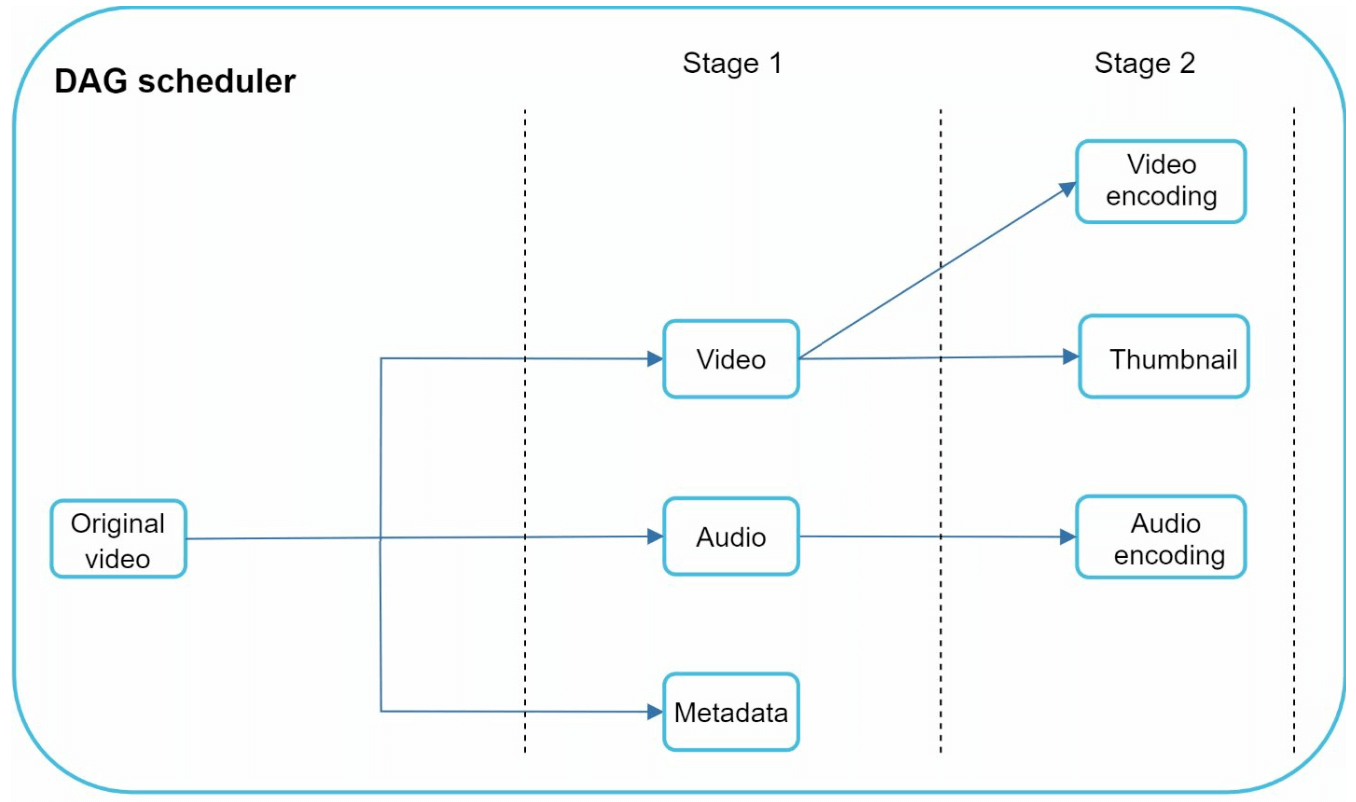
DAG 调度器 DAG 调度器把 DAG 拆成分阶段的任务并放入资源管理器的任务队列。Stage 1 拆出视频、音频、元数据;Stage 2 把视频进一步拆成视频编码与缩略图,音频走音频编码。同一阶段内的任务可并行。 DAG 调度器 原始视频 视频 音频 元数据 视频编码 缩略图 音频编码 拆分 编码 编码 Stage 1 Stage 2 按 diagram-design 重绘 查看原图
它将 DAG 图拆分为多个任务阶段,并放入资源管理器中的任务队列。
阶段 1:视频、音频和元数据。
视频文件在阶段 2 被进一步拆分为两个任务:视频编码和缩略图。
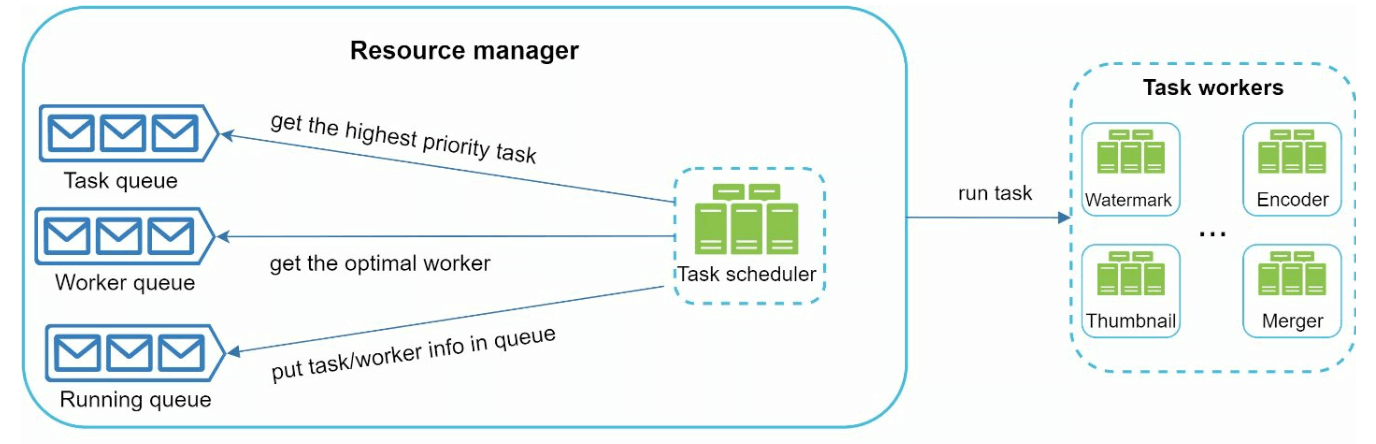
资源管理器: 负责管理资源分配的效率。它包含 3 个队列和一个任务调度器。
资源管理器 资源管理器管理资源分配效率,含三个队列与一个任务调度器:任务队列(优先级队列,待执行任务)、Worker 队列(优先级队列,worker 利用率)、运行队列(正在运行的任务与 worker)。调度器从队列取最优任务与 worker,再指令选中的 task worker 执行。 资源管理器 任务 worker 任务队列 优先级 Worker 队列 利用率 运行队列 运行中 任务调度器 水印 编码器 缩略图 合并器 取任务 取 worker 回写状态 执行 调度器从三个队列中挑选任务与 worker … 按 diagram-design 重绘 查看原图
任务队列:包含待执行任务的优先级队列。
工作器队列:包含工作器利用率信息的优先级队列。
运行队列:包含当前正在运行的任务以及执行这些任务的工作器。
任务调度器:选择最优的任务/工作器,并指示所选择的任务工作器执行作业。
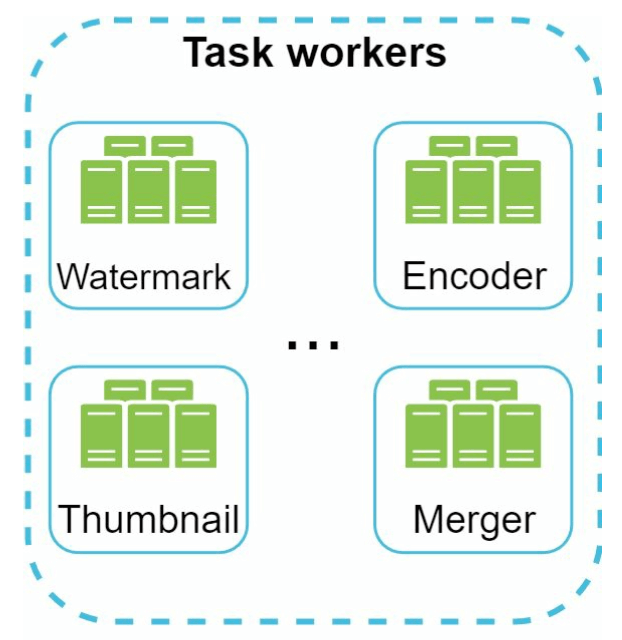
任务工作器: 执行转码和其他操作。
任务 worker 任务 worker 负责执行转码及其他操作。不同类型的 worker 跑不同任务:水印、编码、缩略图、合并等,同类 worker 可水平扩展以提升并行度。 任务 worker 水印 编码器 缩略图 合并器 … 按 diagram-design 重绘 查看原图
临时存储: 存储用于重试的中间数据。
存储系统的选择取决于数据类型、数据大小、访问频率、数据生命周期等因素。
输出: 可供分发的转码后视频。
系统优化
速度优化
并行视频上传: 将视频分割为更小的块,实现更快、可断点续传的上传。
视频切分 为加速上传并支持断点续传,长视频按 GOP 对齐切成小块:原始视频被切成 GOP 1、GOP 2 … GOP N,各块可独立并行上传,失败只需重传对应分片。 GOP 分片 原始视频 GOP 1 GOP 2 GOP N 按 GOP 对齐切分 长视频按 GOP 对齐切成小块,便于并行与续传 … 按 diagram-design 重绘 查看原图 分布式上传中心: 使用 CDN 作为靠近用户的上传枢纽。
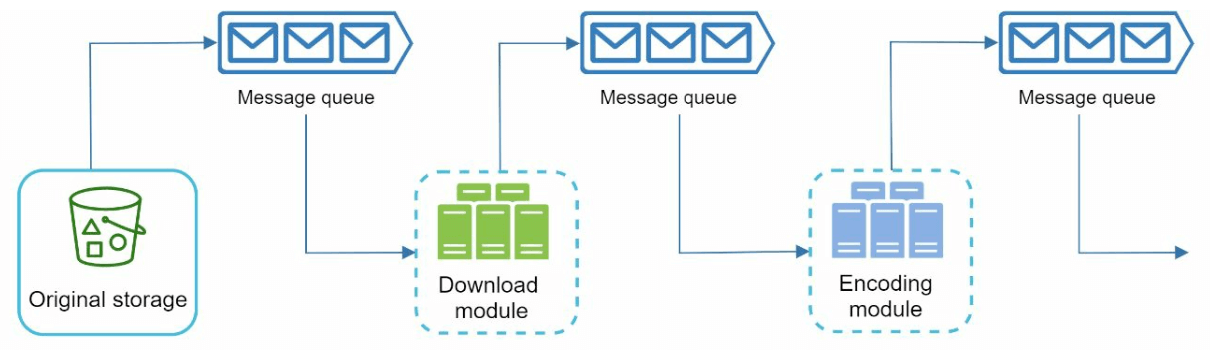
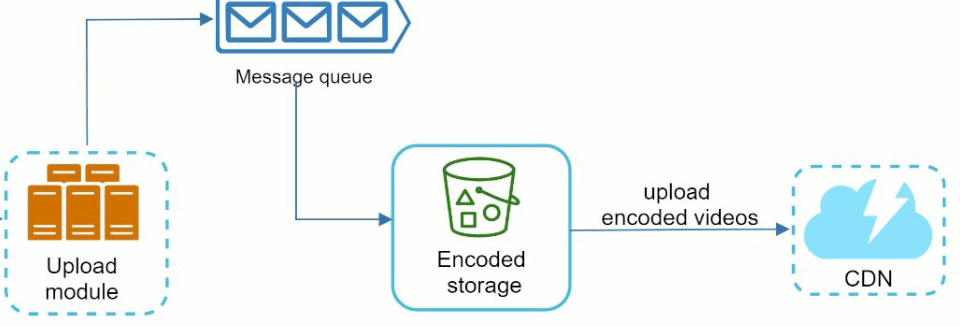
并行处理: 使用消息队列解耦模块,实现高并行度。
消息队列(一) 用消息队列把模块解耦以获得高并行度:原始存储的数据入队后由下载模块拉取,下载完成再入队由编码模块拉取,编码完成继续入队交给下游。各模块独立扩缩容。 原始存储 消息队列 下载模块 消息队列 编码模块 消息队列 入队 拉取 入队 拉取 入队 模块间用消息队列解耦,实现高并行 按 diagram-design 重绘 查看原图 消息队列(二) 上传模块把任务入队,编码侧从消息队列拉取,编码后的视频写入编码后存储,再上传到 CDN。队列把上传与编码两段流水线解耦,各自独立扩展。 上传模块 消息队列 编码后存储 CDN 入队 拉取 上传到 CDN 编码完成后经消息队列写入存储并上传 CDN 按 diagram-design 重绘 查看原图
安全优化
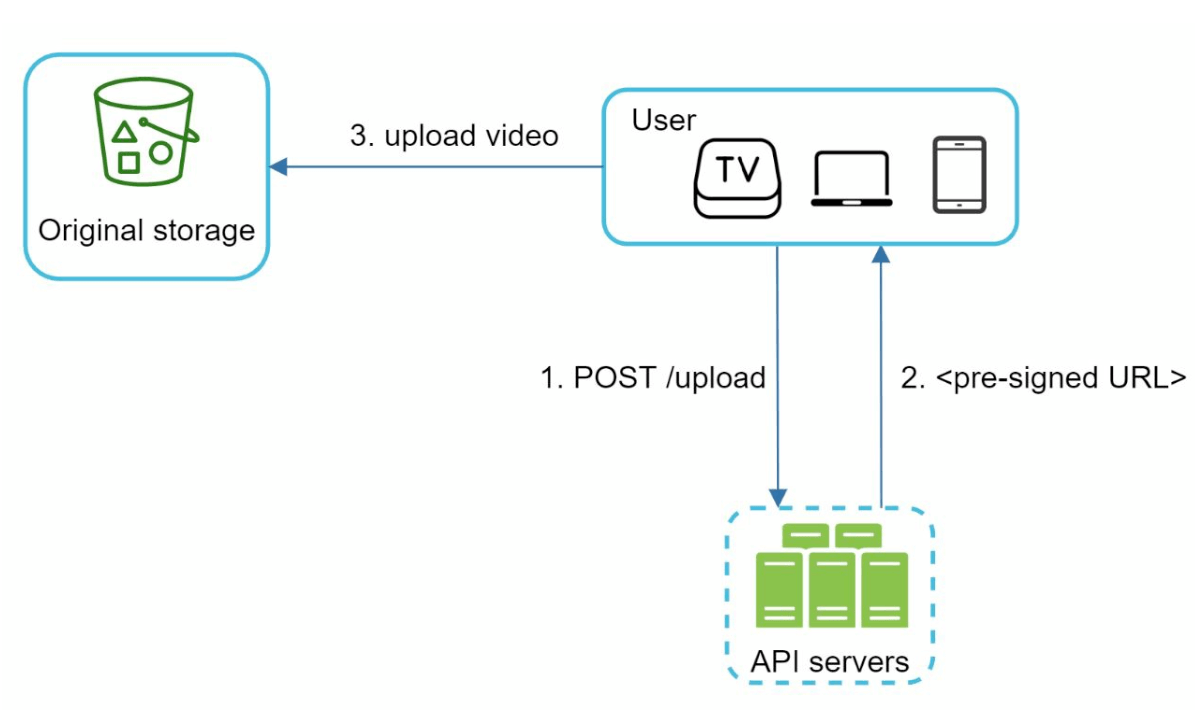
预签名 URL: 限制视频上传仅对授权用户开放。
预签名 URL 用预签名 URL 限制上传只对授权用户开放:[1] 客户端先 POST /upload 请求上传;[2] API 服务器返回一个预签名 URL;[3] 客户端凭该 URL 直接把视频上传到原始存储,全程不经 API 服务器转发。 原始存储 用户 API 服务器 1 POST /upload 2 预签名 URL 3 上传视频 1 请求上传 → 2 返回预签名 URL → 3 直传原始存储 预签名 URL 限制上传仅授权用户可用 按 diagram-design 重绘 查看原图 保护视频:
DRM 系统 (例如 Apple FairPlay、Google Widevine)。AES 加密。 添加水印。
成本节省优化
仅通过 CDN 提供热门视频;冷门视频由高容量服务器提供。
对于极少访问的视频按需转码。
根据热门程度对视频分发进行区域化。
构建自建 CDN,并与 ISP 合作以降低带宽成本。
错误处理
可恢复错误
不可恢复错误
第 15 章:设计 Google Drive
引言
Google Drive 是一种基于云的文件存储与同步服务,允许用户从各种设备存储、访问和共享文件。本章讨论如何设计一个可扩展的系统,具备以下功能:
文件上传与下载 跨设备文件同步 文件共享 文件修订历史 编辑、删除和共享通知
第 1 步:理解问题
关键需求
功能需求:
上传和下载文件。
跨多个设备同步文件。
维护文件修订记录。
支持带权限的文件共享。
在文件编辑、删除和共享时发送通知。
非功能需求:
可靠性: 数据丢失不可接受。快速同步速度: 避免因同步延迟使用户不耐烦。带宽效率: 最大限度地减少不必要的数据使用。可扩展性: 处理 1000 万日活跃用户(DAU)。高可用性: 在服务器故障或网络问题期间无缝运行。
约束与假设
用户获得 10 GB 免费空间 。
最大文件大小:10 GB 。
平均文件上传大小:500 KB 。
上传频率:每个用户每天 2 个文件 。
所需总存储:500 PB 。
第 2 步:高层设计
单服务器设置
基本设置包括:
Web 服务器: 处理上传和下载。元数据数据库: 用于跟踪用户数据、登录信息、文件信息/等元数据。存储目录: 按命名空间组织存储文件。
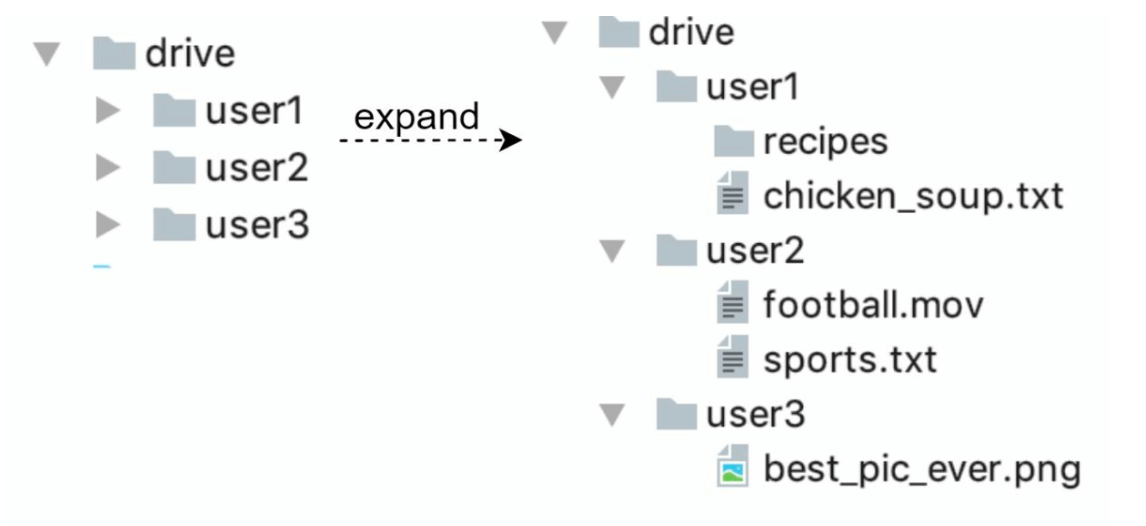
命名空间与目录展开 根目录 drive/ 下为每个用户建一个命名空间,命名空间内是各自上传的文件与文件夹。文件或文件夹由「命名空间 + 相对路径」唯一确定,例如 user1 命名空间下的 recipes/chicken_soup.txt。 命名空间 drive/ 命名空间根目录 user1 recipes/chicken_soup.txt user2 football.mov / sports.txt user3 best_pic_ever.png 展开 根目录 drive/ 下按用户划分命名空间 文件 = 命名空间 + 相对路径,全局唯一 按 diagram-design 重绘 查看原图
设置一个 Web 服务器和一个名为 drive/ 的目录作为根目录,用于存储上传的文件。
在 drive/ 目录下,有一个名为命名空间的目录列表。
每个命名空间包含该用户的所有上传文件。
每个文件或文件夹可以通过命名空间和相对路径的组合唯一标识。
这种设计可以作为一个起点,但不足以支持扩展。
API
上传文件到 Google Drive: 支持两种上传类型
从 Google Drive 下载文件: 下载文件时
获取文件修订历史:
转向分布式系统
改进之处:
分片: 基于 user_id 将存储分散到多个服务器。
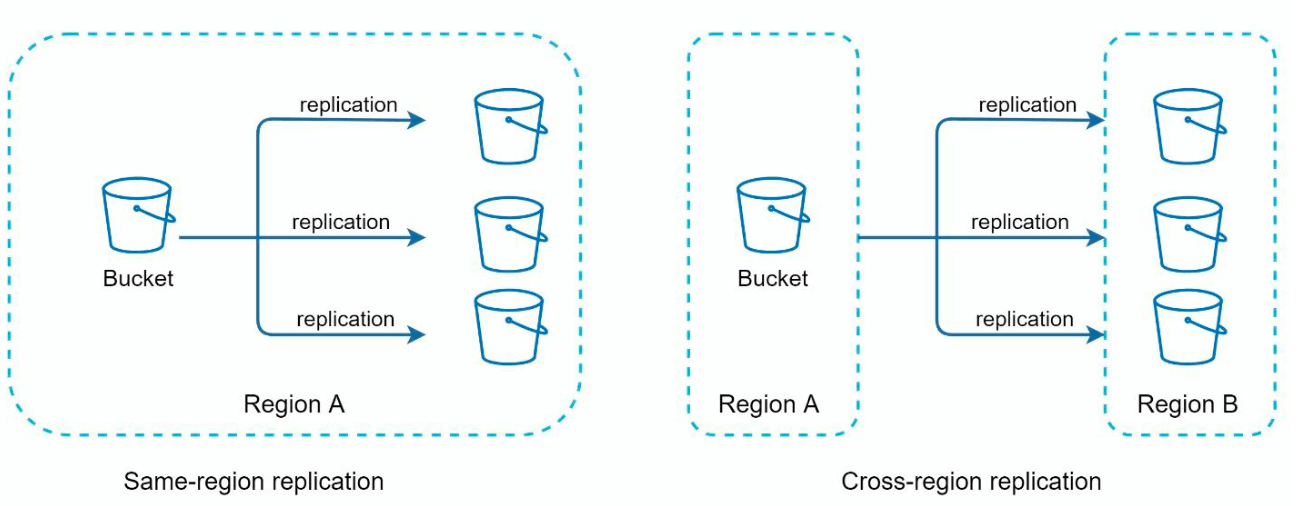
Amazon S3: 使用 S3 提供可扩展且冗余的文件存储,并进行跨区域复制。
同区域与跨区域复制 对象存储的副本策略分两种:同区域复制把多个副本放在同一地域,写入延迟低、可用性高,但整个地域故障时一起丢失;跨区域复制把副本放到另一个地域,可抗地域级故障,代价是复制延迟更高。 同区域复制 区域 A 区域 B Bucket 副本 副本 副本 Bucket 副本 副本 副本 复制 复制 同区域:多副本同地域,延迟低 跨区域:副本跨地域,可容灾但延迟高 按 diagram-design 重绘 查看原图 负载均衡器: 将流量分发到多个 Web 服务器。
元数据数据库复制: 通过数据库分片和复制确保可用性。
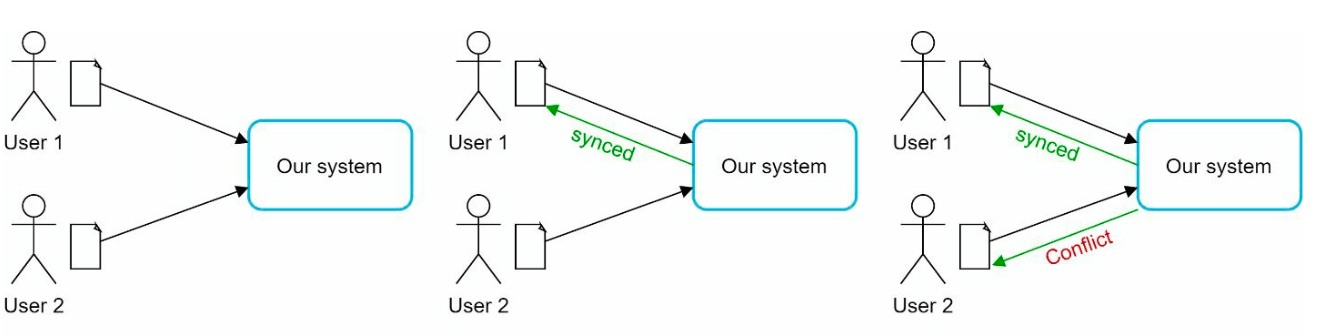
同步冲突:
对于像 Google Drive 这样的大型存储系统,同步冲突时有发生。
当两个用户同时修改同一个文件或文件夹时,就会发生冲突。
同步冲突的三种结局 两个用户同时修改同一文件时:先被处理的版本生效并回传;落后的那一端收到冲突。系统会把本地副本与服务端最新版本都摆出来,由用户选择合并,或用其中一个覆盖另一个。 ① 同时编辑 ② 先到者生效 ③ 冲突提示 User 1 User 2 我们的系统 User 1 User 2 我们的系统 User 1 User 2 我们的系统 编辑 编辑 已同步 已同步 冲突 user1、user2 同时改同一文件 user1 先到,更新生效 user2 收到冲突,可合并或覆盖 按 diagram-design 重绘 查看原图
在该示例中,用户 1 和用户 2 尝试同时更新同一个文件,但用户 1 的文件先被我们的系统处理。
用户 1 的更新操作成功,但用户 2 会遇到同步冲突。
系统会展示同一文件的两个副本:用户 2 的本地副本和服务器上的最新版本。
用户 2 可以选择合并两个文件,或者用其中一个版本覆盖另一个版本。
改进后的设计
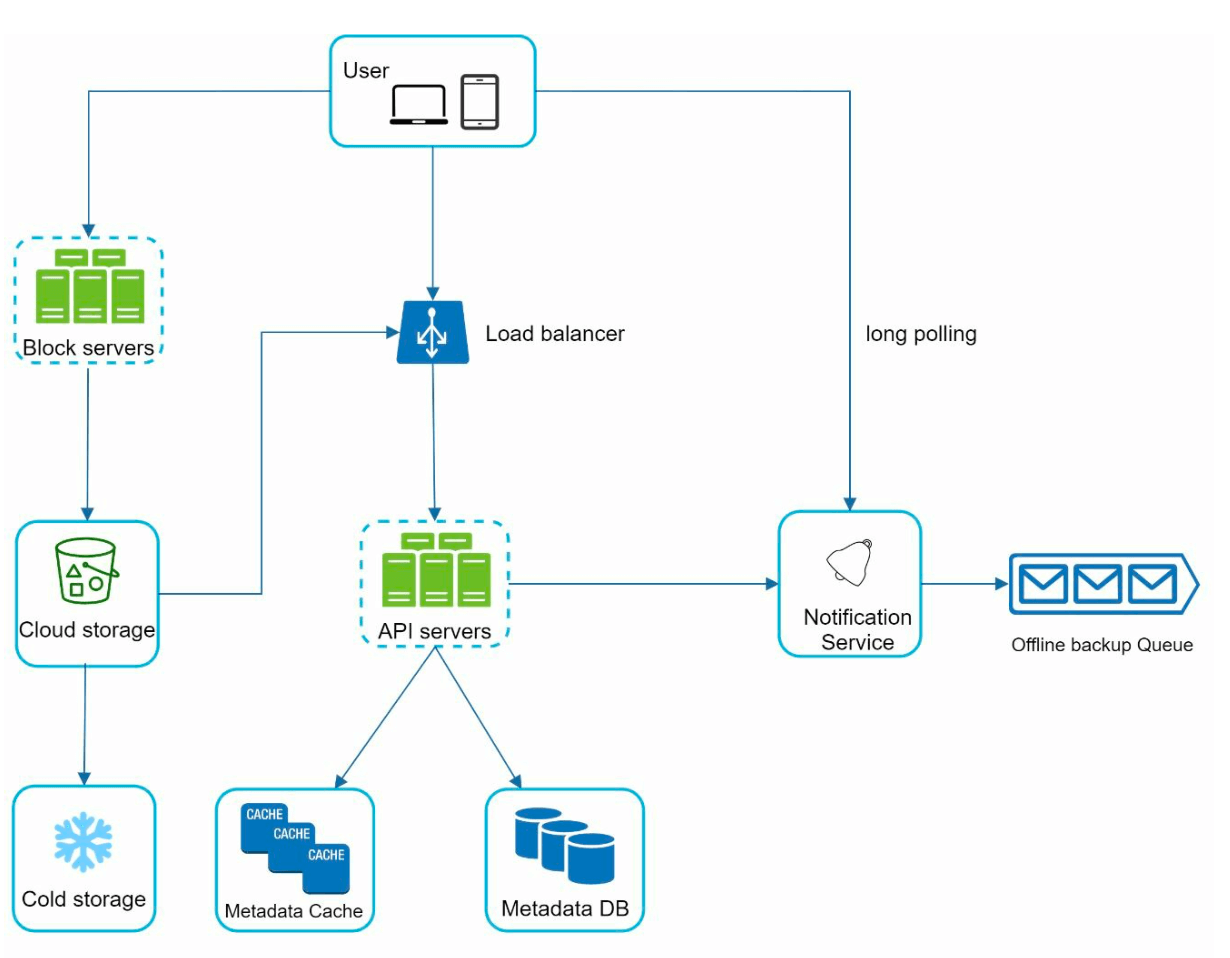
Google Drive 高层架构 用户经浏览器或移动端接入:文件走块服务器切成 4 MB 块后存入云存储,冷数据下沉到冷存储;非上传类流程走负载均衡器到 API 服务器。API 服务器读写元数据 DB 与缓存,并通过通知服务把变更推给客户端,离线客户端由备份队列暂存。 用户 块服务器 4 MB 分块 负载均衡器 云存储 块存储 API 服务器 非上传流程 通知服务 发布订阅 离线备份队列 离线补同步 冷存储 归档 元数据 DB / 缓存 用户 / 文件 / 块 上传 / 下载 文件上传 长轮询 存储块 冷归档 分发 读写块 元数据 变更通知 离线订阅 文件切成 4 MB 块,按哈希去重存储 非上传流程由 API 服务器处理 按 diagram-design 重绘 查看原图
用户交互: 用户通过浏览器或移动应用访问应用。
块服务器:
文件被分割为 4 MB 的块 (最大大小),并分配唯一的哈希值。
块独立存储在云存储中(例如 Amazon S3)。
文件重建需要按特定顺序拼接块。
云存储: 块存储在云存储中,以提供可扩展性和冗余。
冷存储: 不活跃的文件被移至冷存储以降低成本。
负载均衡器: 在 API 服务器之间均匀分配请求,以确保高效运行。
API 服务器:
处理用户认证、配置文件管理和文件元数据更新。
管理所有非上传工作流。
元数据数据库和缓存:
存储用户、文件、块和版本的元数据。
频繁访问的元数据被缓存,以加快检索速度。
通知服务:
一个 发布 / 订阅系统 ,用于通知客户端文件变更(添加、编辑、删除)。
确保客户端可以拉取最新更新。
离线备份队列: 临时存储离线客户端的文件变更信息,以便其重新上线后同步。
第 3 步:深入设计
元数据数据库
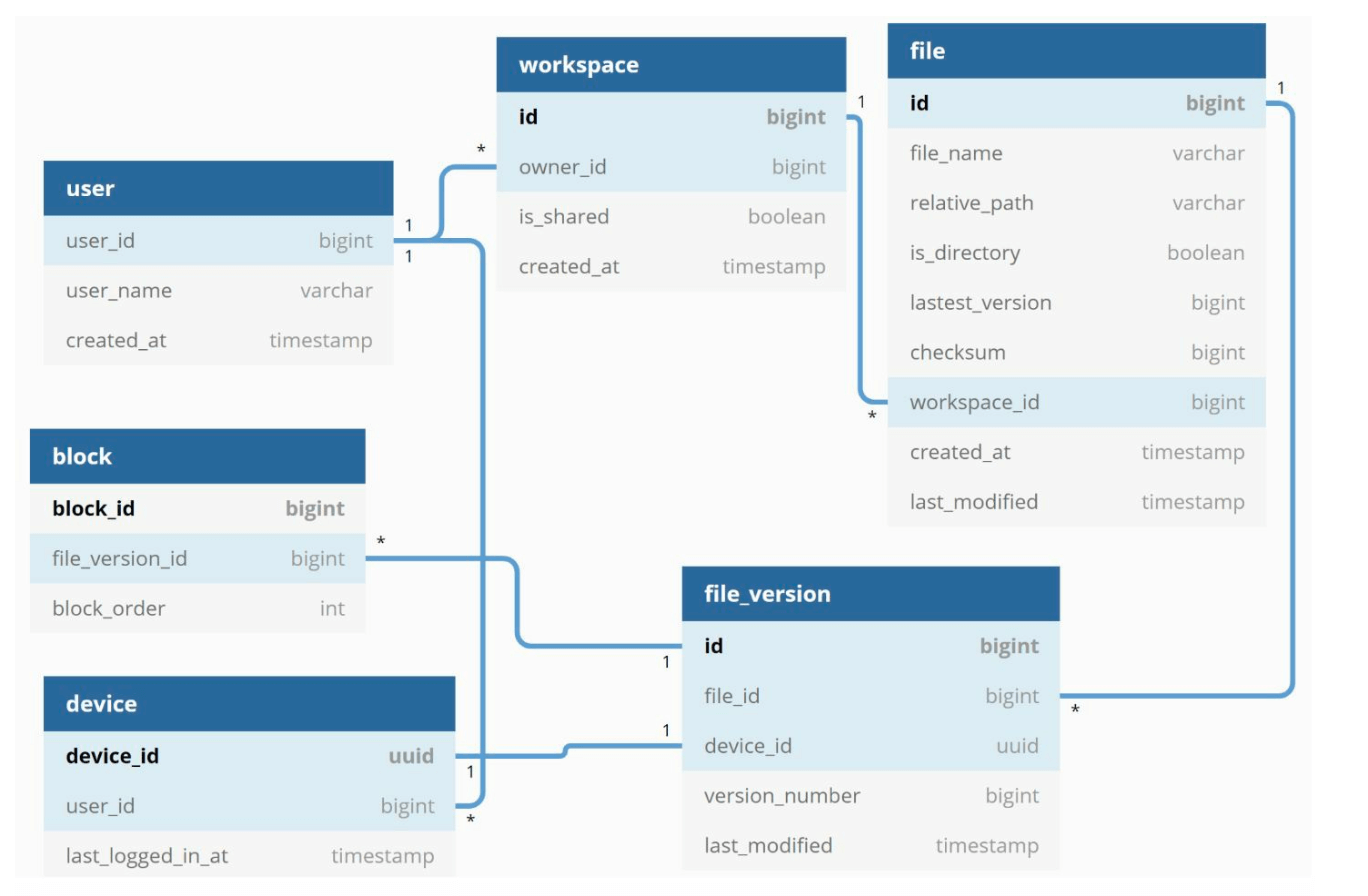
下面展示的是一个高度简化的版本,因为它只包含最重要的表和字段。
模式设计:
用户表: 存储用户配置文件与偏好。文件表: 维护文件元数据(例如大小、名称、路径)。块表: 跟踪文件块,用于重建文件。文件版本表: 存储文件修订历史。
元数据数据库表关系 高度简化的四类核心表:user 拥有多个 workspace,workspace 下挂多个 file;file 有多个 file_version 记录修订历史,file_version 再拆成多个 block;device 记录登录设备,其上传的版本也指向 file_version。 user 表 user_id · user_name workspace 表 id · owner_id · is_shared file 表 id · file_name · checksum block 表 block_id · file_version_id file_version 表 id · file_id · version device 表 device_id · user_id 拥有 包含 版本 分块 设备 上传 高度简化:仅列关键表与字段 file_version 记每次修订,block 指向其版本 按 diagram-design 重绘 查看原图 文件上传流程
文件上传:
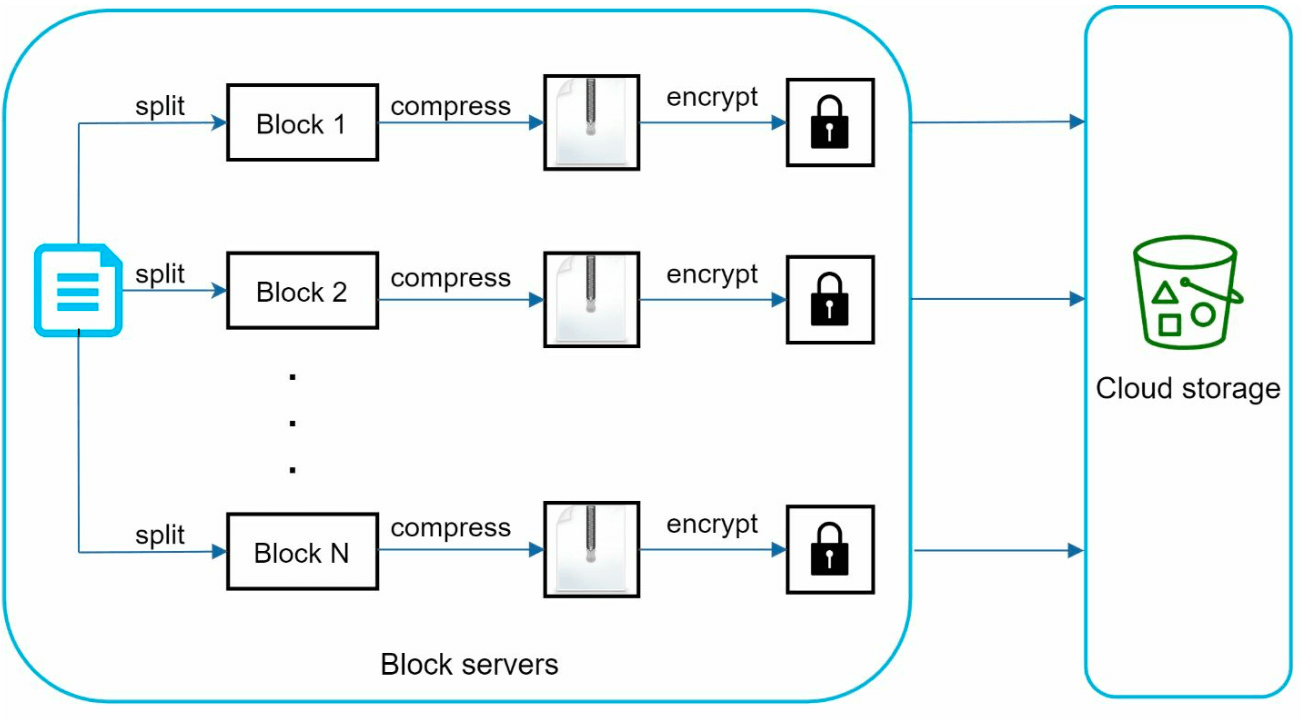
文件被分割成块,由块服务器进行压缩和加密。
块被上传到块服务器并存储在 S3 中。
元数据上传:
客户端将元数据发送到 API 服务器。
元数据以 pending 状态存储在数据库中。
完成:
S3 触发回调,将文件状态更新为 uploaded。
通知服务通知相关用户。
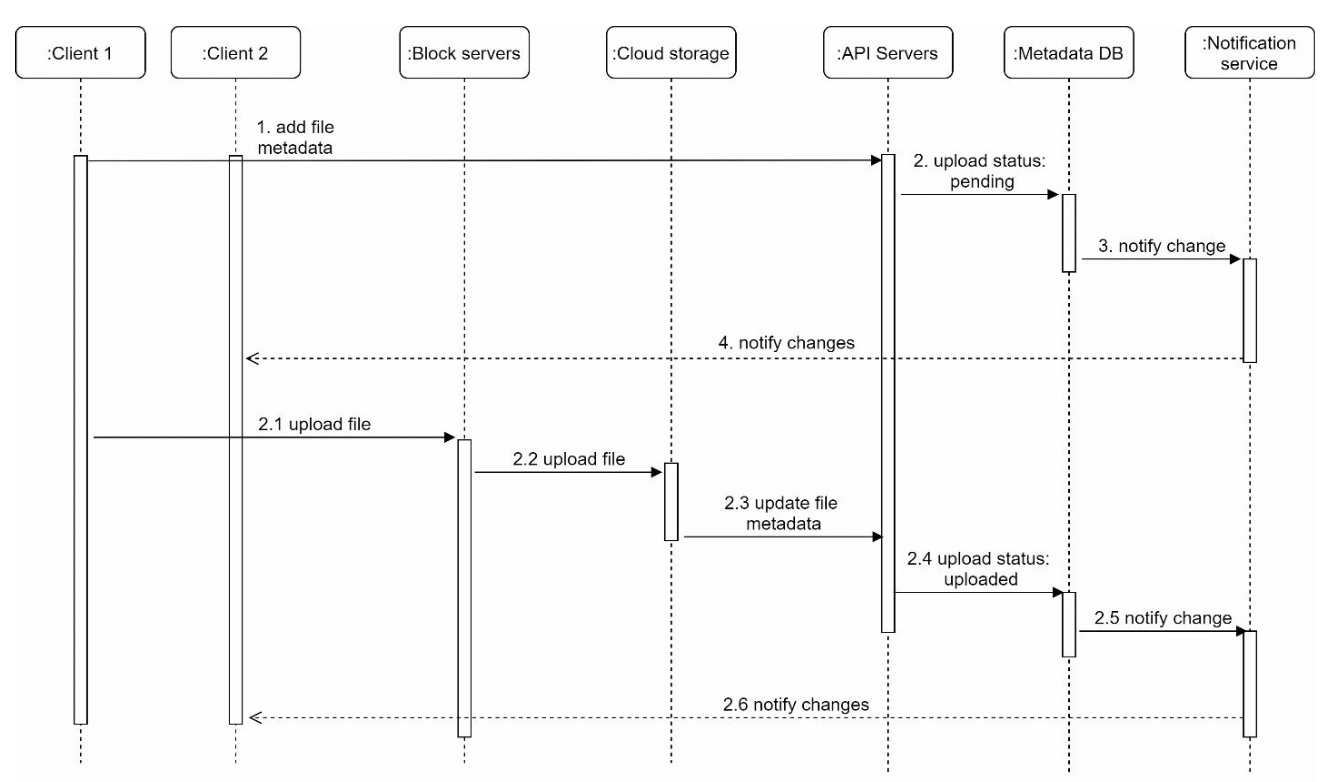
文件上传流程 上传分两步:客户端先把元数据交给 API 服务器,落库为 pending 状态;再把文件块经块服务器存入云存储。云存储完成后回调 API 服务器把状态改为 uploaded,并由通知服务把变更推给相关客户端。 客户端 上传方 API 服务器 写元数据 元数据 DB pending 状态 块服务器 切块 + 压缩 云存储 S3 存储块 通知服务 长轮询 元数据 pending 上传文件 存块 回调 通知变更 先传元数据(pending),再传块 云存储回调后状态改为 uploaded 按 diagram-design 重绘 查看原图 文件同步
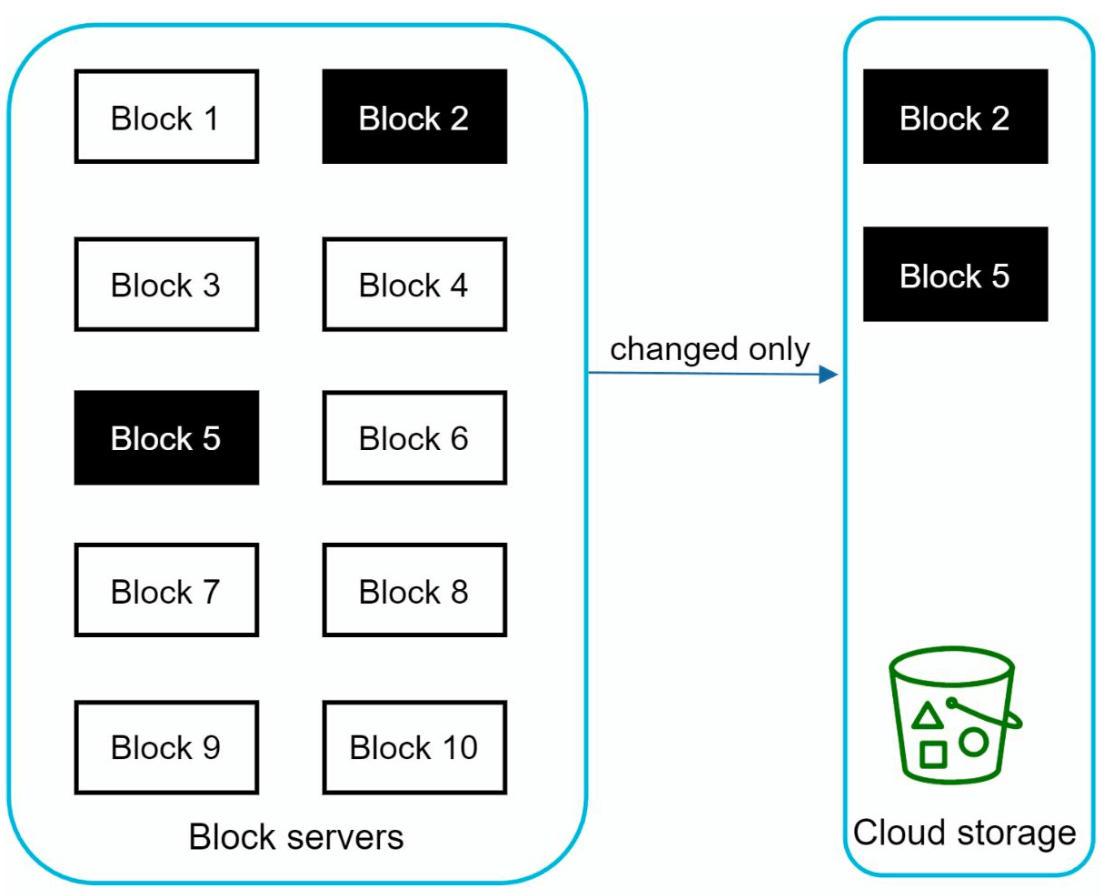
增量同步: 仅传输修改过的块,而不是整个文件。
增量同步(Delta Sync) 文件切成等长块后各自算哈希。同步时逐块比对,只传输哈希发生变化的块,其余块直接跳过,从而大幅节省带宽。图中 Block 2 与 Block 5 变化,只有它们被上传到云存储。 块服务器 云存储 Block 1 Block 2 Block 3 Block 4 Block 5 Block 6 Block 7 Block 8 Block 9 Block 10 Block 2 Block 5 仅传变更块 文件切成等长块,各块独立哈希 仅上传哈希变化的块 Block 2 与 Block 5 变更,其余块跳过 按 diagram-design 重绘 查看原图
压缩: 根据文件类型使用压缩算法对块进行压缩。
冲突解决:
先处理的版本优先。
冲突版本分别保存,由用户解决。
文件切块同步链路 客户端把文件切分成块,每块依次经过压缩与加密,再上传到云存储。压缩按文件类型选用不同算法,加密保证传输与静态数据安全;所有块上传后按特定顺序拼回原文件。 文件 原始文件 Block 1 Block 2 Block N 压缩 压缩 压缩 加密 加密 加密 云存储 块存储 压缩 压缩 压缩 加密 加密 加密 文件 → 切块 → 压缩 → 加密 → 云存储 压缩按文件类型选算法 加密后的块上传到云存储 按 diagram-design 重绘 查看原图 文件下载流程
当文件在其他地方被添加或编辑时,会触发下载流程。客户端可以通过两种方式得知:
如果客户端 A 在线,而另一个客户端更改了文件,通知服务会通知客户端 A。
如果客户端 A 离线,而另一个客户端更改了文件,数据将被保存到缓存中。当离线客户端重新上线时,它会拉取最新更改。
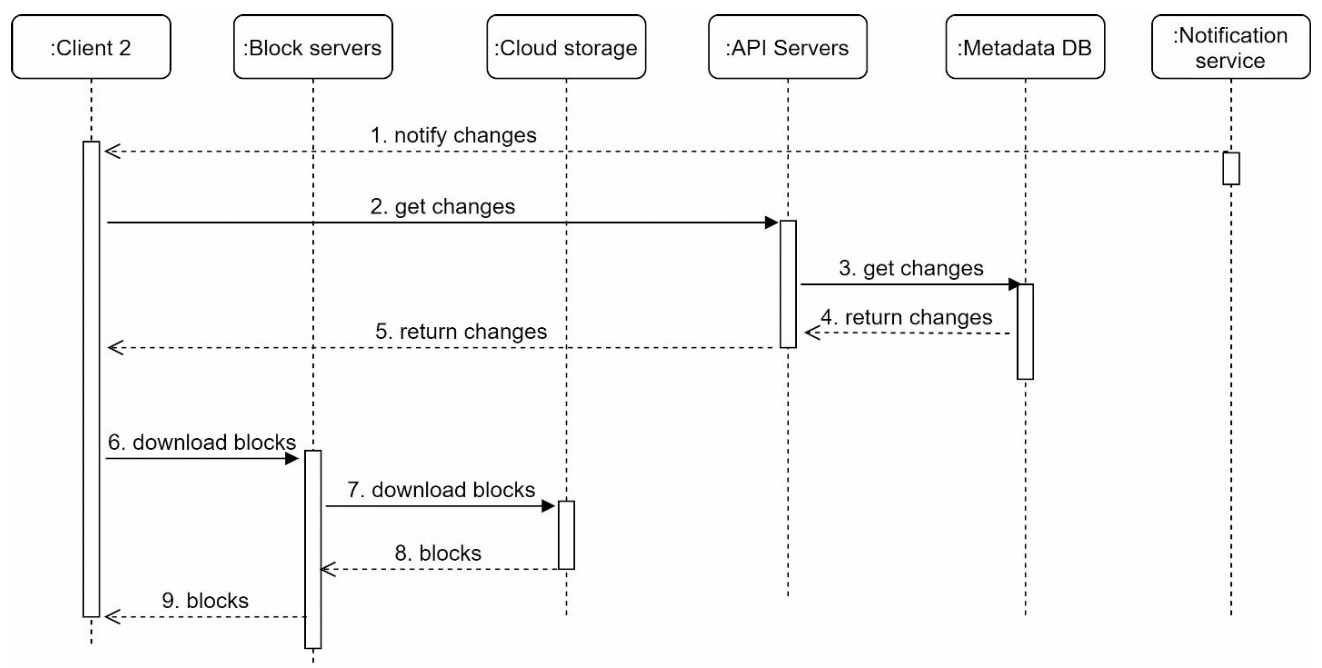
一旦客户端知道文件已更改,它首先通过 API 服务器请求元数据,然后下载块来构建文件。
触发: 通知服务告知客户端文件更新。元数据获取: 客户端通过 API 获取更新的元数据。块下载: 客户端从块服务器下载更新的块并重建文件。
文件下载流程 文件在别处被改动时,在线客户端由通知服务经长轮询得知,离线客户端上线后自行拉取。客户端先经 API 服务器取回最新元数据,再向块服务器下载变更的块,块由块服务器从云存储取回,客户端按序重建文件。 通知服务 长轮询 客户端 重建文件 API 服务器 查元数据 元数据 DB 变更记录 块服务器 取块 云存储 块存储 通知变更 拉取变更 查元数据 下载块 取块 被通知后:先拉元数据,再下载变更块 块由云存储返回,客户端按序重建文件 按 diagram-design 重绘 查看原图 通知服务
目的: 让客户端了解文件变更。机制: 采用 长轮询 实现异步通知。示例: 当文件被添加、编辑或删除时,通知会推送给所有相关客户端。
存储优化
去重: 使用基于哈希的比较,在账户级别删除重复的块。版本策略:
限制保存的修订数量。
对于经常编辑的文件,优先保留最近的版本。
冷存储: 将很少访问的文件移至更便宜的存储方案(例如 Amazon S3 Glacier)。
故障处理
负载均衡器故障: 辅助负载均衡器转为活动状态。块服务器故障: 待处理任务被重新分配给其他服务器。元数据数据库故障:
云存储故障: 使用跨区域复制来获取不可用的文件。通知服务故障: 客户端重新连接到备用服务器。
第 16 章:邻近服务
引言
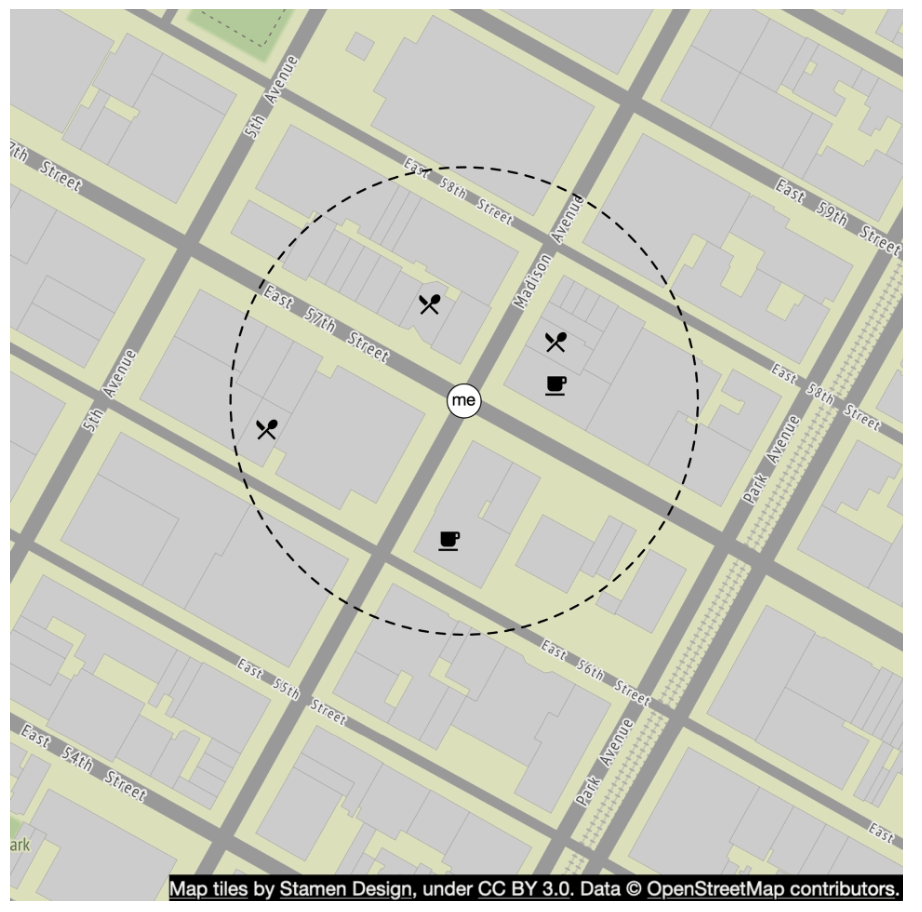
邻近服务 旨在查找附近的场所,如餐厅、酒店、加油站和其他商家。该功能用于 Google Maps 和 Yelp 等应用,帮助用户在指定半径内发现地点。
步骤 1:理解问题并确定范围
功能需求
基于用户位置(纬度、经度)和搜索半径搜索商家 。允许商家所有者添加、更新或删除商家 (非实时)。在请求时提供详细的商家信息 。
非功能需求
低延迟 :用户应获得快速响应。数据隐私 :符合 GDPR 和 CCPA 法规。高可用性 :处理繁忙地点高峰时段的流量激增。
粗略估算
1 亿日活用户 。系统中 2 亿商家 。搜索 QPS 计算 :
用户每天进行 5 次搜索 。
搜索 QPS = (1亿 × 5) / 86,400 ≈ 5,000 QPS 。
步骤 2:高层次设计
API 设计 搜索附近商家 GET /v1/search/nearby
请求参数 :
latitude:用户所在位置的纬度。longitude:用户所在位置的经度。radius:搜索半径(默认:5000m)。
商家 API
API 端点
描述
GET /v1/businesses/{id}获取详细商家信息
POST /v1/businesses添加新商家
PUT /v1/businesses/{id}更新商家详情
DELETE /v1/businesses/{id}从系统中删除商家
数据模型
由于读取量很高,因为两个功能非常常用,像 MySQL 这样的关系数据库是一个不错的选择。
数据模式
关键数据库表是商家表和地理空间索引表。
商家表包含商家的详细信息。
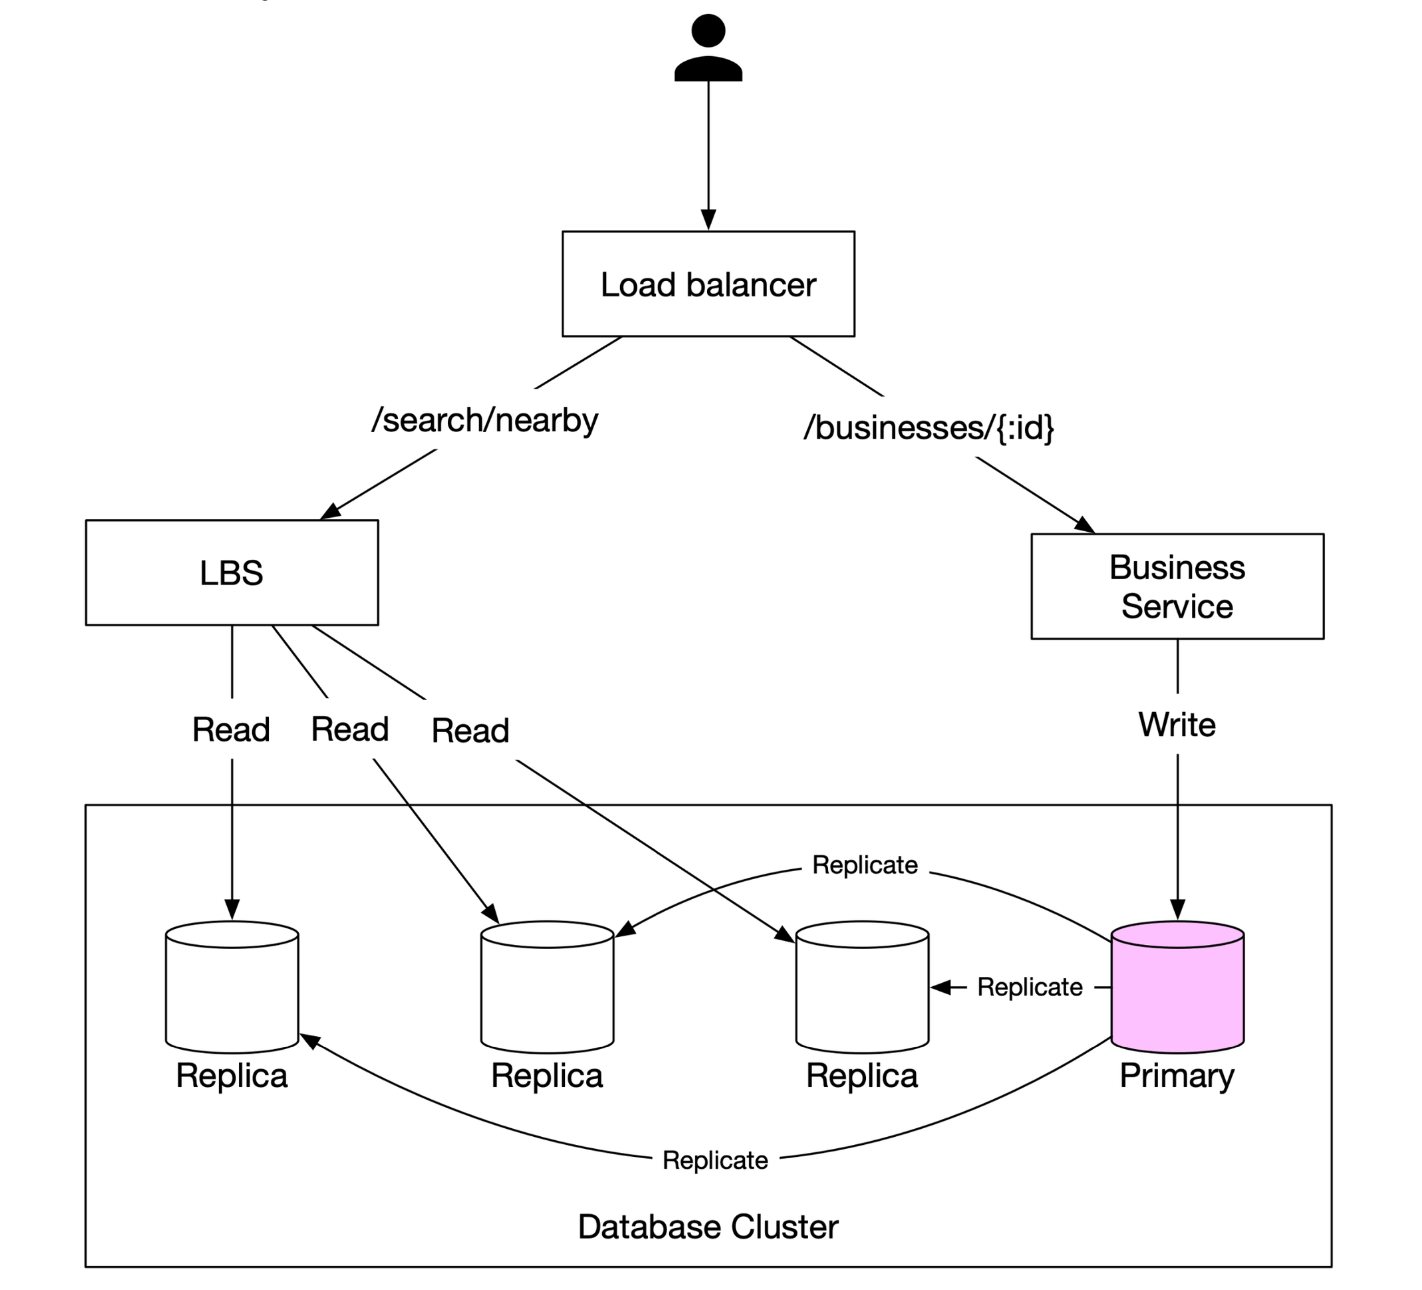
高层次系统架构 系统由两部分组成:基于位置的服务(LBS)和商家相关服务。
高层设计:LBS 与 Business 服务 系统分成两部分:LBS 处理「按位置找附近商家」,是纯读、无状态、可水平扩展的服务;Business 服务处理商家主的增删改和顾客查看详情。负载均衡把两类请求分派到对应服务,两者共用一套主从数据库集群——读走副本、写走主库。商家信息不要求实时,副本的轻微延迟可以接受。 数据库集群 用户 负载均衡 LBS 服务 搜索附近 Business 服务 增删改查 Replica Replica Primary 搜索请求 转发 商家接口 读 读 写 复制 复制 两部分:LBS 做定位搜索(读多),Business 服务做商家增删改查(写少) 主从复制:读副本、写主库 按 diagram-design 重绘 查看原图
基于位置的服务(LBS) :
处理基于位置的搜索查询。
读密集型服务,没有写请求。
在密集区域的高峰时段 QPS 很高,并且系统是无状态的。
商家服务 :处理两类请求。
商家所有者创建、更新或删除商家。
客户查看商家的详细信息。
负载均衡器 :将流量路由到 LBS 和商家服务。数据库集群 :
使用主从复制 架构来处理读密集型工作负载。
LBS 读取的数据与主数据库写入的数据之间可能存在一些差异。
这种不一致不是问题,因为商家信息不是实时更新的。
步骤 3:获取附近商家的算法
方案 1:二维搜索(朴素方法)
朴素做法:二维圆范围搜索 最直观的做法是以用户位置为圆心、给定半径画一个圆,取圆内所有商家。SQL 上用 latitude / longitude 各加一个 BETWEEN 条件即可,但数据库的一维索引只能加速一个维度,实际仍要扫描大量行。半径越大、数据越多,代价越高。 搜索半径内的商家 我 餐厅 加油站 咖啡馆 酒店 以我为中心画半径 R 的圆,圆内即候选结果 问题:lat / long 各建一维索引仍不够,圆范围查询要扫大量行 按 diagram-design 重绘 查看原图 最直观的方法是画一个预定义半径的圆,找到圆内的所有商家。
SQL 查询:
SELECT business_id, latitude, longitude
FROM business
WHERE (latitude BETWEEN :lat - radius AND :lat + radius)
AND (longitude BETWEEN :long - radius AND :long + radius);
问题:
效率低下 :需要扫描整个数据库。受限于一维索引 (纬度/经度)。
一个潜在的改进是在经度和纬度列上建立索引,虽然这稍微好一点但仍然非常慢。
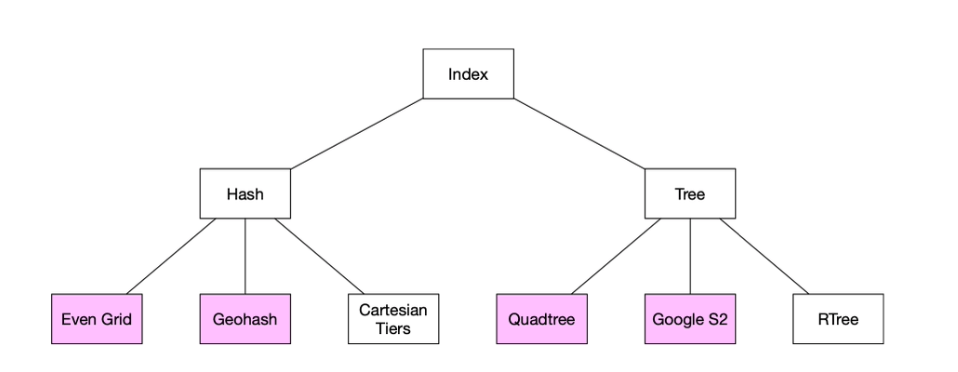
更好的方法
方案 2:均匀划分网格
均匀网格:固定边长 把世界切成固定边长的格子,每个格子存落在其中的商家。做法简单,但商家分布并不均匀:城市中心一个格子塞不下,乡村一个格子大片空置。格子大小无法随人口密度自适应,这是均匀网格最大的短板。 低密度 中密度 低密度 中密度 高密度 格子过载 中密度 低密度 中密度 低密度 均匀网格:全球切成固定边长的格子 问题:城市格子过载、乡村格子空置,无法按密度自适应 按 diagram-design 重绘 查看原图
将世界划分为固定大小的网格 。问题 :商家分布不均匀(城市密度高,农村稀疏)。
方案 3:Geohash
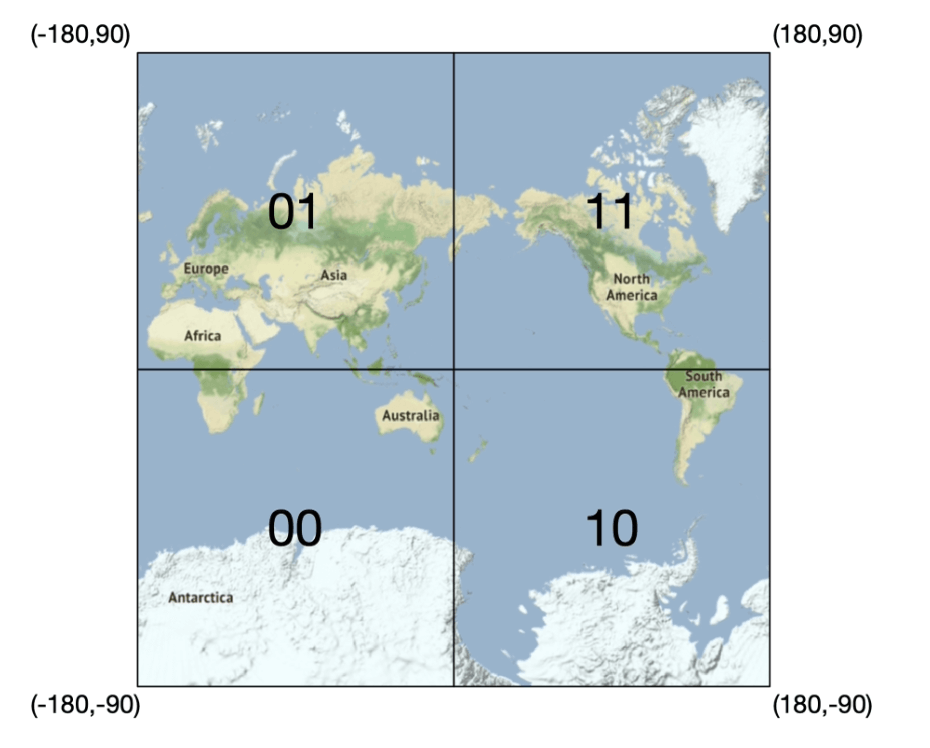
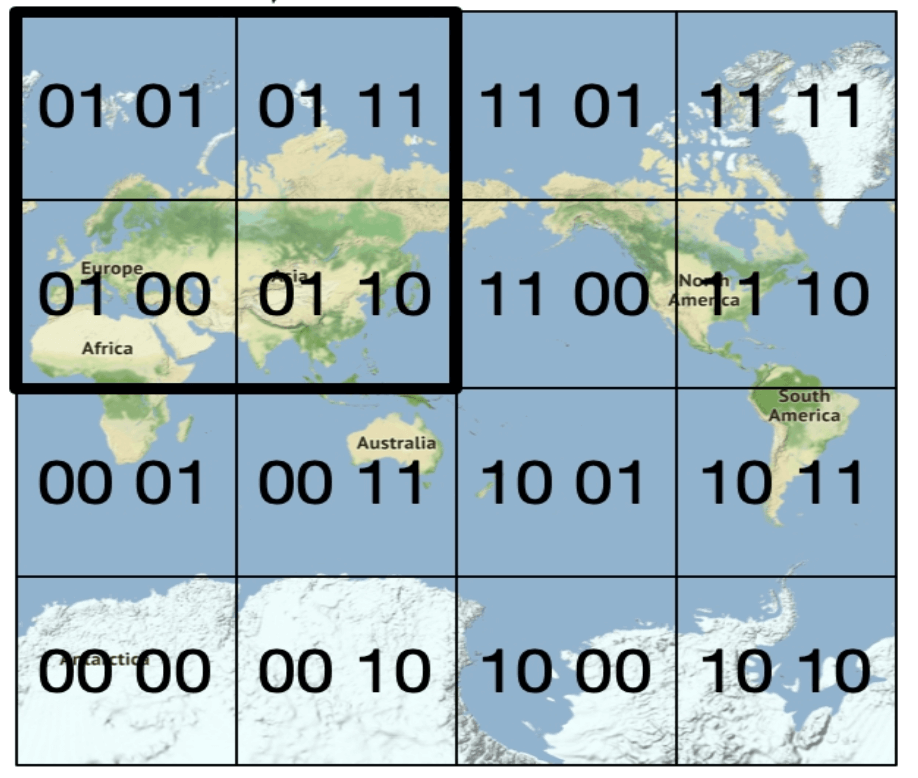
沿着本初子午线和赤道将地球划分为四个象限。然后将每个网格划分为四个更小的网格。
每个网格可以通过在经度和纬度位之间交替来表示。
重复这种细分。
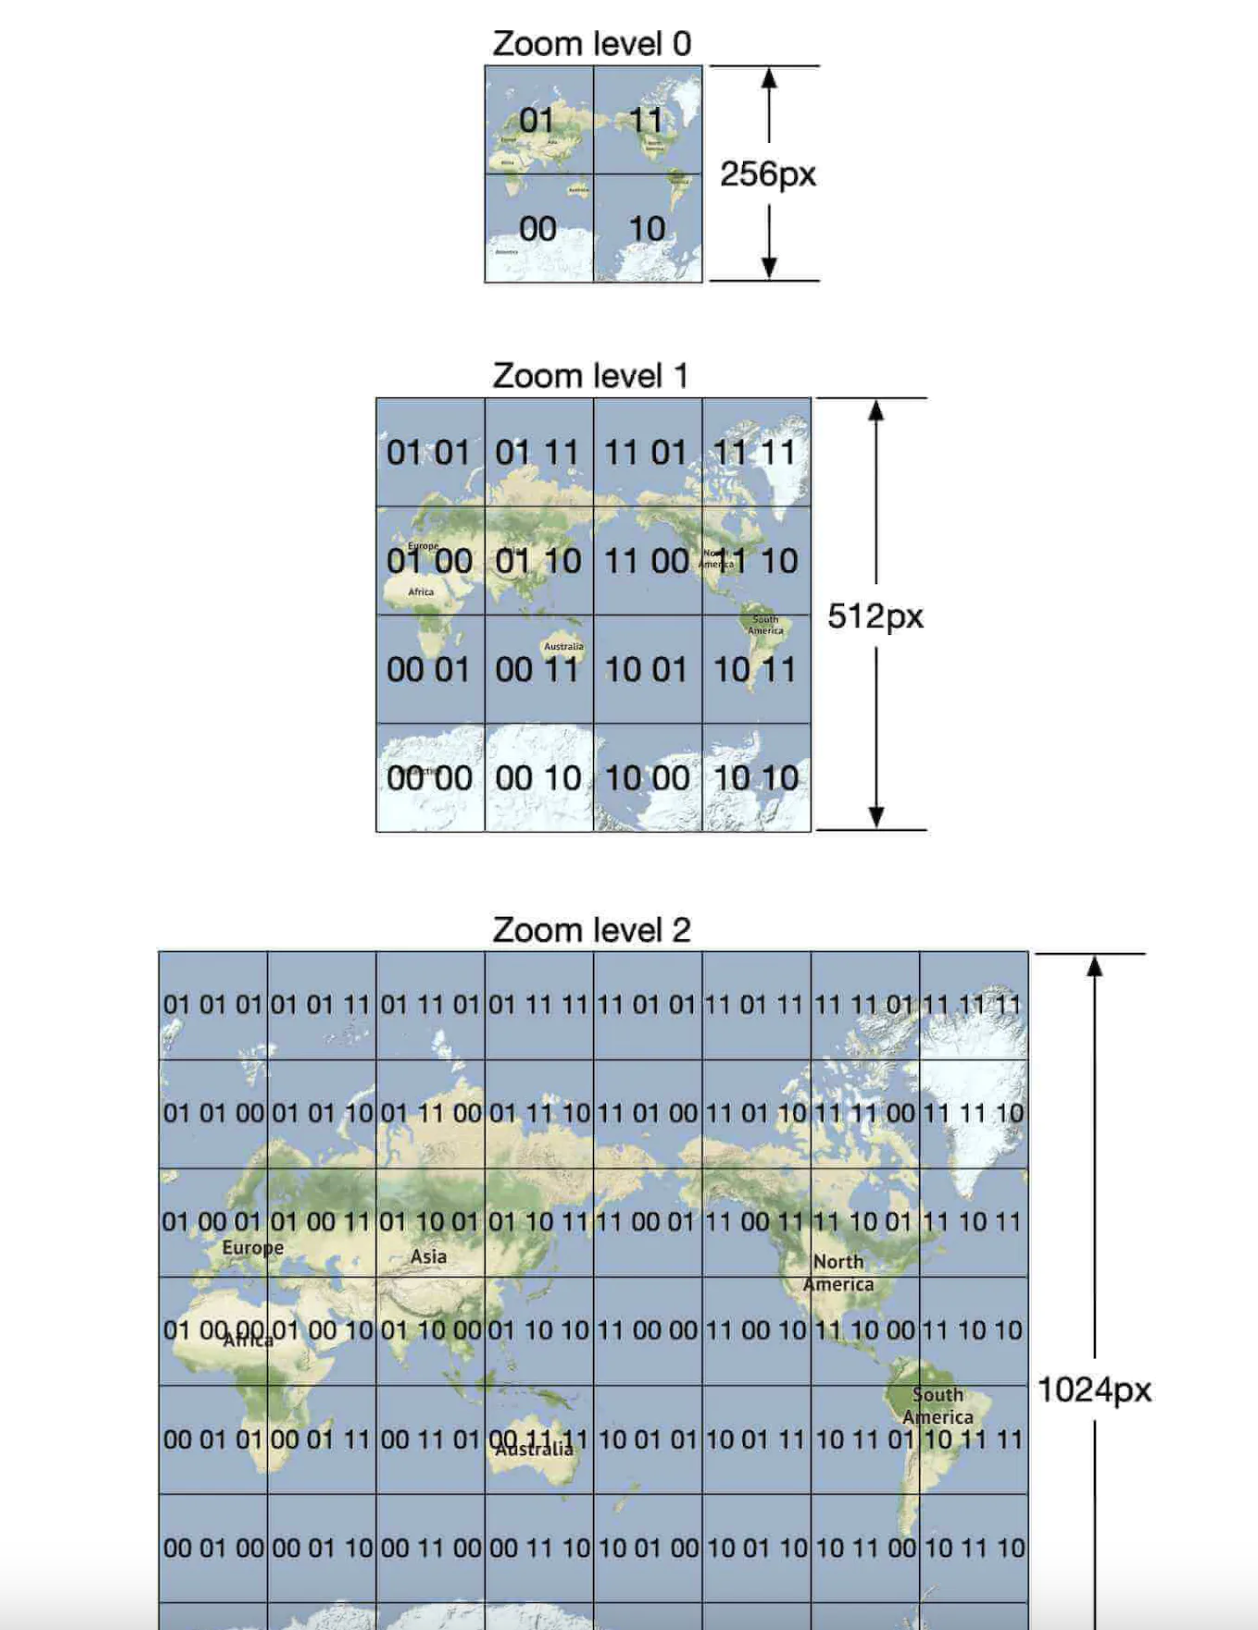
Geohash:四象限编码 先沿本初子午线和赤道把行星切成四个象限,每格再四分为四,如此递归。每个格子用交替的经度位、纬度位编码成字符串:左上为 01、右上为 11、左下为 00、右下为 10。前缀相同即代表落在同一个大格内。 01 西北 11 东北 00 西南 10 东南 沿本初子午线与赤道切成四象限,每格再四分 (-180, 90) (180, 90) (-180, -90) (180, -90) 按 diagram-design 重绘 查看原图 Geohash:继续四分的 4×4 网格 把每个象限再四分成四,就得到 4×4 的 16 个格子,每格用两位编码(纬度位 + 经度位)。继续细分下去,编码串越来越长、格子越来越小。Geohash 的核心保证是:两个 geohash 共享的前缀越长,两点越近。 01 01 01 11 11 01 11 11 01 00 01 10 11 00 11 10 00 01 00 11 10 01 10 11 00 00 00 10 10 00 10 10 每格再四分,用两位编码(纬度位 + 经度位) 共享前缀越长 → 两点越近,这是 geohash 的核心保证 按 diagram-design 重绘 查看原图 将纬度和经度编码为单个字母数字字符串 。它有 12 个精度(级别)。
分层网格结构 允许高效搜索。
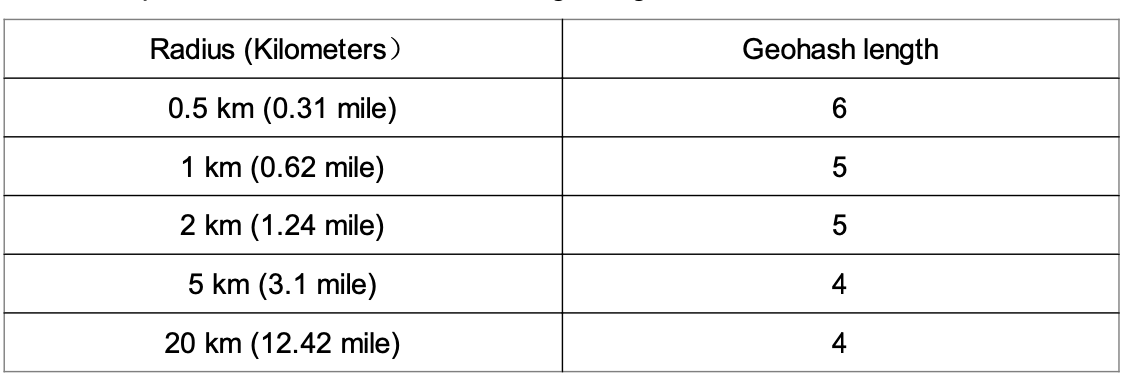
根据表格选择最小 geohash 长度来确定合适的精度。
半径与 geohash 长度对照 geohash 有 12 级精度,搜索时按半径选最短够用的编码长度。半径越小,需要的精度越高、编码越长:0.5 km 用长度 6,1~2 km 用 5,5~20 km 用 4。查表选长度可以避免精度过高带来的多余格子。 搜索半径 Geohash 长度 0.5 km 6 1 km 5 2 km 5 5 km 4 20 km 4 按半径选最短够用的 geohash 长度 半径越小,编码越长 按 diagram-design 重绘 查看原图 Geohash 保证两个 geohash 之间共享前缀越长,它们越接近。
挑战 :
边界问题与相邻格 紧贴格边的两家店可能被分到不同 geohash,前缀完全不同却近在咫尺;反之共享长前缀的两点也可能分属不同格。解决办法是把本格连同周围 8 个相邻格一起查,再按真实距离过滤,避免漏掉边界上的商家。 西北 北 东北 西 我的格子 搜索中心 东 西南 南 东南 边界问题:紧贴格边的店可能落到相邻格 解法:连同 8 个相邻格一起查,再按真实距离过滤 按 diagram-design 重绘 查看原图
边界问题 (靠近网格边缘的商家可能会被排除)。
两个位置可能非常接近但完全没有共享前缀(可能位于赤道的另一侧)。
两个位置可能具有很长的共享前缀但属于不同的 geohash。
解决方案:需要搜索相邻网格。
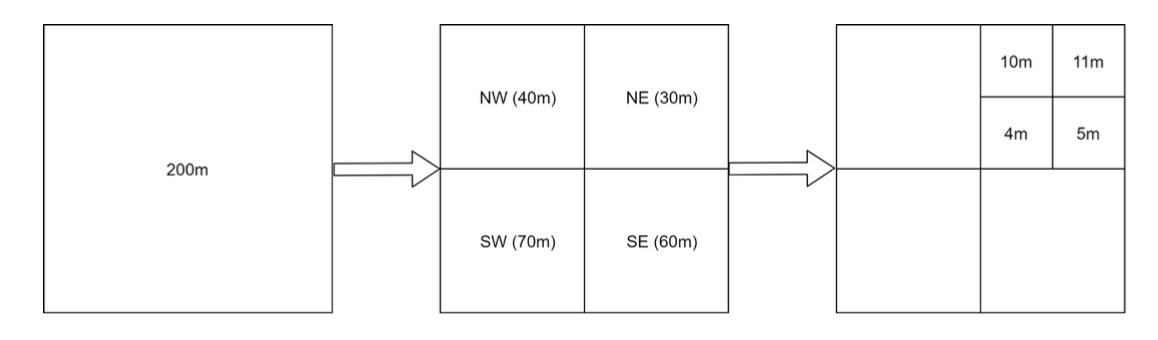
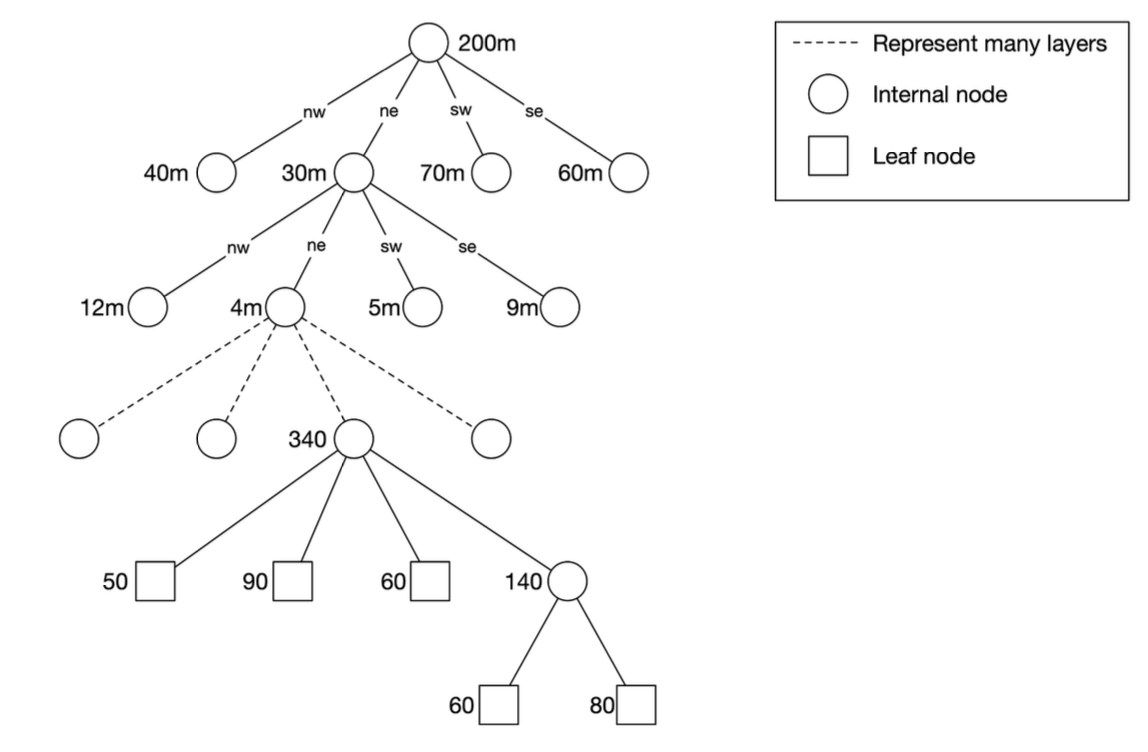
方案 4:四叉树 四叉树是一种树形数据结构,递归地将二维空间划分为四个象限,每个内部节点恰好有四个子节点,代表空间的四个子区域。
四叉树是一种内存数据结构,运行在每个 LBS 服务器上,并在服务器启动时构建。
四叉树:递归四分 四叉树把一块方形区域分成四个象限,哪个象限里的商家数超过阈值,就继续把它四分,直到每格都不超过上限(本例 100 家)。左图是根格 200m,右图是商家最密的 NE 象限继续细分。密度高的地方格子自然更小。 根节点 · 200m 见方 NE 继续四分 NW 40m NE 30m SW 70m SE 60m 10m 11m 4m 5m 再四分 四叉树:格子内商家数超过阈值就继续四分 递归直到每格不超过 100 家 按 diagram-design 重绘 查看原图
根节点递归地分解为 4 个象限,直到没有节点的商家数量超过 x(本例中为 100)。
构建四叉树:自顶向下分裂 四叉树是一棵树:每个内部节点恰好有四个孩子,对应空间的四个子区域(nw / ne / sw / se),节点上的数字是该区域的商家数。根 200m 分成 40m / 30m / 70m / 60m 四个象限;30m 象限再分成 12m / 4m / 5m / 9m;最密的 4m 象限继续分,直到叶子节点(50 / 90 / 60 / 60 / 80 家)都不超过 100。图中只展开了通向 140 的那条分支,其余分支省略。 200m 40m 30m 70m 60m 12m 4m 5m 9m 50 90 60 140 60 80 每个内部节点恰好有 4 个孩子,对应 nw / ne / sw / se 四个象限 节点数字是该区域的商家数;白底为内部节点(继续分裂),浅底为叶子(最终格子) 按 diagram-design 重绘 查看原图
四叉树索引不会占用太多内存(通常为 GB 级),可以轻松放入一台服务器。
由于构建树的时间复杂度为 nlogn,可能需要几分钟来构建树。
对 k 近邻搜索查询高效 (例如,查找最近的加油站)。
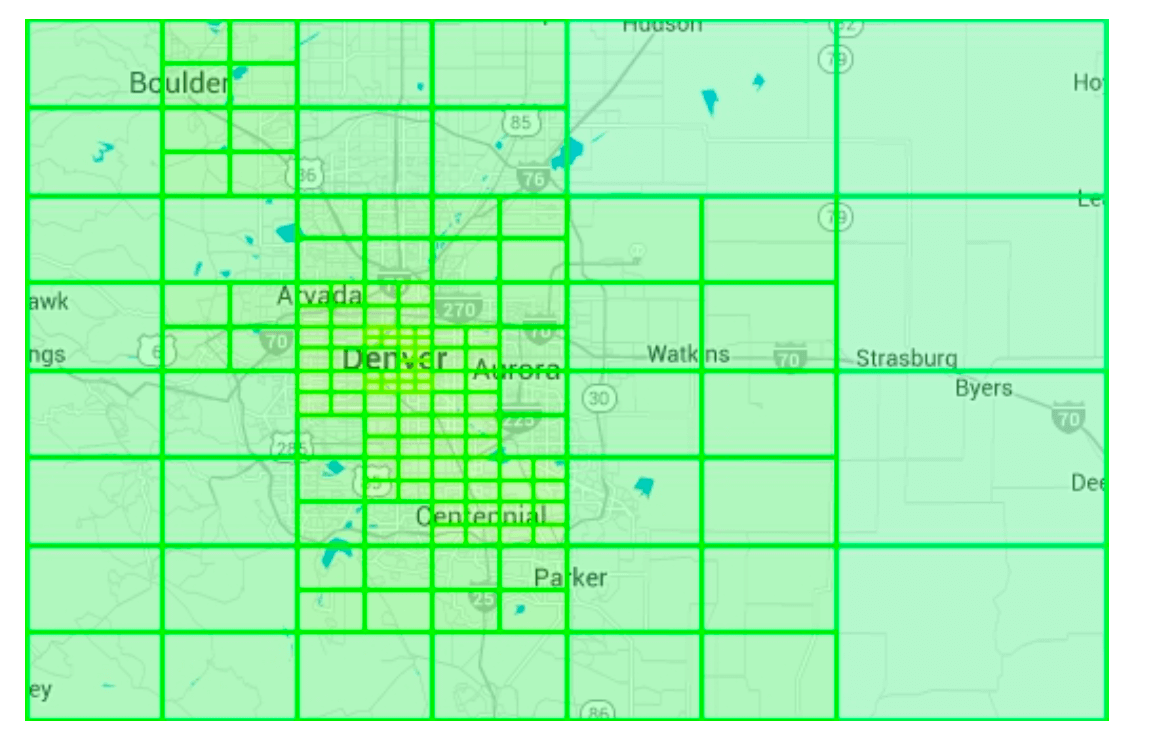
真实世界:自适应网格 真实城市里,四叉树长成密度自适应的样子:Boulder、Aurora、Parker 这些郊区格子很大,而 Denver 市中心被切成许多小格。切分只到「每格 ≤ 100 家」为止,因此密集处自然更深、稀疏处更浅,索引规模也不会失控。 科罗拉多 · 自适应网格 Denver 市中心 · 继续细分 Boulder Aurora Golden Parker 格 1 格 2 格 3 格 4 格子随密度自适应:郊区格子大,市中心格子小 只切到每格 ≤ 100 家,密集处自然更深 按 diagram-design 重绘 查看原图
运维考虑
对于大约 2 亿商家,在服务器启动时构建四叉树可能需要几分钟。
在四叉树构建期间无法提供流量,因此新版本应该逐步滚动发布到服务器的子集。
当更新商家或添加新商家时,最简单的方法是增量重建四叉树。(导致大量缓存失效)
也可以动态更新四叉树,但实现更复杂。(需要锁定机制)
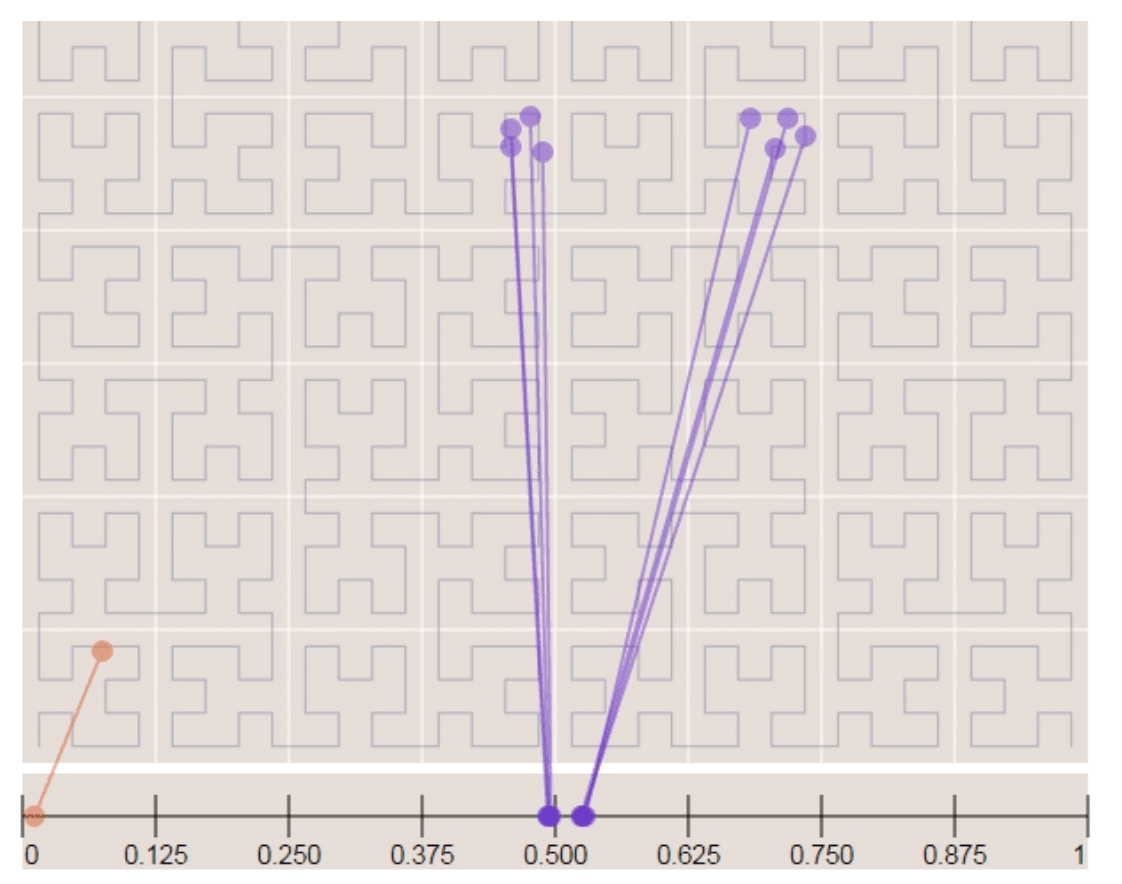
方案 5:Google S2 它将球体映射到基于希尔伯特曲线的 1D 索引。希尔伯特曲线上彼此接近的两个点在 1D 空间中也很接近。
Hilbert 曲线:二维映射到一维 Google S2 用 Hilbert 曲线把球面网格铺成一条一维曲线,给每个格子一个序号。曲线的关键性质是保局部性:在二维上彼此靠近的店(店 B、店 C),映射到一维后序号也相邻(0.50、0.58)。于是二维的「找附近」问题可以当成一维的范围查询来做。 二维平面(店铺位置) 一维 Hilbert 序号 店 A 店 B 店 C 店 D 0.42 0.50 0.58 0.66 Hilbert 曲线把二维网格铺成一条线 二维相邻的点,一维序号也相邻 → 可用一维范围查询找附近商家 按 diagram-design 重绘 查看原图 地理围栏与 S2 覆盖 地理围栏是一块任意形状的区域。S2 用 Hilbert 曲线把球面切成可变精度的格子,用若干粗细不同的格子拼出这块围栏——边缘处用细格贴合形状,内部用粗格节省数量。还能指定 min / max level 和最大格子数来控制覆盖精度与开销。 覆盖围栏的 S2 单元格 S2 格 · 粗 S2 格 · 粗 S2 格 · 粗 S2 格 · 粗 S2 格 · 细 S2 格 · 细 地理围栏区域 S2 用 Hilbert 曲线把球面切成可变精度的格子 能覆盖任意形状;可指定 min / max level 与最大格数 按 diagram-design 重绘 查看原图
使用希尔伯特曲线将地球划分为小单元 。非常适合地理围栏,因为它可以用不同级别覆盖任意区域。
地理围栏还允许定义围绕感兴趣区域的参数。
另一个优点是,在 S2 中,我们可以指定最小、最大级别和最大单元数,而不是使用固定的精度级别。
权衡对比
Geohash
易于使用和实现——无需构建/重建树
支持固定半径结果
更新索引很容易。
无法根据人口密度动态调整网格大小。
四叉树
实现稍微困难一些。
支持获取 k 个最近商家。
可以根据人口密度动态调整网格大小。
更新索引更复杂,因为可能需要重建整个树。
步骤 4:扩展数据库和缓存策略
扩展商家表
按商家 ID 分片 确保数据分布均匀。表中每个商家有单独的行。
Geohash
商家 ID
9q9hvu
343
9q9hvu
347
9q9hvu
112
扩展地理空间索引
对于 geohash 表可能不是一个好的分片选择。在这种情况下,所有内容都可以放在单个服务器上,因此没有技术上的分片理由。
更好的方法是使用只读副本来帮助分担读取负载。
缓存策略 最明显的缓存键选择是位置坐标,但它有几个问题:
GPS 的位置坐标不准确。
用户移动会导致位置坐标改变。
更好的键是 geohash。
缓存键
缓存值
geohash该网格中的商家 ID 列表
business_id商家详细信息(名称、地址、评论等)
步骤 5:部署策略和最终架构
区域和可用区 处理实时更新 最终系统架构
最终架构:检索附近商家的六步 用户把经纬度和半径发给负载均衡器,LB 转给 LBS;LBS 按半径算出 geohash 长度(500m → 6),再算出本格与 8 个相邻格,并行查 Geohash Redis 拿到商家 ID 列表,再查 Business Info Redis 取详情,按距离排序后返回。Business 服务只负责商家增删改,写入主库后异步复制到副本。 Redis 集群 数据库集群 · 主从复制 用户 搜索附近 负载均衡 LBS 服务 算 geohash Business 服务 商家详情 Geohash Redis Business Info Replica Replica Primary ① 请求 ② 转发 /businesses ⑤ 取 ID ⑥ 取详情 写入 复制 复制 ① 用户请求 → ② 转发给 LBS ③④ 算 geohash 与 8 个邻居 → ⑤⑥ 并行查 Redis → 按距离排序返回 按 diagram-design 重绘 查看原图 这个最终算法如下所示:
获取附近商家的步骤
用户请求:
用户搜索 500 米 内的餐厅。
客户端将 纬度 (37.776720)、经度 (-122.416730) 和半径 (500m) 发送到负载均衡器 。
请求转发:
负载均衡器 (LB) 将请求转发到基于位置的服务 (LBS) 。
Geohash 计算:
LBS 确定与半径匹配的 geohash 长度 。
使用参考表,500m 对应 geohash 长度 = 6 。
获取相邻 Geohash:
LBS 计算相邻 geohash 以包含附近区域。
结果是一个列表: [my_geohash, neighbor1_geohash, neighbor2_geohash, ..., neighbor8_geohash]
从 Redis 获取商家 ID:
对于列表中的每个 geohash,LBS 查询 Geohash Redis 服务器 以获取商家 ID 。
使用并行查询以最小化延迟。
检索并排序商家:
LBS 从商家信息 Redis 服务器 获取完整商家详情 。
根据用户位置的距离对商家进行排序 。
将排序结果 发送回客户端。
关键优化
并行 Redis 调用 :减少响应时间。 Geohash 索引 :确保高效的空间查询。 缓存 :加快商家数据的查找和检索。
这种方法确保了用户位置附近商家的低延迟、可扩展 检索。
选择最佳索引方法
索引方法
优点
缺点
Geohash 易于实现,对邻近搜索高效
边界问题,固定网格大小
四叉树 动态调整密度,支持 k 近邻查询
更复杂,需要树重新平衡
Google S2 高级地理围栏,用于 Google Maps
更难实现
参考资料
Geohash 算法 四叉树索引 Google S2 几何
第 17 章:附近好友
引言
本章重点设计一个可扩展的后端,用于支持用户分享位置并发现附近 的好友。
与邻近位置那一章的主要区别在于,本问题中位置不断变化 ,而那一章中商家地址基本保持不变。
步骤 1:理解问题并确定设计范围
一些用于引导面试的问题:
候选人:地理上多近才算“附近”?
面试官:5 英里,这个数字应可配置。
候选人:距离是按直线距离计算,还是要考虑例如朋友之间隔着一条河?
面试官:是的,这个假设是合理的。
候选人:这个应用有多少用户?
面试官:1bil 用户,其中 10% 使用附近好友功能。
候选人:我们需要存储位置历史记录吗?
面试官:需要,它可能对机器学习等场景很有价值。
候选人:我们能否假设不活跃的好友会在 10 分钟后从该功能中消失?
面试官:可以。
候选人:我们需要担心 GDPR 等法规吗?
面试官:不用,为简单起见。
功能需求
用户应能在移动应用中看到附近的好友。每个好友都有距离和时间戳,表示位置最后更新的时间。
附近好友列表应每隔几秒更新一次。
非功能需求
低延迟 :接收位置更新时不能有太多延迟,这一点很重要。可靠性 :偶尔丢失数据点是可以接受的,但系统应总体可用。最终一致性 :位置数据存储不需要强一致性。不同副本之间接收位置数据有几秒延迟是可以接受的。
粗略估算 一些用于确定潜在规模的估算:
附近好友是指 5 英里半径范围内的好友。
位置刷新间隔为 30 秒。人类步行速度较慢,因此不需要太频繁地更新位置。
平均每天有 100mil 用户使用该功能,其中 10% 为并发用户,即 10mil。
平均而言,一个用户有 400 个好友,且这些好友都使用附近好友功能。
应用每页显示 20 个附近好友。
位置更新 QPS = 10mil / 30 == ~334k 次更新/秒。
步骤 2:提出高层设计并获得认可
在探讨 API 和数据模型设计之前,我们先研究将要使用的通信协议,因为它不像传统的请求-响应通信模型那样常见。
高层设计 在高层次上,我们希望在对等端之间建立高效的消息传递。这可以通过点对点协议实现,但对于连接不稳定且功耗限制严格的移动应用来说并不现实。
更实际的方法是使用共享后端作为向你想触达的好友进行扇出的机制:
后端作为扇出中枢 移动端不直连好友(P2P 在弱网与省电约束下不现实),而是把位置更新发给共享后端;后端收到后找出所有应收到该更新的在线好友,把位置转发给他们。转发前先比较距离,超出配置阈值的直接丢弃。 用户 上报位置 后端 扇出 好友 A 好友 B 好友 C 位置更新 后端把位置更新扇出给距离阈值内的好友 按 diagram-design 重绘 查看原图 后端做什么?
接收所有活跃用户的位置更新。
对于每个位置更新,找到所有应接收该更新的活跃用户,并将其转发给他们。
如果好友之间的距离超过配置的阈值,则不转发位置数据。
这听起来很简单,但挑战在于要针对我们所处的规模来设计系统。
我们先从一个较简单的设计开始,在深入探讨部分再讨论更高级的方案:
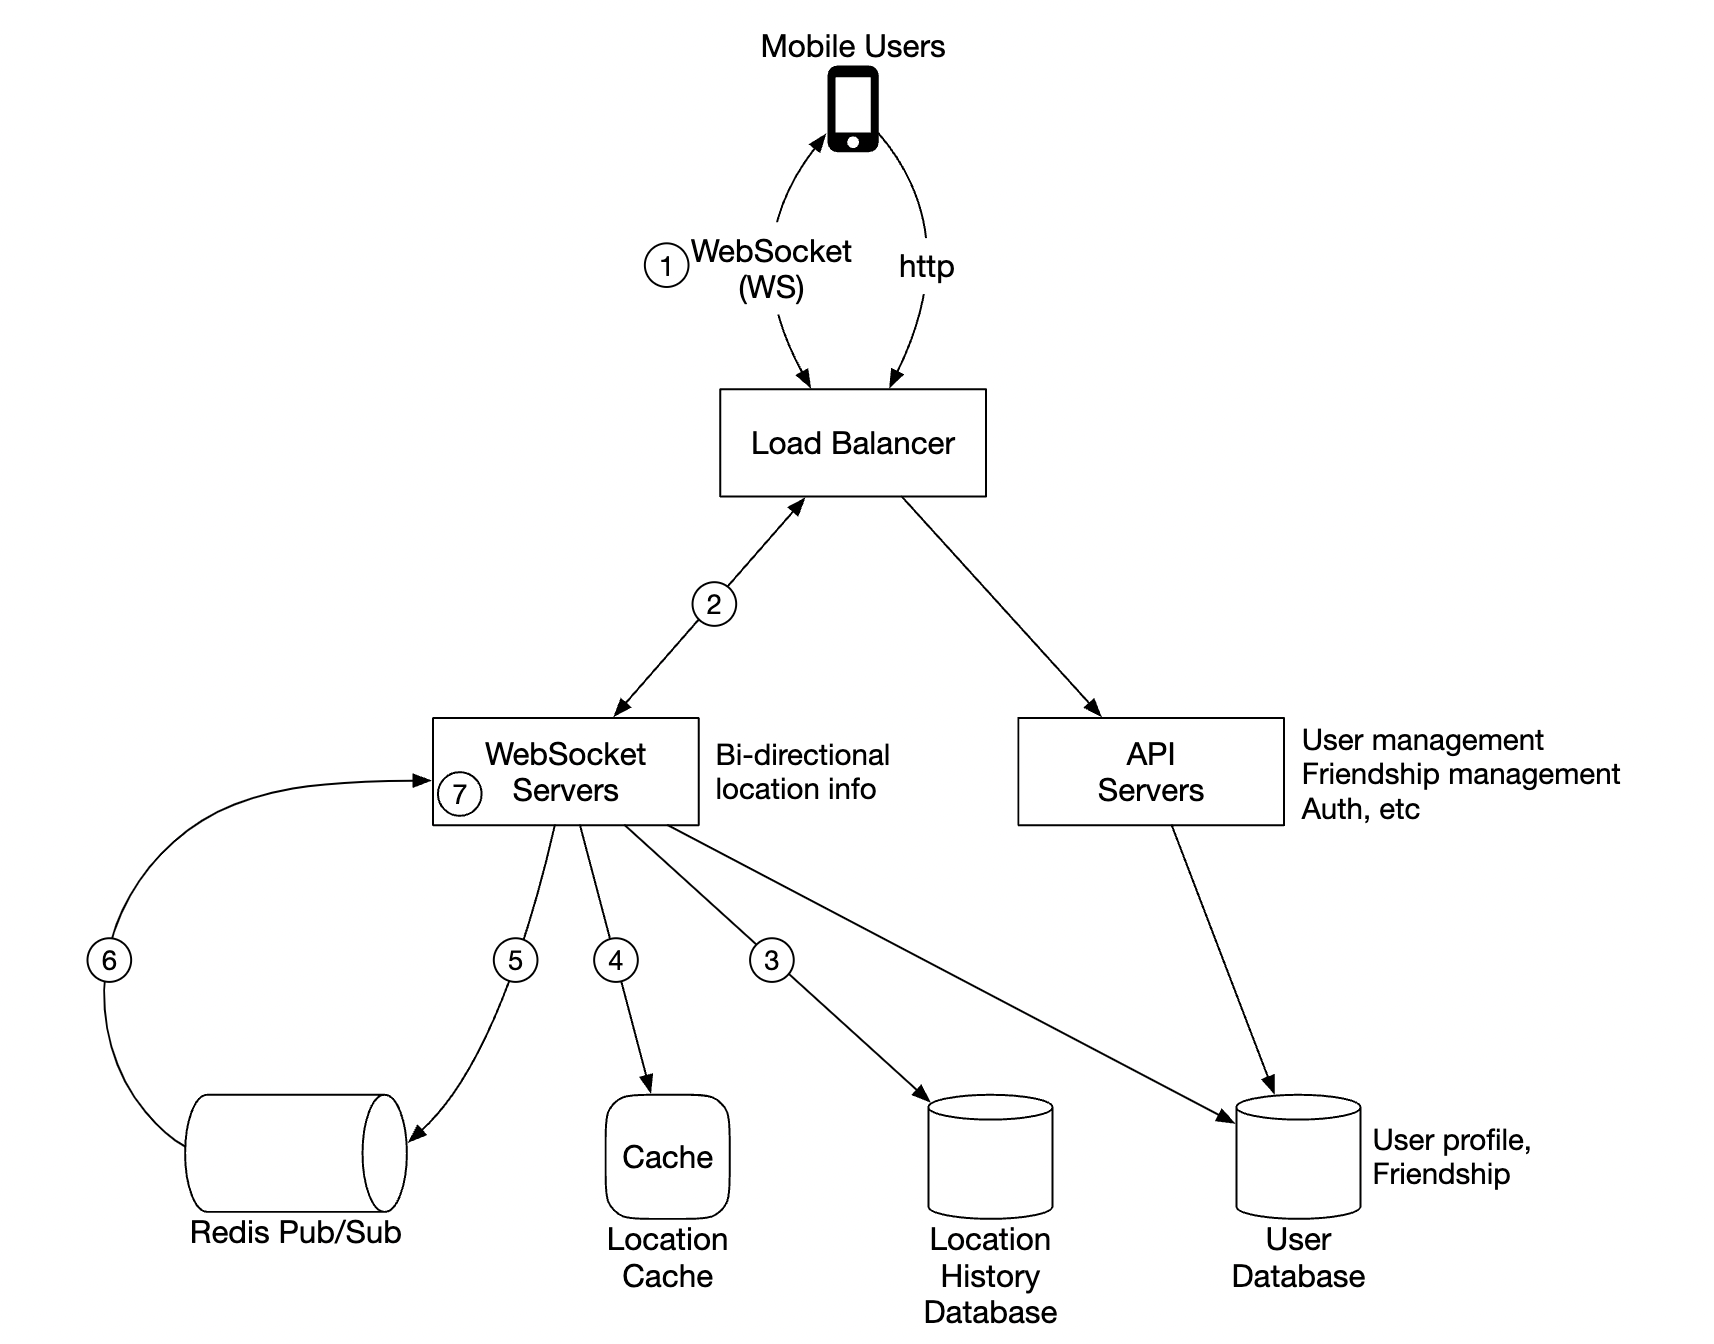
简单高层设计 移动用户经负载均衡器接入:位置类实时流量走 WebSocket 长连接,好友与资料管理等辅助请求走 HTTP 的 API 服务器。WebSocket 服务器把位置写入 Redis 位置缓存(带 TTL)与位置历史库,并通过 Redis Pub/Sub 广播;API 服务器读写用户库。 移动用户 位置更新 负载均衡 WebSocket 服务器 双向位置流 API 服务器 好友 / 资料 Redis Pub/Sub 频道广播 位置缓存 最新位置 位置历史库 写入历史 用户库 资料 / 好友 WS / http 转发 http 发布 写缓存 写历史 读资料 读写 位置走 WS 长连接,管理走 http TTL 过期即视为离线 按 diagram-design 重绘 查看原图
负载均衡器 :将流量分发到 REST API 服务器以及双向 WebSocket 服务器。REST API 服务器 :处理辅助任务,例如管理好友、更新个人资料等。WebSocket 服务器 :有状态服务器,将位置更新请求转发给相应的客户端。它还负责在初始化时向移动客户端下发附近好友的位置(稍后详细讨论)。Redis 位置缓存 :用于存储每个活跃用户的最新位置数据。缓存中的每个条目都设置了 TTL。TTL 过期后,用户不再活跃,其数据会从缓存中移除。用户数据库 :存储用户和好友关系数据。这里可以使用关系型数据库或 NoSQL 数据库。位置历史数据库 :存储用户位置数据的历史记录,不一定直接用于附近好友功能,而是用于跟踪历史数据以进行分析。Redis 发布/订阅 :用作轻量级消息总线,为每个用户频道提供不同的主题,用于位置更新。
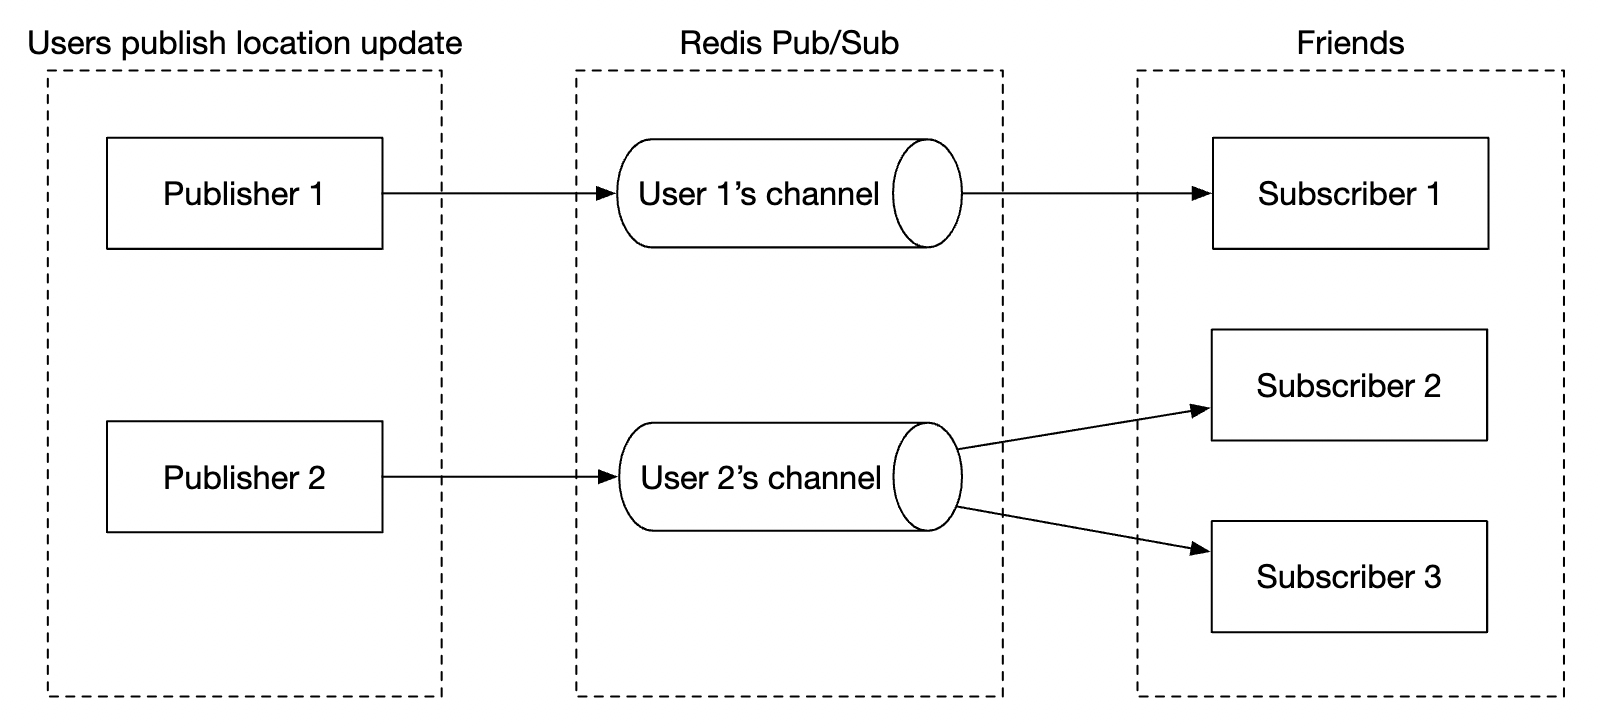
Redis Pub/Sub 的用法 发布者把位置更新写进对应用户的频道,Redis Pub/Sub 再把消息广播给该频道的所有订阅者——即负责这些好友的 WebSocket 服务器。一个用户一个频道,频道在无人订阅时不占内存。 用户发布位置更新 Redis Pub/Sub 好友 发布者 1 发布者 2 用户 1 的频道 用户 2 的频道 订阅者 1 订阅者 2 订阅者 3 发布 发布 推送 推送 每个用户一个频道,发布后广播给所有订阅者 按 diagram-design 重绘 查看原图 在上面的示例中,WebSocket 服务器订阅与它们所连接用户相关的频道,并在收到位置更新时将其转发给相应的用户。
周期性位置更新 以下是周期性位置更新流程的工作方式:
周期性位置更新的写路径 ① 移动端把位置更新发给负载均衡器;② 负载均衡器转给该客户端的 WebSocket 长连接;③ WebSocket 服务器把位置写入位置历史库;④ 更新位置缓存并在内存中留一份用于后续距离计算;⑤ 通过 Redis Pub/Sub 把位置发布到该用户的频道。 移动用户 位置更新 负载均衡 WebSocket 服务器 处理与扩散 位置历史库 位置缓存 Redis Pub/Sub ① 上报 ② 转发 ③ 写历史 ④ 写缓存 ⑤ 发布 ⑥ Pub/Sub 广播回订阅的 WS 服务器,⑦ 再推给附近好友 按 diagram-design 重绘 查看原图
移动客户端向负载均衡器发送位置更新。
负载均衡器将位置更新转发到该客户端的 WebSocket 服务器持久连接。
WebSocket 服务器将位置数据保存到位置历史数据库。
位置数据在位置缓存中更新。WebSocket 服务器还会将该位置数据保存在内存中,以便后续为该用户进行距离计算。
WebSocket 服务器通过 Redis 发布/订阅将位置数据发布到该用户的频道。
Redis 发布/订阅将位置更新广播给该用户频道的所有订阅者,即负责该用户好友的服务器。
订阅的 WebSocket 服务器收到位置更新,计算应将更新发送给哪些用户,并发送更新。
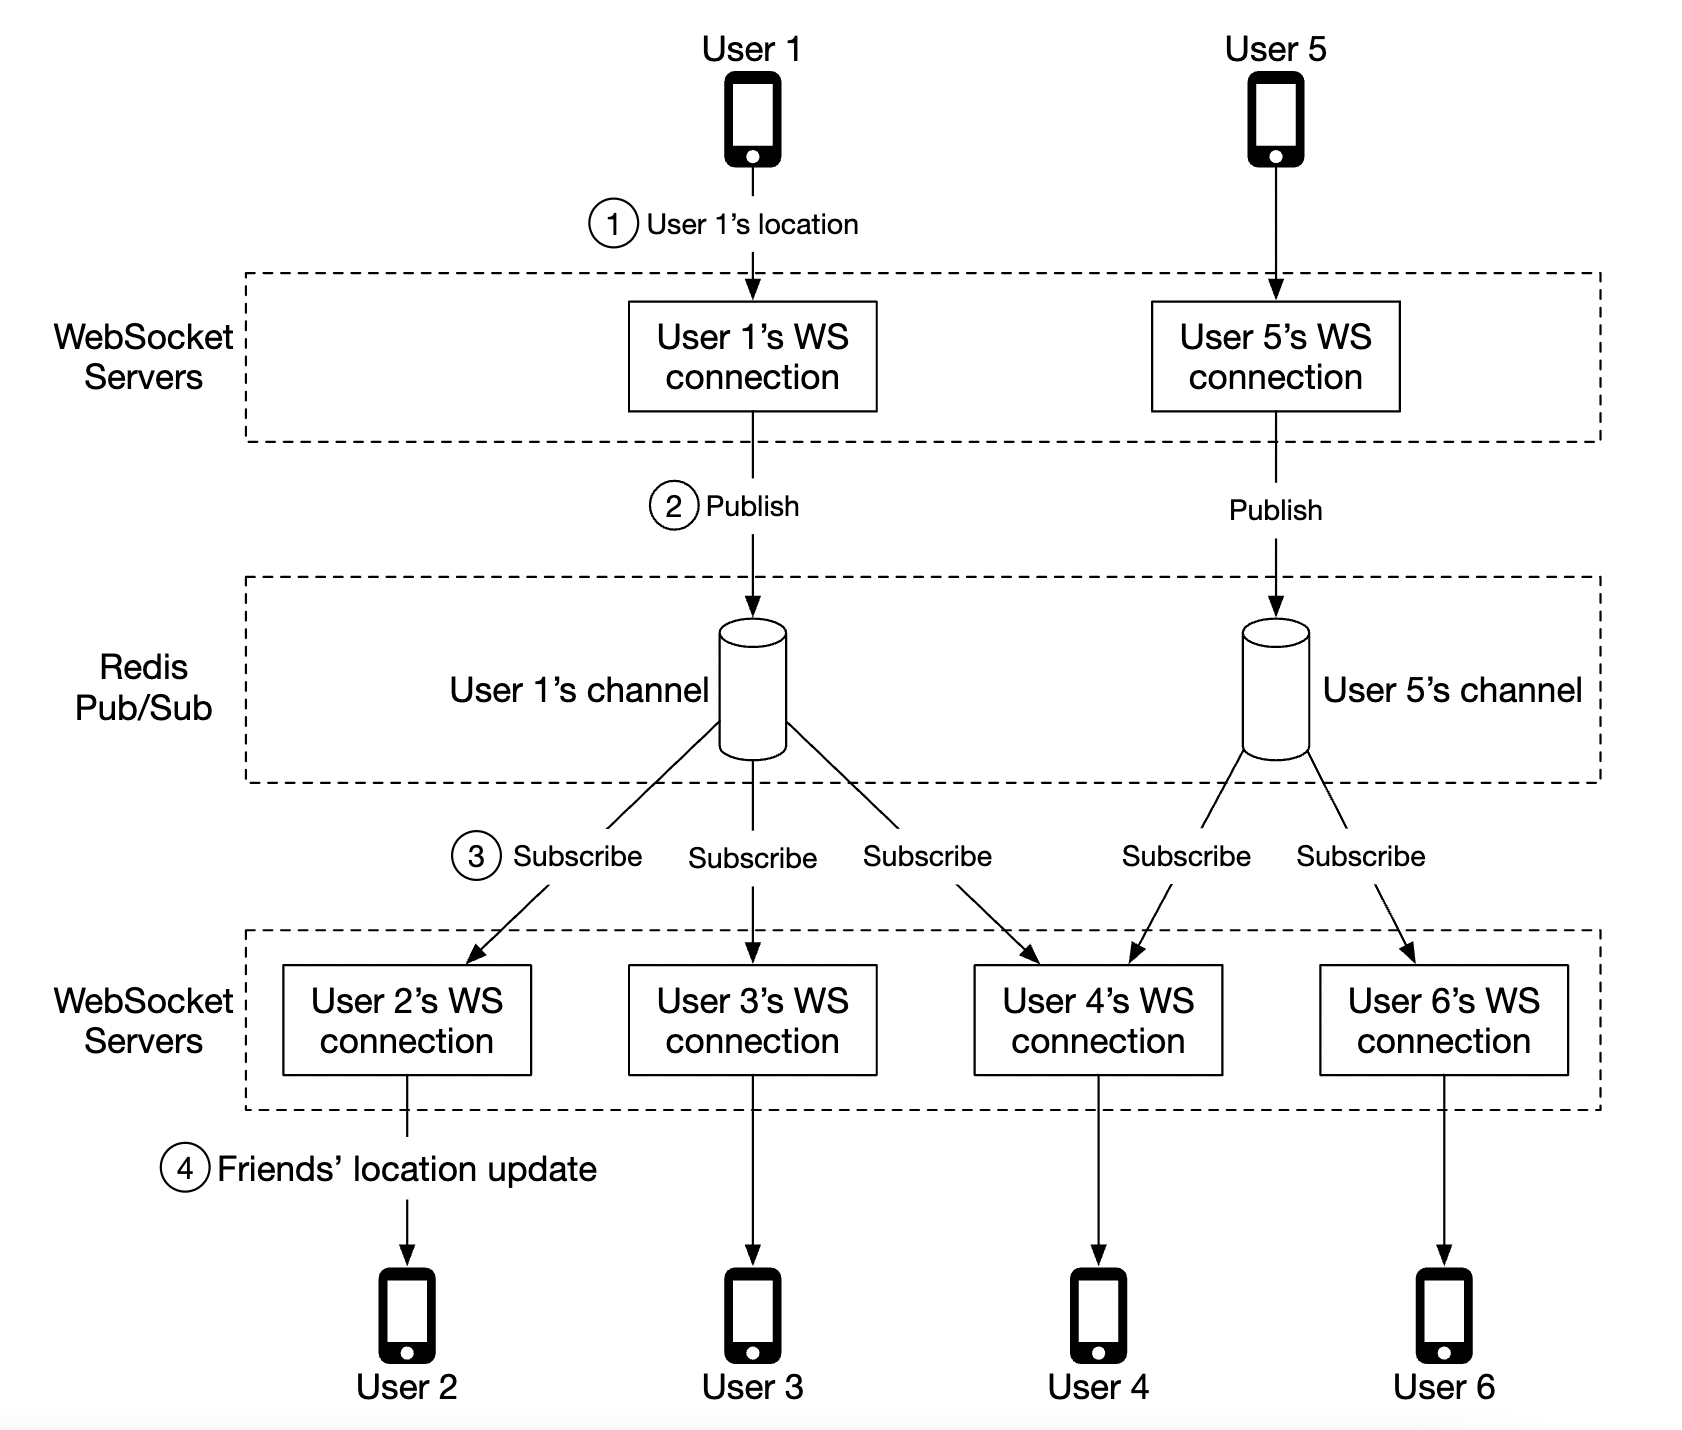
以下为同一流程的更详细版本:
详细版:发布 / 订阅与好友推送 ① 用户 1 与用户 5 把位置上报到各自的 WS 连接;② WS 连接把位置发布到各自在 Redis Pub/Sub 里的频道;③ 频道把消息广播给订阅了它的 WS 连接(用户 1 的频道被用户 2/3/4 的连接订阅,用户 5 的频道被用户 4/6 的连接订阅);④ 各连接再把好友位置更新推给对应的移动端。 WebSocket 服务器 Redis Pub/Sub WebSocket 服务器 用户 1 上报位置 用户 5 用户 1 的 WS 连接 用户 5 的 WS 连接 用户 1 的频道 用户 5 的频道 用户 2 的 WS 连接 用户 3 的 WS 连接 用户 4 的 WS 连接 用户 6 的 WS 连接 用户 2 用户 3 用户 4 用户 6 ① 上报位置 ② 发布 ③ 订阅 ④ 推给好友 按 diagram-design 重绘 查看原图 平均而言,需要转发 40 个位置更新,因为一个用户平均有 400 个好友,其中 10% 同时在线。
API 设计 我们需要支持的 WebSocket 例程:
周期性位置更新——用户向 WebSocket 服务器发送位置数据。
客户端接收位置更新——服务器发送好友的位置数据和时间戳。
WebSocket 客户端初始化——客户端发送用户位置,服务器返回附近好友的位置数据。
订阅新好友——WebSocket 服务器发送一个好友 ID,移动客户端应跟踪该好友,例如当好友首次上线时。
取消订阅好友——WebSocket 服务器发送一个好友 ID,移动客户端应取消订阅,例如当好友下线时。
HTTP API——用于辅助职责的传统请求/响应载荷。
数据模型
位置缓存将存储 user_id 与 lat,long,timestamp 之间的映射。Redis 是这个缓存的好选择,因为我们只关心当前位置,并且它支持我们用例所需的 TTL 淘汰。
位置历史表存储相同的数据,但放在关系型表中,包含上述四列。Cassandra 可用于这些数据,因为它针对写入密集型负载进行了优化。
步骤 3:设计深入探讨
让我们讨论如何扩展高层设计,使其在我们目标规模下正常工作。
各组件的可扩展性如何?
API 服务器 :可以通过自动扩缩组和复制服务器实例轻松扩展。WebSocket 服务器 :我们可以轻松横向扩展 WebSocket 服务器,但在关闭某台服务器时需要优雅地关闭现有连接。例如,我们可以在负载均衡器中将服务器标记为“排空”,并停止向其发送连接,然后再将其从服务器池中最终移除。客户端初始化 :当客户端首次连接到服务器时,它会获取用户的好友列表,在 Redis 发布/订阅上订阅这些好友的频道,从缓存中获取他们的位置,最后转发给客户端。用户数据库 :我们可以根据 user_id 对数据库进行分片。还可以通过专门的服务和 API 暴露用户/好友数据,并由专门团队管理。位置缓存 :我们可以通过启动多个 Redis 节点轻松对缓存进行分片。同时,TTL 限制了我们某一时刻可能占用的最大内存。但我们仍需要处理大量的写入负载。Redis 发布/订阅服务器 :我们利用这一特性:如果频道已初始化但未使用,则不会消耗内存。因此,我们可以为所有使用附近好友功能的用户预分配频道,避免在用户上线时需要创建新频道并通知活跃 WebSocket 服务器。
Redis 发布/订阅组件的扩展深入探讨 我们需要大约 200GB 内存来维护所有发布/订阅频道。这可以通过使用 2 台各 100GB 的 Redis 服务器实现。
考虑到我们每秒需要推送约 14mil 次位置更新,假设单台服务器每秒可处理约 100k 次推送,我们至少需要 140 台 Redis 服务器来处理这样的负载。
因此,我们需要一个分布式 Redis 服务器集群来应对高 CPU 负载。
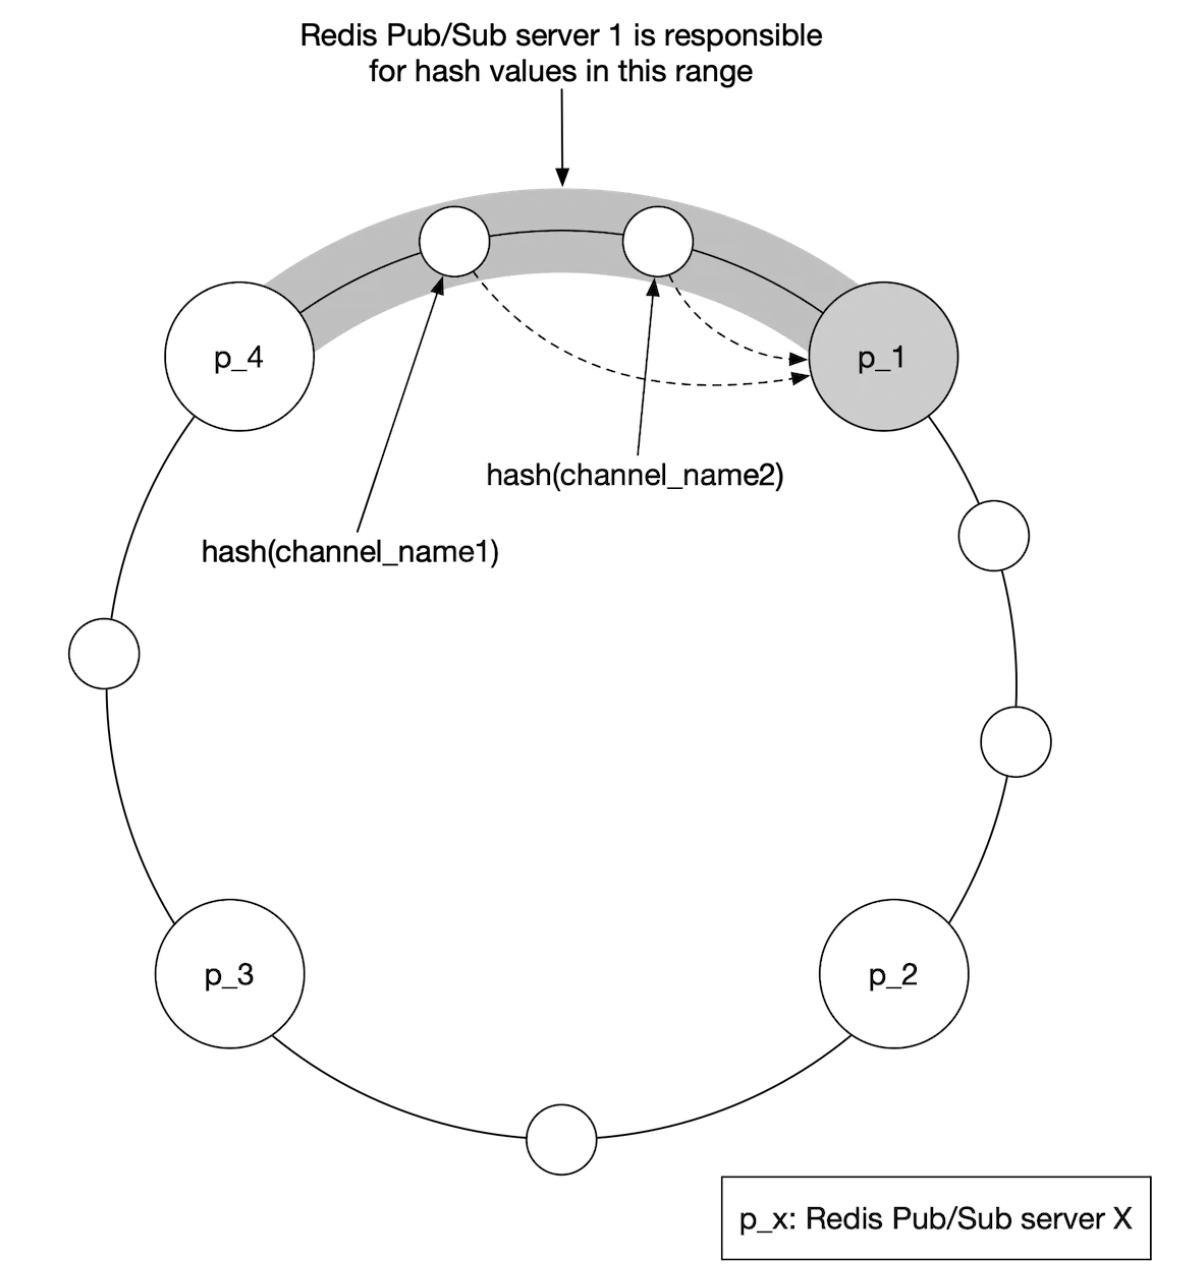
为了支持分布式 Redis 集群,我们需要使用服务发现组件(例如 ZooKeeper 或 etcd)来跟踪哪些服务器是存活的。
我们需要在服务发现组件中编码的数据如下:
频道分布数据 服务发现组件(zookeeper / etcd)里存着一份哈希环数据:它记录每个 Redis Pub/Sub 服务器负责哪一段哈希区间。WebSocket 服务器把这份数据拉到本地缓存,就能直接算出某个频道落在哪台服务器上。 哈希环(展开) p_4 p_1 p_2 p_3 频道名 hash(key) hash(channel) 服务器 p_1 负责该区间的哈希值 p_x: Redis Pub/Sub 服务器 X 按 diagram-design 重绘 查看原图 WebSocket 服务器使用从 ZooKeeper 获取的编码数据来确定特定频道所在的位置。为了提高效率,哈希环数据可以缓存在每个 WebSocket 服务器的内存中。
在集群扩缩容方面,我们可以设置一个每日任务,根据历史流量数据按需扩展集群。我们也可以超额配置集群以应对负载峰值。
Redis 集群可被视为有状态存储服务器,因为频道中维护了一些状态,并且需要与订阅者协调,以便它们切换到集群中新配置的节点。
我们必须注意扩缩容操作期间的一些潜在问题:
由于频道会被迁移,WebSocket 服务器会产生大量重新订阅请求。
在操作期间,客户端可能会错过一些位置更新,这在本问题中是可以接受的,但我们仍应尽量减少这种情况。考虑在一天中流量最低的时候进行此类操作。
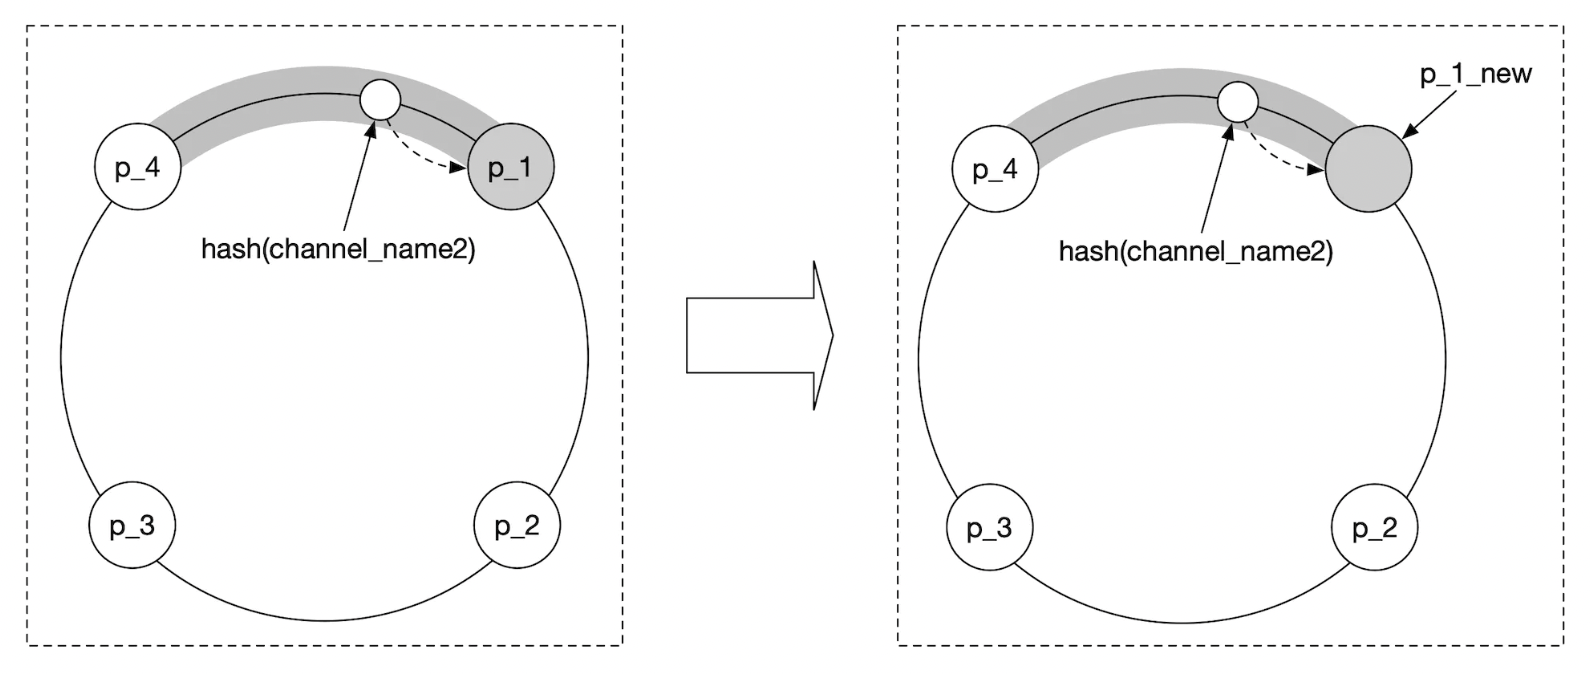
我们可以利用一致性哈希,在增加/删除服务器时尽量减少需要迁移的频道数量。
一致性哈希:扩容只迁移一小段 给 Redis Pub/Sub 集群加一台服务器 p_1_new 时,用一致性哈希只需把「p_4 与 p_1_new 之间」那一段区间的频道重新映射过去,其余频道原地不动。相比取模,扩容触发的重新订阅请求被压到最小。 扩容前 扩容后 p_4 p_1 p_2 p_3 p_4 p_1_new p_2 p_3 新增 → 受影响:p_4 与 p_1 之间的频道迁移到新节点 按 diagram-design 重绘 查看原图 添加/删除好友 每当添加或删除好友时,负责受影响用户的 WebSocket 服务器需要在好友频道上订阅/取消订阅。
由于“附近好友”功能是更大应用的一部分,我们可以假设当这些事件发生时,移动客户端侧可以注册回调,客户端会向 WebSocket 服务器发送消息以执行相应操作。
拥有大量好友的用户 我们可以对用户可拥有的好友总数设置上限,例如 Facebook 最多有 5000 个好友。
处理“鲸鱼”用户的 WebSocket 服务器可能会有更高的负载,但只要我们有足够的 WebSocket 服务器,应该没有问题。
附近的随机陌生人 如果面试官想更新设计,增加一个功能:偶尔在附近好友地图上看到随机出现的陌生人,该怎么办?
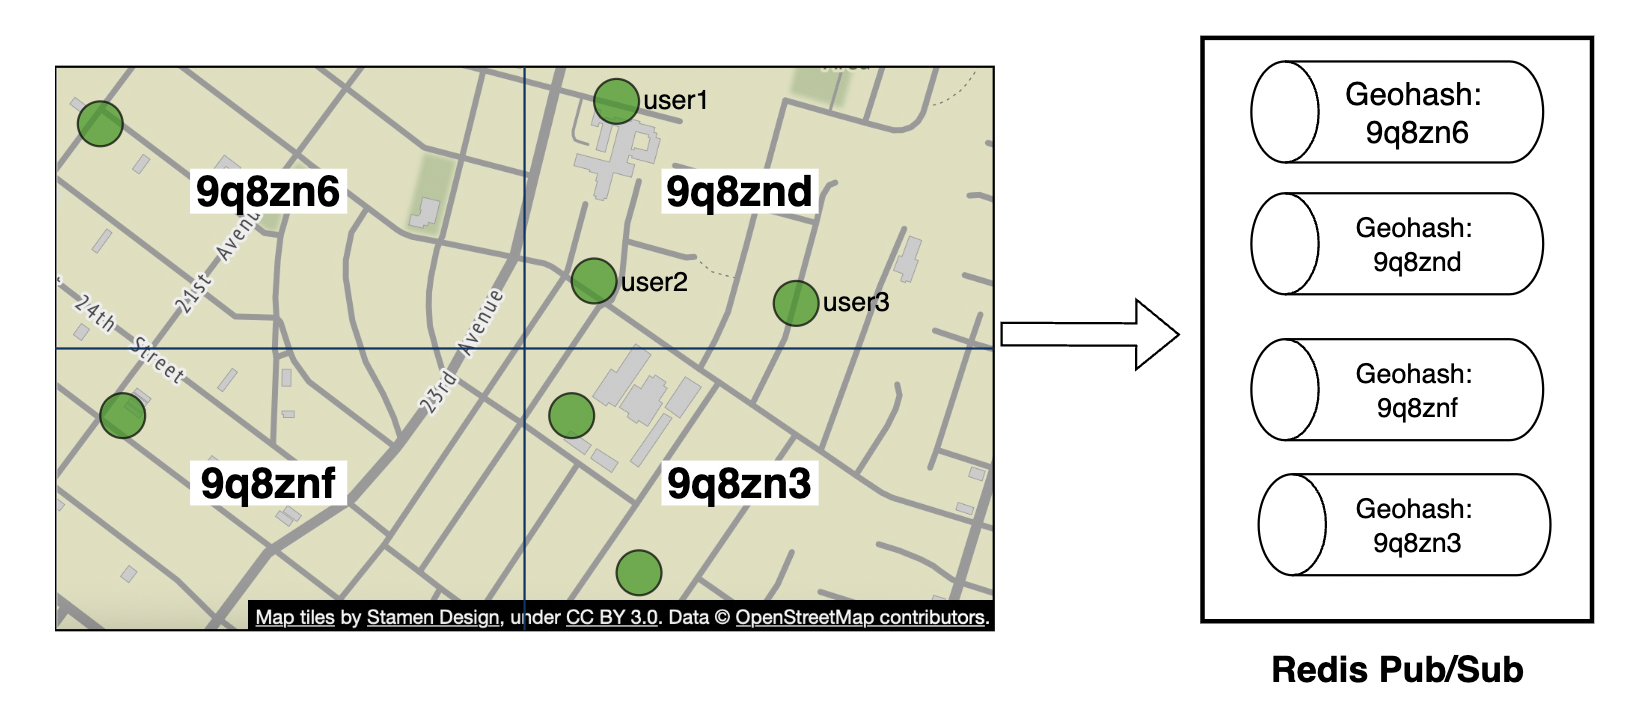
一种处理方法是基于 Geohash 定义一组发布/订阅频道:
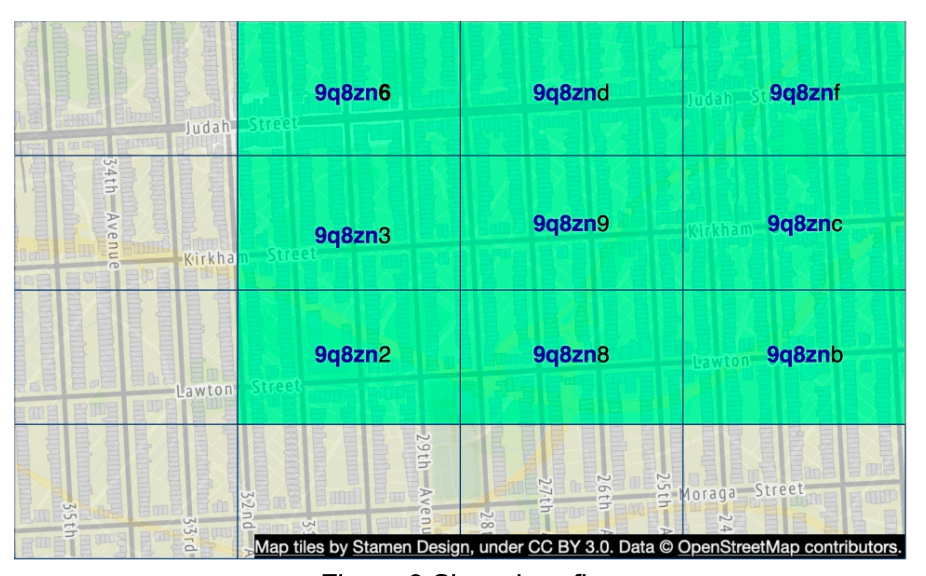
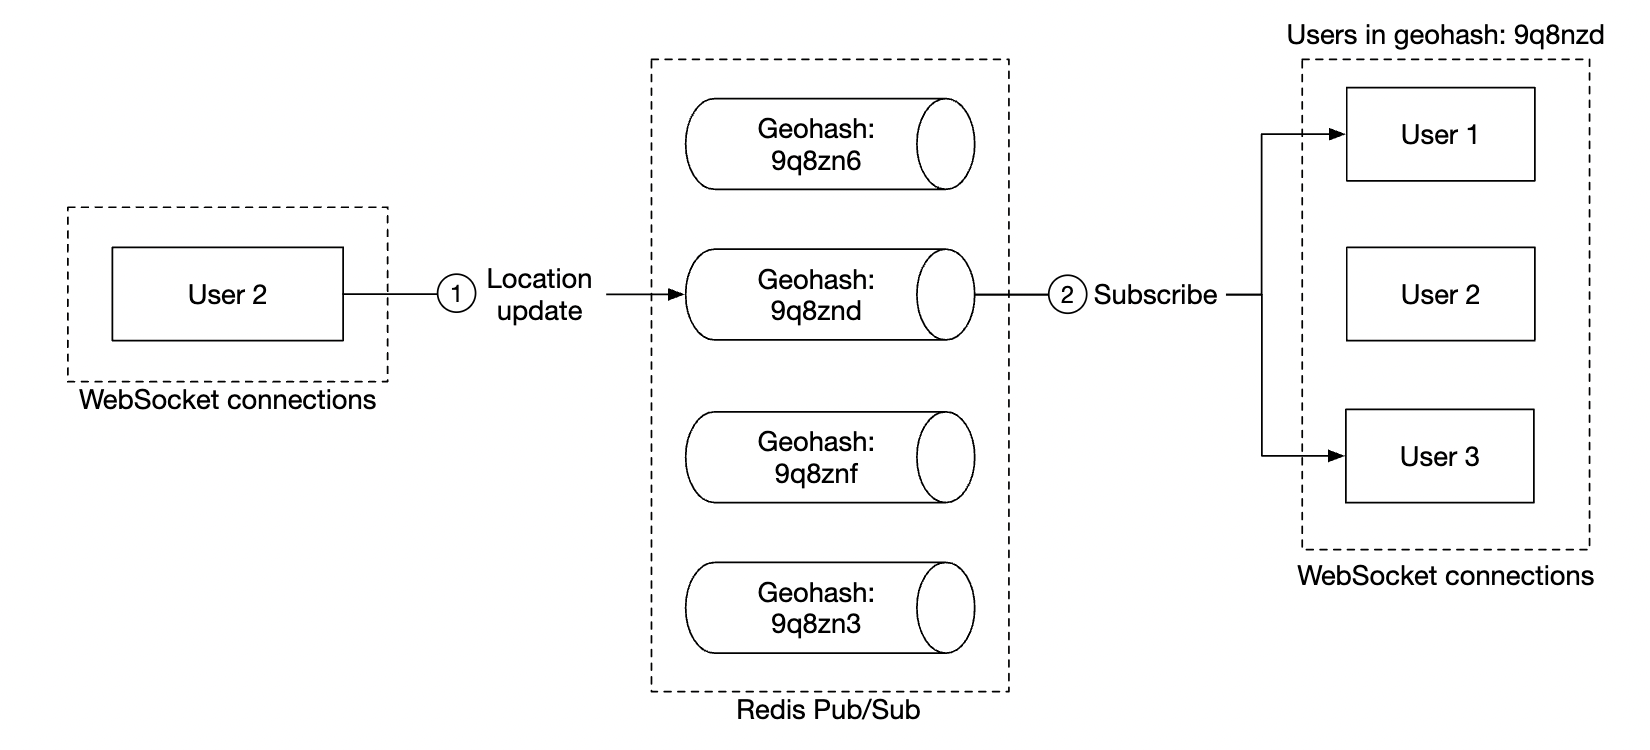
按 geohash 建频道 为了支持「附近随机的人」,把地图按 geohash 切成网格,每个格子对应一个 Redis Pub/Sub 频道。落在同一格里的用户订阅同一个频道,就能收到格内其他人的位置更新。 地图网格 Redis Pub/Sub 9q8zn6 1 用户 9q8znd 3 用户 9q8znf 1 用户 9q8zn3 1 用户 Geohash: 9q8zn6 Geohash: 9q8znd Geohash: 9q8znf Geohash: 9q8zn3 地图按 geohash 切格,每格对应一个频道 → 按 diagram-design 重绘 查看原图 在同一个 Geohash 内的任何人都订阅相应频道,以接收随机用户的位置更新:
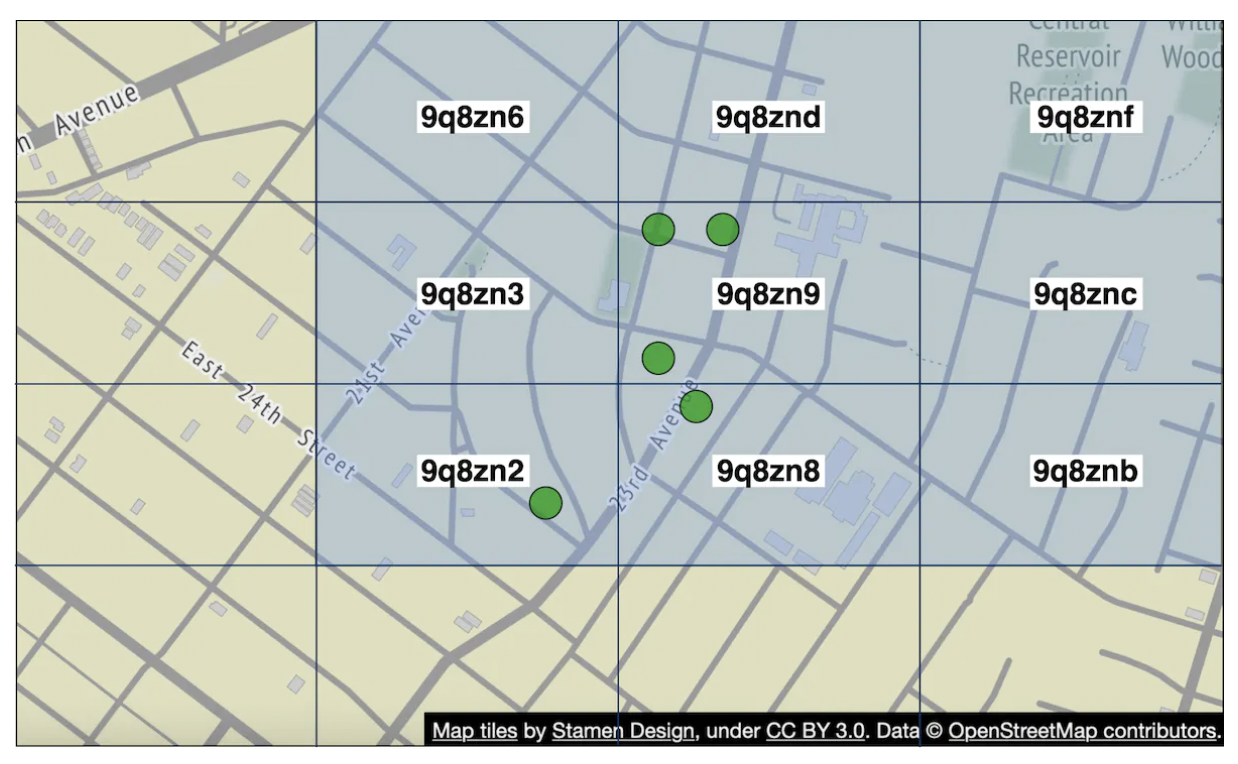
geohash 频道的位置更新流 用户 2 的位置更新经 WebSocket 连接上报(①),发布到它所在 geohash(9q8znd)对应的频道;该频道再把更新广播给所有订阅者(②)——即 geohash 9q8znd 内其他用户的连接,由它们推给各自的移动端。 WebSocket 连接 Redis Pub/Sub geohash 9q8znd 内的用户 用户 2 Geohash: 9q8zn6 Geohash: 9q8znd Geohash: 9q8znf Geohash: 9q8zn3 用户 1 用户 2 用户 3 ① 位置更新 ② 订阅 按 geohash 建频道,边界附近多订阅相邻格 按 diagram-design 重绘 查看原图 我们还可以订阅多个 Geohash,以处理某人很近但位于相邻 Geohash 的情况:
geohash 边界:多订阅相邻格 用户若正好处在格子边界附近,只订阅本格频道会漏掉紧邻格里的好友。做法是同时订阅相邻的 geohash 频道,最多覆盖周围 3×3 个格子,从而补齐跨格的好友位置。 geohash 网格 9q8zn6 9q8znd 9q8znf 9q8zn3 9q8zn9 9q8znc 9q8zn2 9q8zn8 9q8znb 用户靠近边界时, 同时订阅相邻 geohash 频道 最多覆盖周围 3×3 个格子 按 diagram-design 重绘 查看原图 Redis 发布/订阅的替代方案 使用 Redis 进行发布/订阅的替代方案是采用 Erlang——一种为分布式计算应用优化过的通用编程语言。
使用它,我们可以创建数百万个相互通信的小型 Erlang 进程。我们可以在分布式 Erlang 应用中同时处理 WebSocket 连接和发布/订阅频道。
不过,使用 Erlang 的一个挑战是它是一门小众编程语言,很难招聘到优秀的 Erlang 开发人员。
步骤 4:总结
我们成功设计了一个支持附近好友功能的系统。
核心组件:
WebSocket 服务器 :客户端和服务器之间的实时通信。Redis :位置数据的快速读写 + 发布/订阅频道。
我们还探讨了如何扩展 RESTful API 服务器、WebSocket 服务器、数据层、Redis 发布/订阅服务器,还探讨了 Redis 发布/订阅的替代方案。我们还探讨了“附近随机陌生人”功能。
第 18 章:Google Maps
引言
我们将设计一个简化版 Google Maps 。
关于 Google Maps 的一些事实:
2005 年推出
提供多种服务——卫星图像、街道地图、实时路况、路线规划
到 2021 年,日活跃用户达 1bil,覆盖全球 99%,每日 25mil 条实时位置信息更新
第 1 步:理解问题并确定设计范围
候选人与面试官之间的问答示例:
C:我们面对多少日活跃用户?
I:1bil DAU
C:我们应该关注哪些功能?
I:位置更新、导航、ETA、地图渲染
C:道路数据有多大?我们能访问吗?
I:我们从多种来源获取了道路数据,原始数据有 TB 级
C:我们要考虑交通状况吗?
I:要,这样时间估算才准确
C:不同出行方式——步行、骑行、驾车?
I:应该支持
C:多途经点路线呢?
I:面试范围内先不关注
C:商业场所和照片?
I:好问题,但不必考虑
我们将重点放在三个关键特性上——用户位置更新、包含 ETA 的导航服务以及地图渲染。
非功能需求
准确性 :用户不应得到错误路线导航流畅 :用户应体验流畅的地图渲染数据和电量消耗 :客户端应尽可能少地消耗数据和电量。对移动设备很重要。常规的可用性和可扩展性要求
地图基础 在进入设计之前,有一些与地图相关的概念需要了解。
定位系统
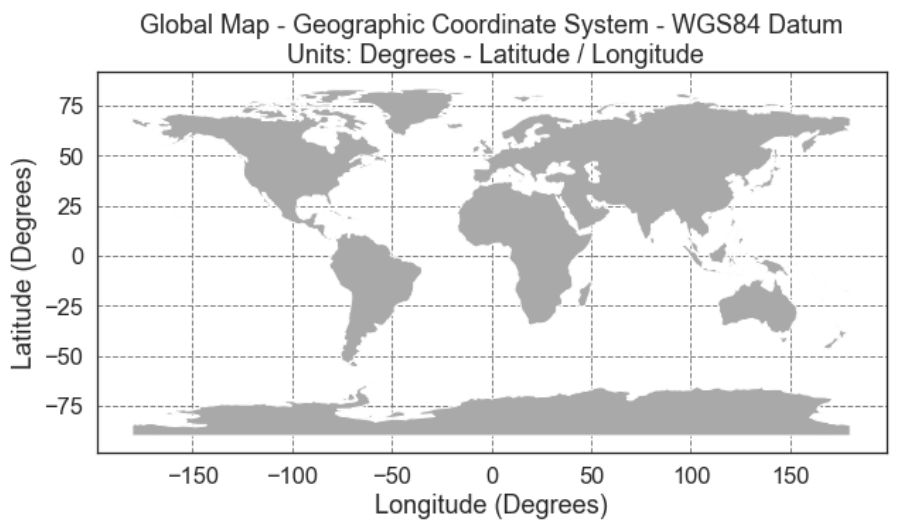
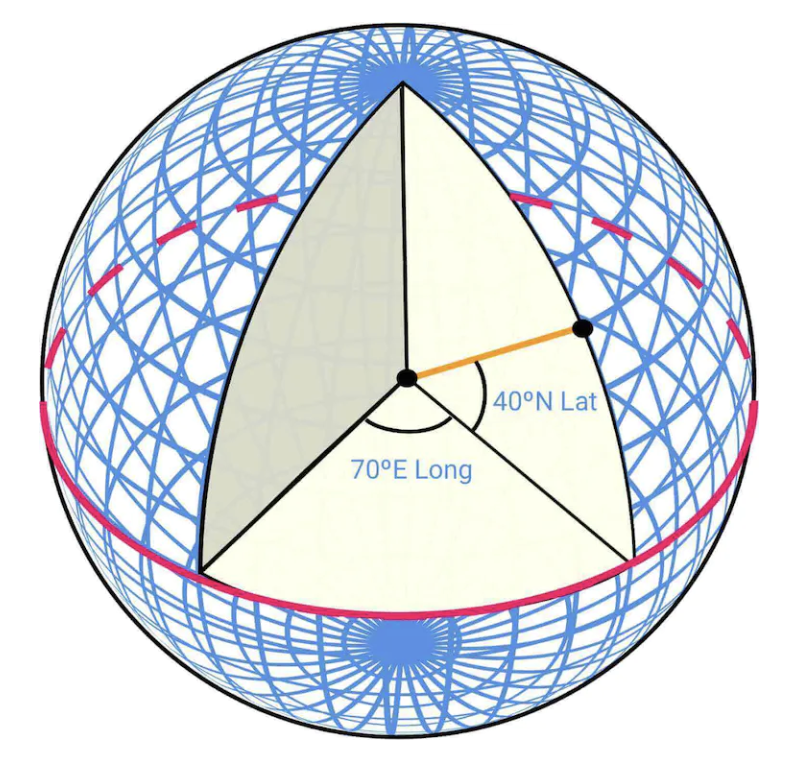
世界是一个绕地轴旋转的球体。位置由纬度(表示南北位置)和经度(表示东西位置)定义:
球面定位系统 地球是一个自转的球体,位置由两个角度定义:纬度表示南北(±90°),经度表示东西(±180°)。两者合起来给出球面上唯一的一个点。 地球 球体 经纬度 lat / long 定位 纬度:南北 ±90°;经度:东西 ±180° 例:40°N, 70°E 按 diagram-design 重绘 查看原图 从 3D 到 2D
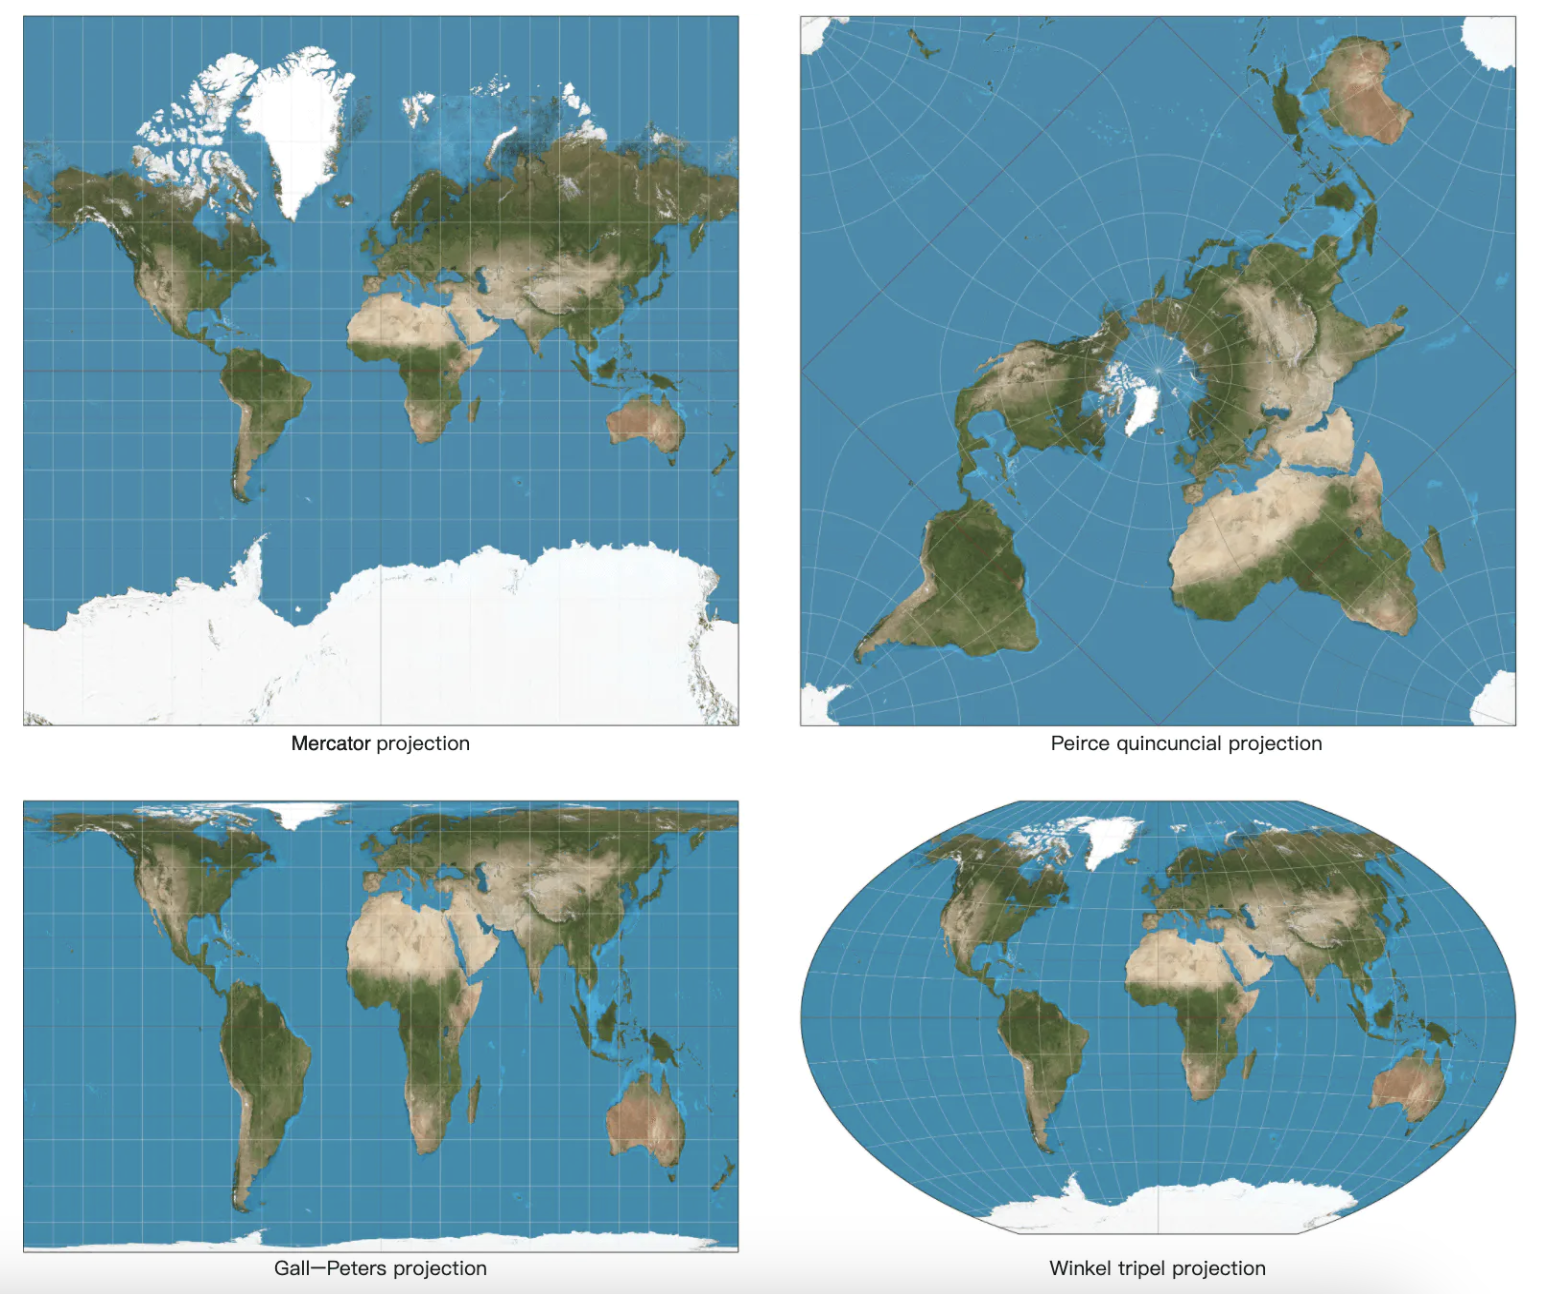
将点从 3D 转换到 2D 平面的过程称为“地图投影”。
有多种投影方式,各有优缺点。几乎所有投影都会扭曲真实的几何形状。
常见地图投影 把 3D 球面摊到 2D 平面叫地图投影,几乎没有不失真的做法,差别只在牺牲什么。墨卡托保角(放大两极)、高尔-彼得斯保面积、皮尔斯五方与温克尔三倍则试图折中,各有取舍。 墨卡托投影 皮尔斯五方投影 高尔-彼得斯投影 温克尔三倍投影 保角 / 保面积 / 折中,几乎都会产生形变 Google 地图采用 Web Mercator(墨卡托改良版) 按 diagram-design 重绘 查看原图 Google Maps 选择了 Mercator 投影的一个修正版本,称为“Web Mercator”。
地理编码
地理编码是将地址转换为地理坐标的过程。
反向过程称为“反向地理编码”。
实现这一过程的一种方式是使用插值——利用不同来源(例如 GIS)的数据,其中街道网络已映射到地理坐标空间。
Geohashing
Geohashing 是一种编码系统,将地理区域编码为由字母和数字组成的字符串。
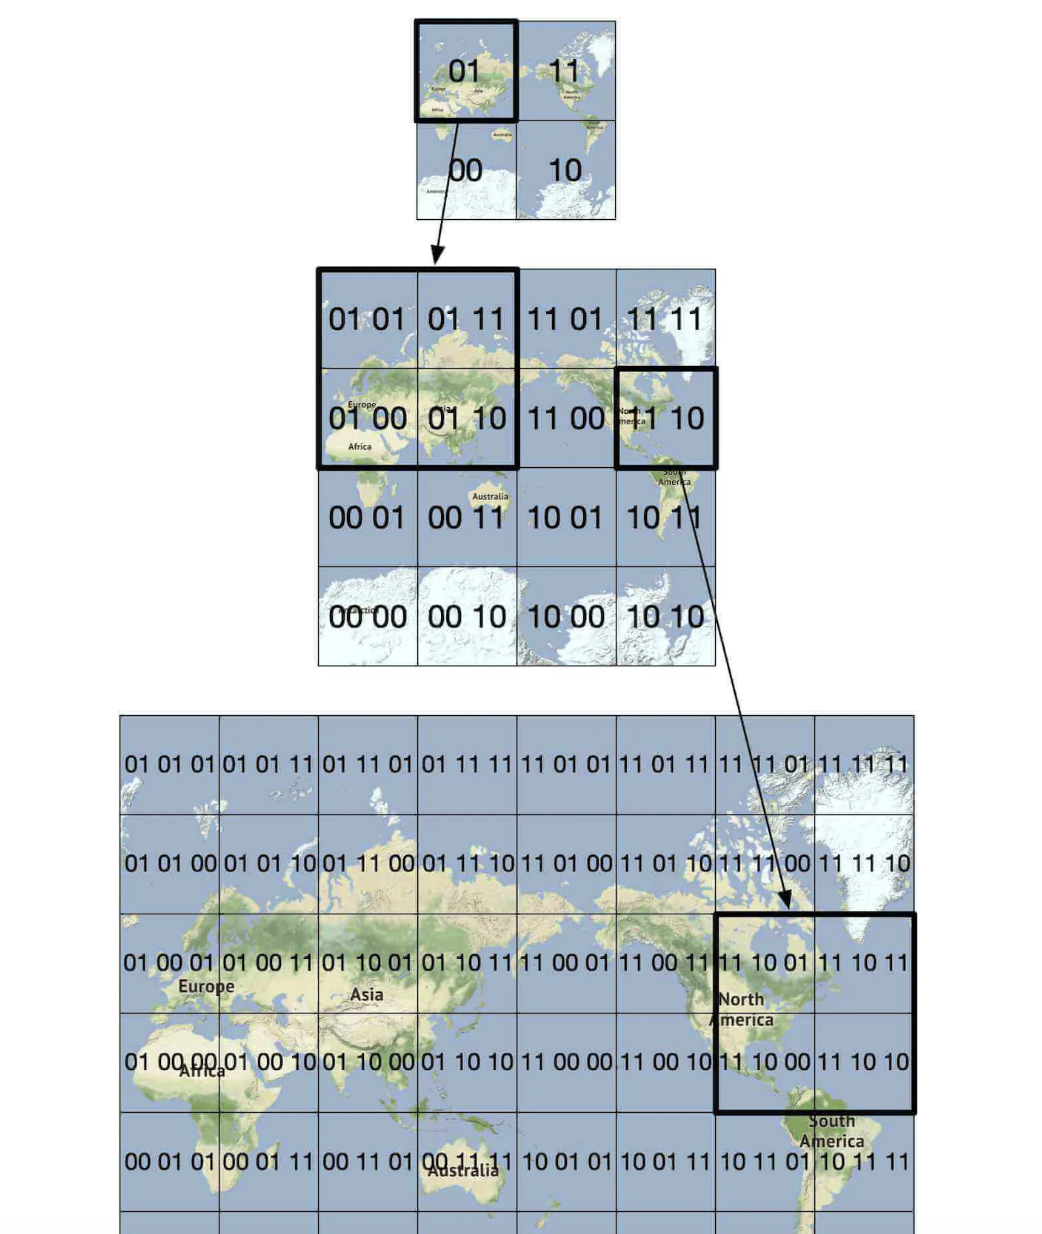
它将世界表示为一个平面,并递归地将其划分为四个象限:
geohash 递归四分 geohash 把世界展开成平面后递归地切成四个象限,每个象限用两个字符(01 / 11 / 00 / 10)标记。再往下一级,就对选中象限继续四分,并把这两位追加到字符串后面,于是越精确的格子字符串越长。 第 1 级:世界 → 4 象限 第 2 级:象限 11 再分 01 11 00 10 11 01 11 11 11 00 11 10 世界展开成平面,递归切成四象限 每分一级,geohash 字符串追加 2 位 按 diagram-design 重绘 查看原图 地图渲染
地图渲染通过瓦片化完成。与其将整个地图渲染成一张大的自定义图片,不如将世界切分成更小的瓦片。
客户端只下载相关瓦片,并像拼接马赛克一样渲染它们。
不同缩放级别有不同的瓦片。客户端根据自身缩放级别选择合适的瓦片。
例如,缩小到整个世界时,只需下载一个表示整个世界的 256x256 瓦片。
导航算法的道路数据处理
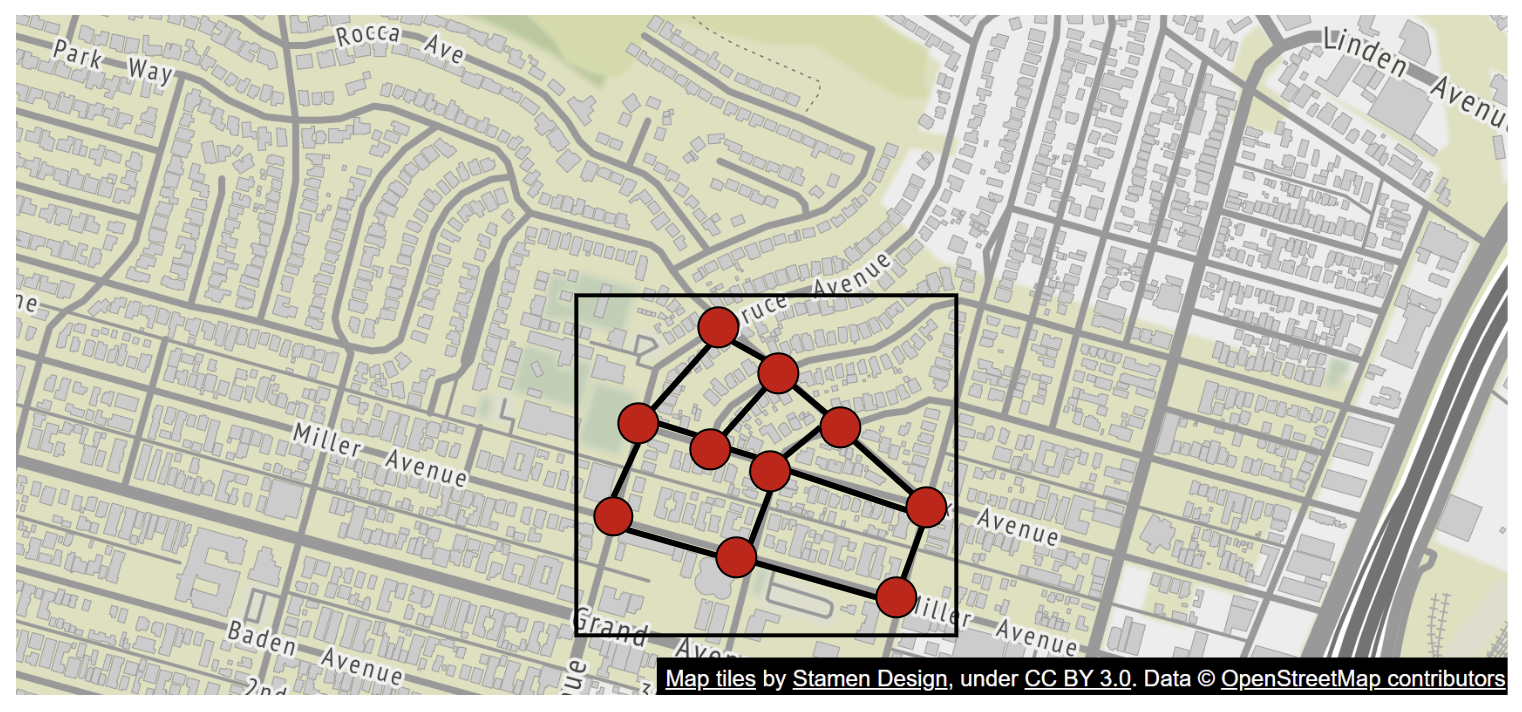
在大多数路线算法中,交叉口被表示为节点,道路被表示为边:
路网抽象成图 导航算法把交叉口看作节点、道路看作边,整张路网就变成一张加权图。绝大多数导航算法都是 Dijkstra 或 A* 的变体,在图上跑最短路。 路网图 交叉口 交叉口 交叉口 交叉口 交叉口 交叉口 交叉口 = 节点,道路 = 边 在图上跑 Dijkstra / A* 的变体求最短路 按 diagram-design 重绘 查看原图 大多数导航算法使用 Djikstra 或 A* 算法的变体。
寻路性能对图的规模很敏感。要在规模化场景下工作,我们不能把整个世界表示为一个图并在其上运行算法。
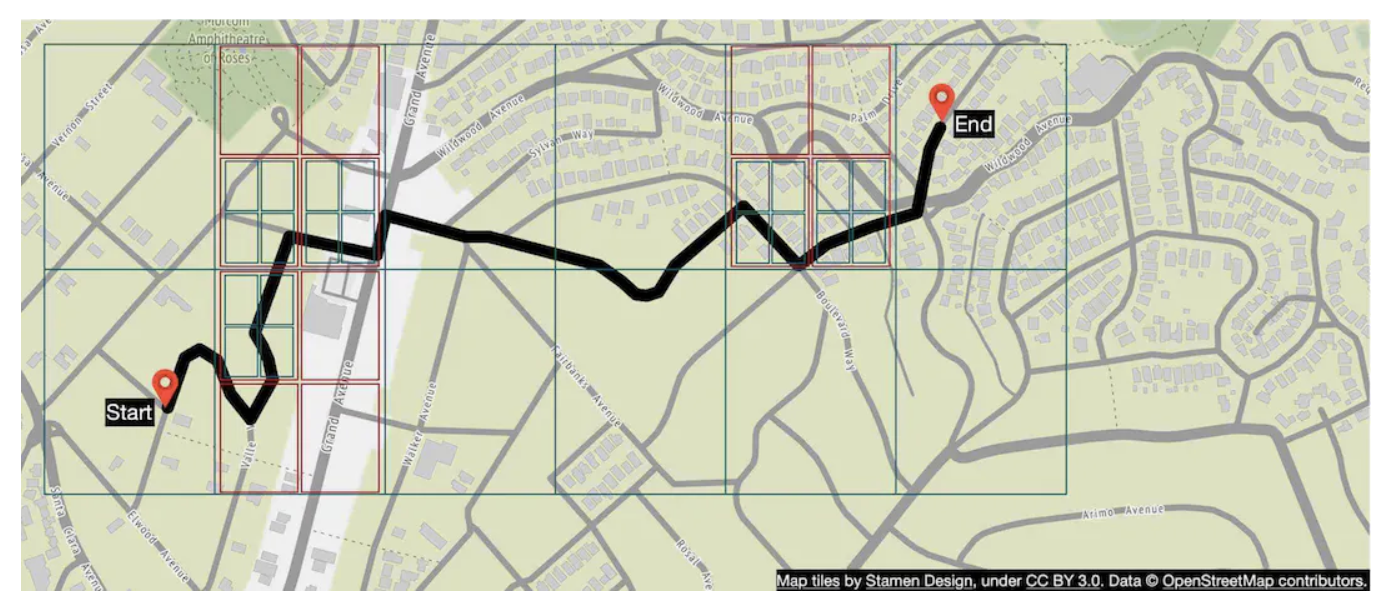
取而代之的是,我们使用类似瓦片化的技术——将世界细分为越来越小的图。
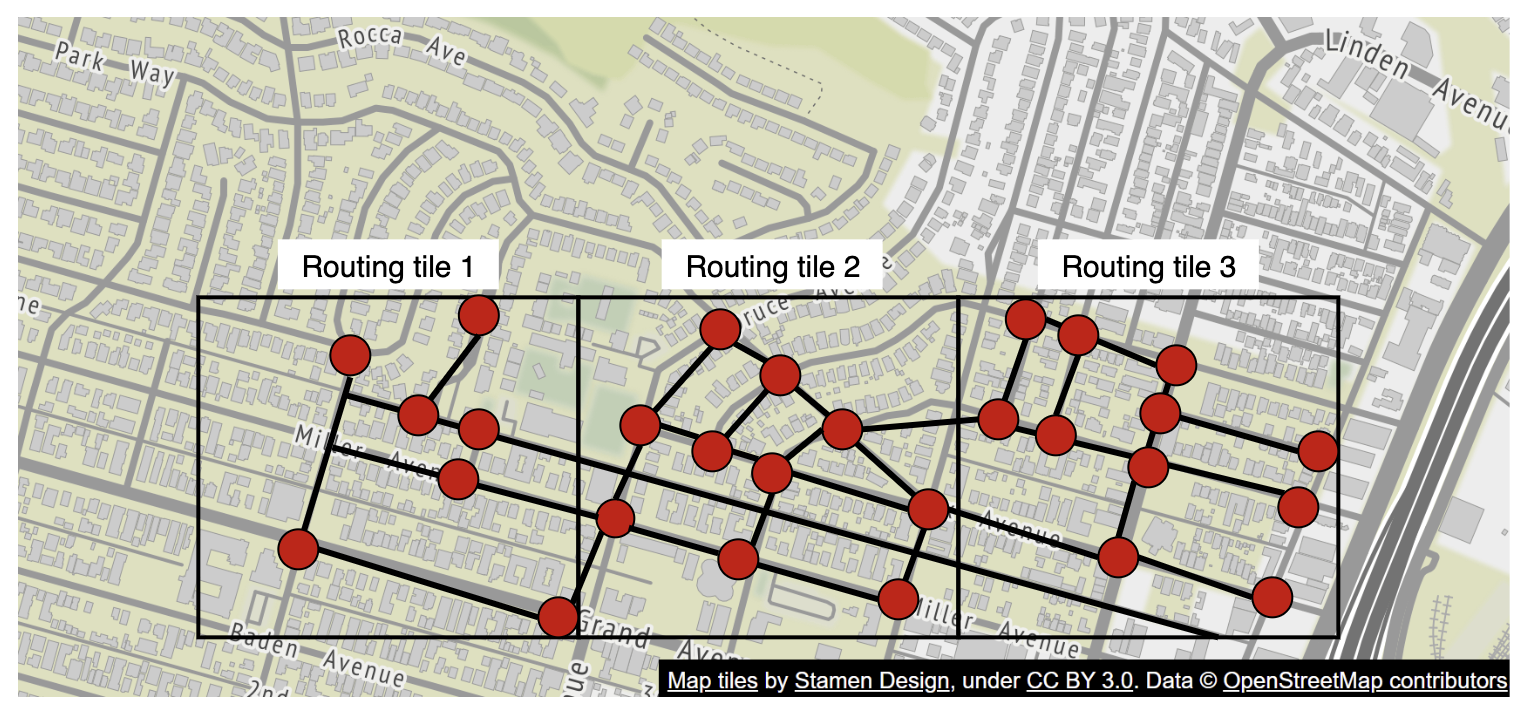
路由瓦片持有相邻瓦片的引用,算法在遍历相互连接的瓦片时可以拼接出更大的道路图:
路由瓦片与邻居引用 整张世界路网无法一次性载入,于是像切地图一样把路网切成一块块路由瓦片。每块瓦片只保存自己那一小片路网,并持有相邻瓦片的引用;算法可以按需把瓦片拼成更大的路网。 路由瓦片 1 路由瓦片 2 路由瓦片 3 节点 节点 节点 节点 节点 节点 节点 节点 节点 节点 节点 节点 每块瓦片是一小张路网图 瓦片持有邻居引用,算法按需拼接成更大路网 按 diagram-design 重绘 查看原图 这种技术能显著降低内存带宽,并且只加载给定起点/终点对所需的瓦片。
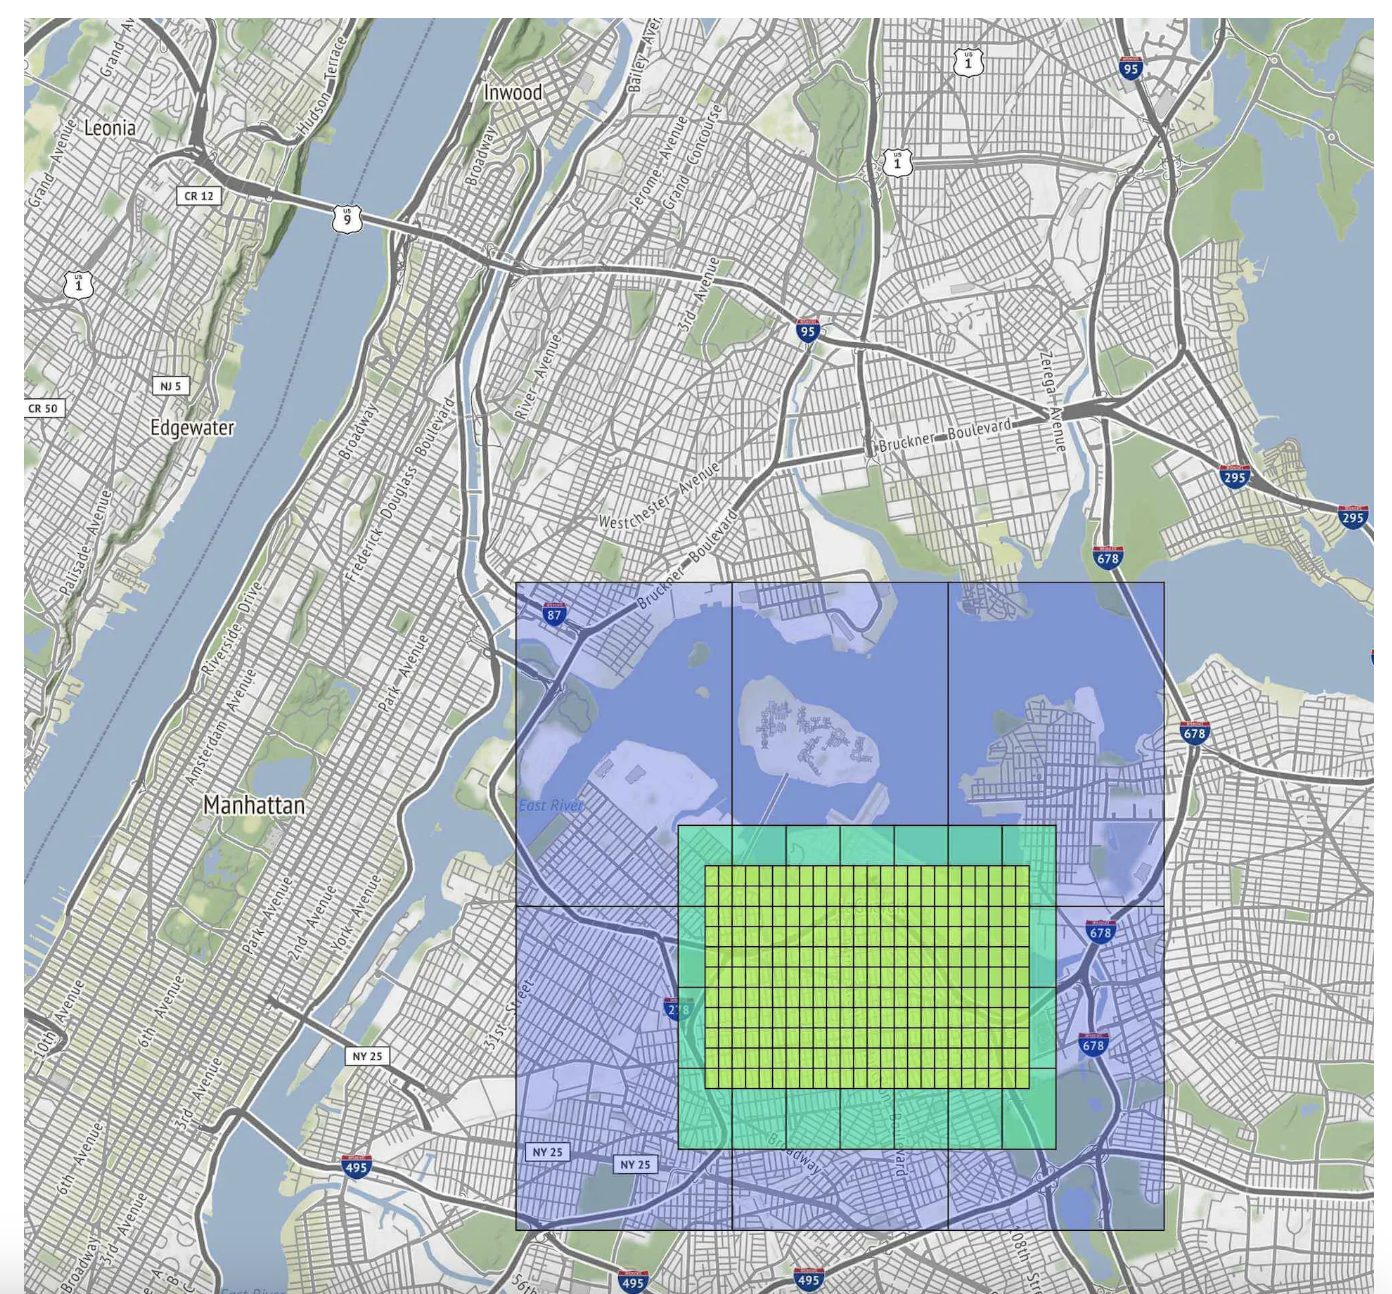
然而,对于较长路线,将小而详细的路由瓦片拼接起来仍然耗时且占用内存。相反,存在不同细节级别的路由瓦片,算法会根据我们要前往的目的地选择适当细节级别的瓦片:
分级路由瓦片 长途路线如果全用最细的瓦片拼接,依然很耗时间和内存。因此路由瓦片也分不同细节层级:离目的地越远用越粗的瓦片,越近用越细的瓦片,算法按需逐级细化。 粗粒度瓦片:跨城 中粒度瓦片:城区 细粒度瓦片:街区 当前瓦片 目的地越近,使用的瓦片越细 按需逐级细化,显著降低内存带宽 按 diagram-design 重绘 查看原图 粗略估算 对于存储,我们需要存储:
世界地图——根据需要存储的所有瓦片估算约为 70pb,但考虑到非常相似的瓦片(例如大片沙漠)的压缩
元数据——大小可忽略不计,因此可以在计算中跳过
道路信息——以路由瓦片形式存储
导航请求的估算 QPS——1bil DAU,每周使用 35 分钟 -> 每天 5bil 分钟。假设 GPS 更新请求被批量处理,我们得出 200k QPS,峰值负载为 1mil QPS。
第 2 步:提出高层设计并获得认可
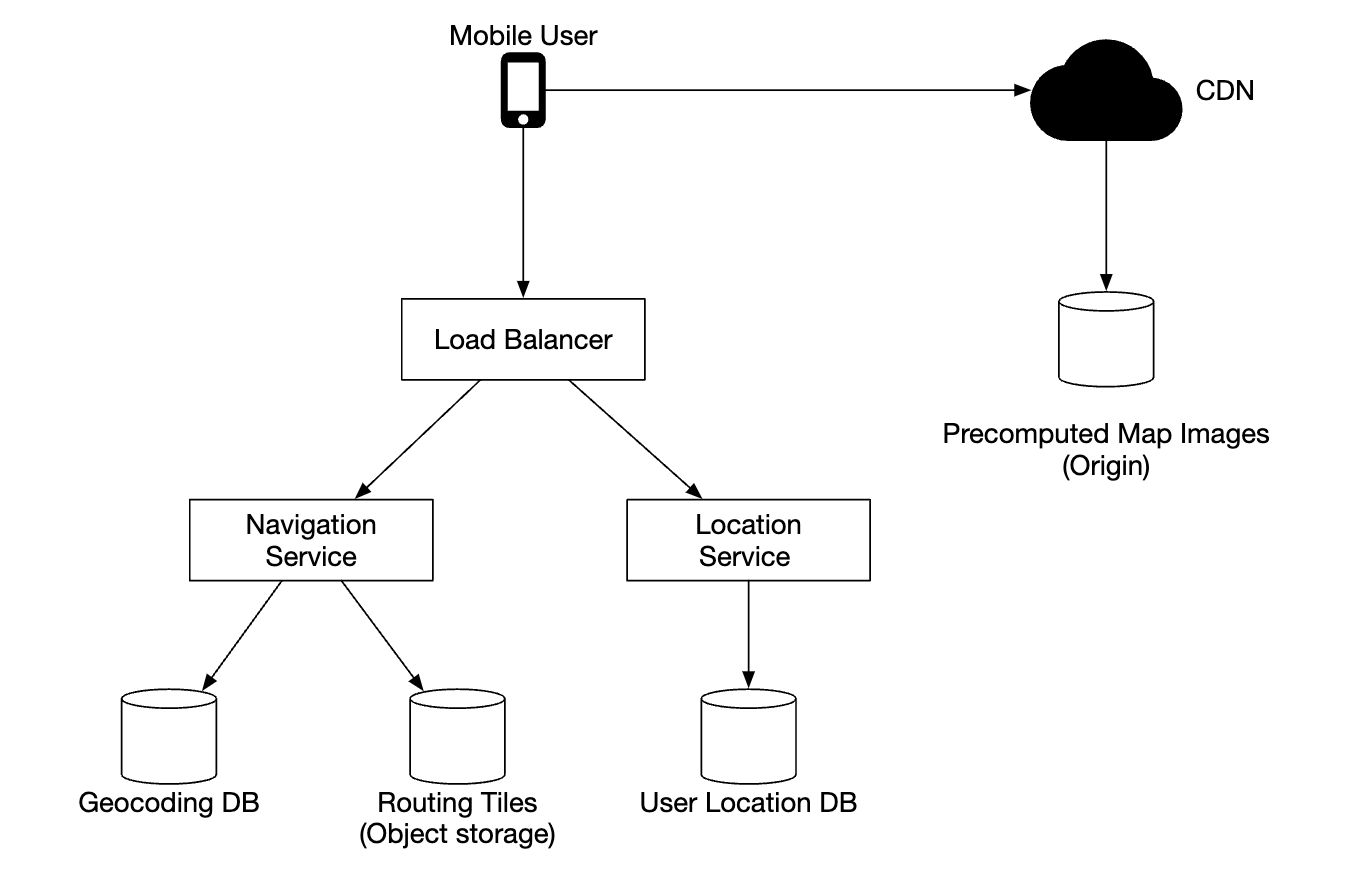
Google Maps 高层设计 移动端把请求交给负载均衡器,再分流到导航服务与位置服务:导航服务读地理编码 DB 与对象存储里的路由瓦片,位置服务把用户位置写进位置 DB;地图瓦片则由移动端直接从 CDN 拉取,CDN 回源到预计算瓦片存储。 移动端 发起请求 CDN 边缘缓存 预计算瓦片 预计算瓦片 负载均衡 导航服务 路径规划 位置服务 位置上报 地理编码 DB 地理编码 路由瓦片 对象存储 用户位置 DB Cassandra 请求 下载瓦片 回源 路由 分流 地址 写入 地图瓦片静态分发,导航与位置走服务端 回源生成,长期缓存 按 diagram-design 重绘 查看原图 位置服务
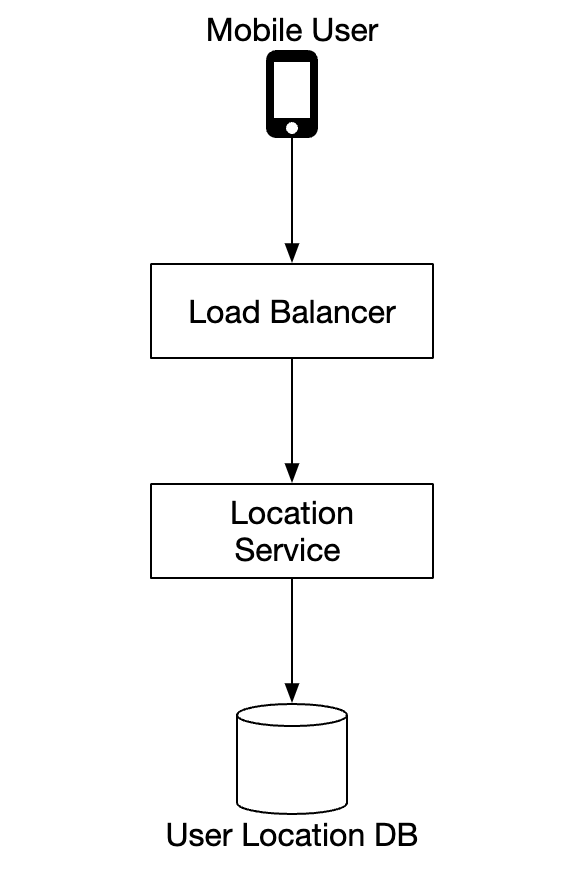
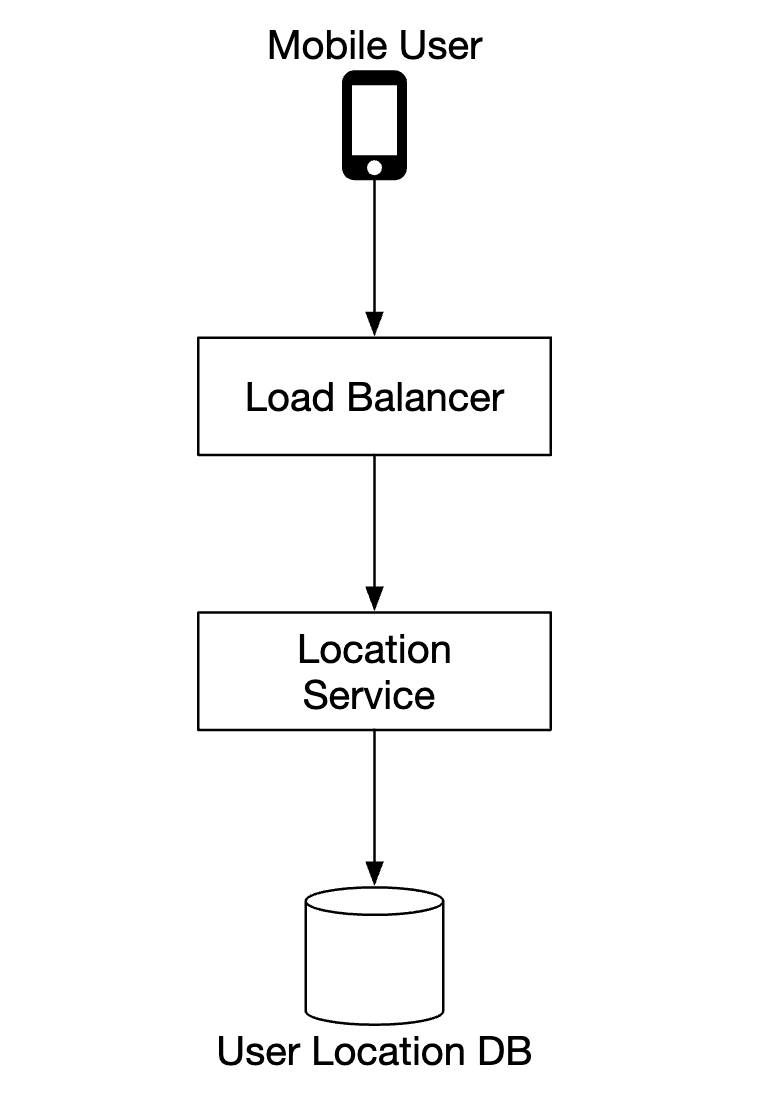
位置服务链路 位置服务负责记录用户的位置更新:移动端每隔 t 秒上报一次位置,经负载均衡器进入位置服务,最终写进为高写入量优化的位置数据库。 移动端 上报位置 负载均衡 位置服务 用户位置 DB Cassandra 上报 转发 写入 优先可用性:位置数据很快过期,允许最终一致 按 diagram-design 重绘 查看原图 它负责记录用户的位置更新:
位置更新每隔 t 秒发送一次
位置数据流可以随着时间推移用于改进服务,例如提供更准确的 ETA、监控交通数据、检测封闭道路、分析用户行为等
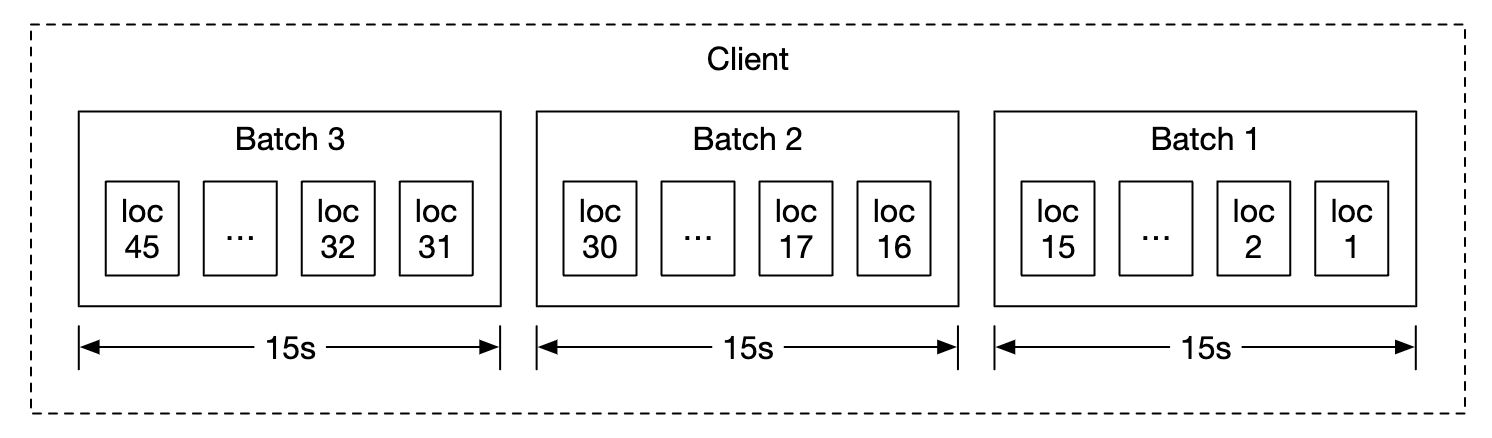
与其一直将位置更新发送到服务器,我们可以在客户端批量处理更新,然后发送批次:
客户端批量上报位置 与其每次定位都单独发请求,不如在客户端把位置按 15 秒打包成一批,再整体上报。批次越小越实时,越大越省电省流量,15 秒是常见的折中。 客户端 批次 1 批次 2 批次 3 loc 15 … loc 2 loc 1 loc 30 … loc 17 loc 16 loc 45 … loc 32 loc 31 客户端每 15s 把位置打包成一批上报 按 diagram-design 重绘 查看原图 尽管做了这种优化,对于 Google Maps 规模的系统,负载仍然很大。因此,我们可以利用为大量写入优化的数据库,例如 Cassandra。
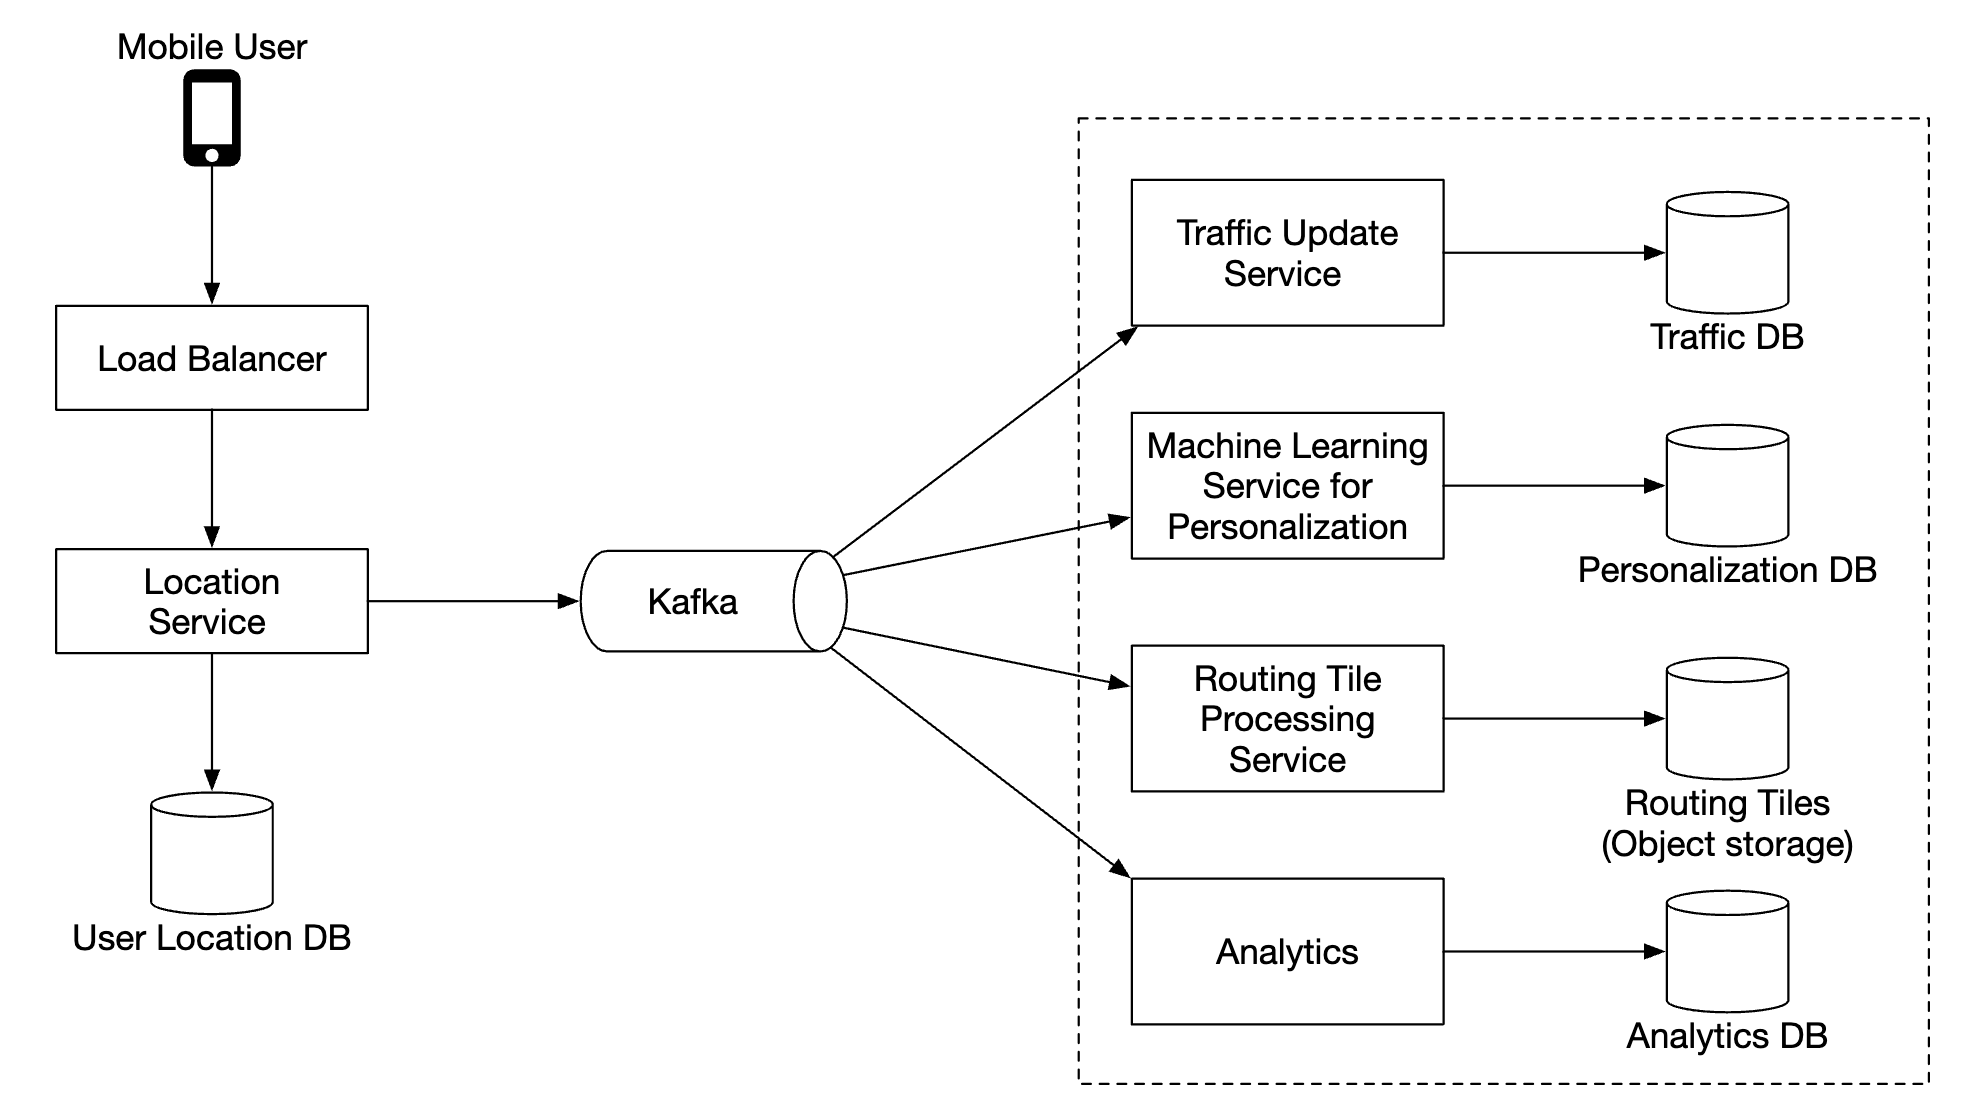
我们还可以利用 Kafka 对位置更新进行高效的流处理,以便进一步分析。
位置更新请求载荷示例:
POST /v1/locations
Parameters
  locs: JSON encoded array of (latitude, longitude, timestamp) tuples.
导航服务 该组件负责在合理时间内找到 A 到 B 之间的快速路线(允许一点延迟)。路线不必是最快的,但准确性很重要。
请求载荷示例:
GET /v1/nav?origin=1355+market+street,SF&destination=Disneyland
响应示例:
{
  "distance": {"text":"0.2 mi", "value": 259},
  "duration": {"text": "1 min", "value": 83},
  "end_location": {"lat": 37.4038943, "Ing": -121.9410454},
  "html_instructions": "Head <b>northeast</b> on <b>Brandon St</b> toward <b>Lumin Way</b><div style=\"font-size:0.9em\">Restricted usage road</div>",
  "polyline": {"points": "_fhcFjbhgVuAwDsCal"},
  "start_location": {"lat": 37.4027165, "lng": -121.9435809},
  "geocoded_waypoints": [
    {
       "geocoder_status" : "OK",
       "partial_match" : true,
       "place_id" : "ChIJwZNMti1fawwRO2aVVVX2yKg",
       "types" : [ "locality", "political" ]
    },
    {
       "geocoder_status" : "OK",
       "partial_match" : true,
       "place_id" : "ChIJ3aPgQGtXawwRLYeiBMUi7bM",
       "types" : [ "locality", "political" ]
    }
  ],
  "travel_mode": "DRIVING"
}
交通变化和重新规划路线目前尚未考虑,这些将在深入探讨部分处理。
地图渲染 将完整的地图瓦片数据集保存在客户端不可行,因为它的大小是 PB 级。
它们需要根据客户端的位置和缩放级别从服务器按需获取。
应在何时获取新瓦片——用户缩放地图时,以及导航过程中朝新瓦片移动时。
如何向客户端提供地图瓦片?
可以动态构建,但这会给服务器带来巨大负载,也会使缓存变得困难
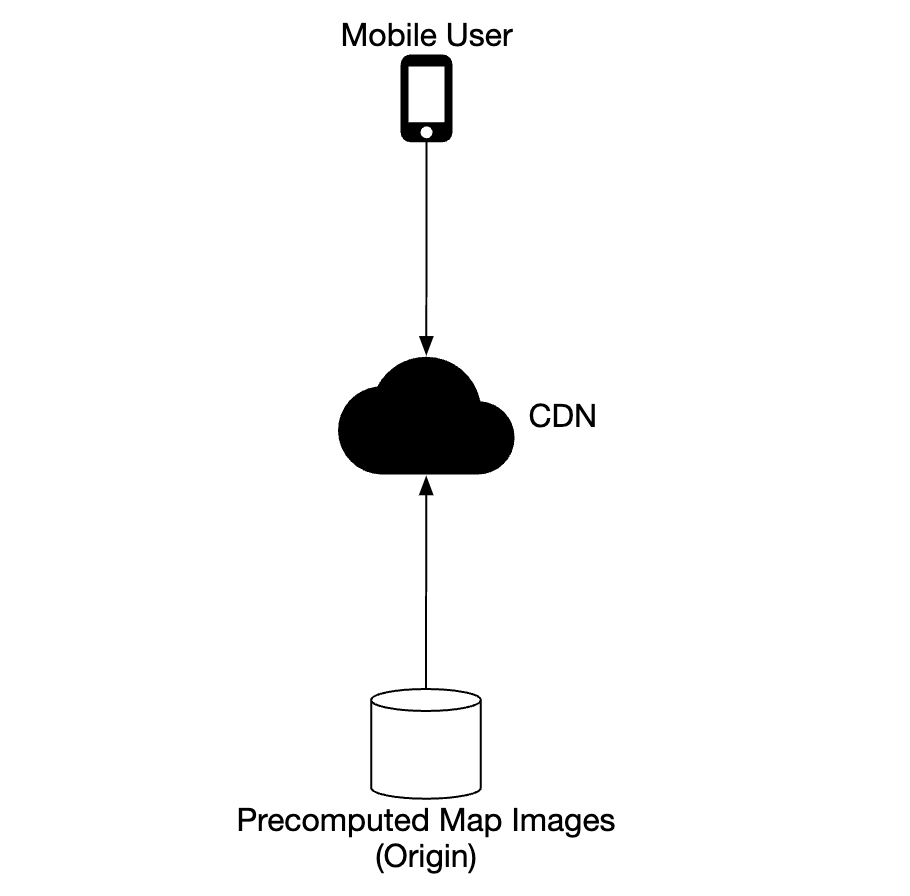
地图瓦片基于其 Geohash 以静态方式提供,客户端可以计算 Geohash。它们可以静态存储并从 CDN 提供
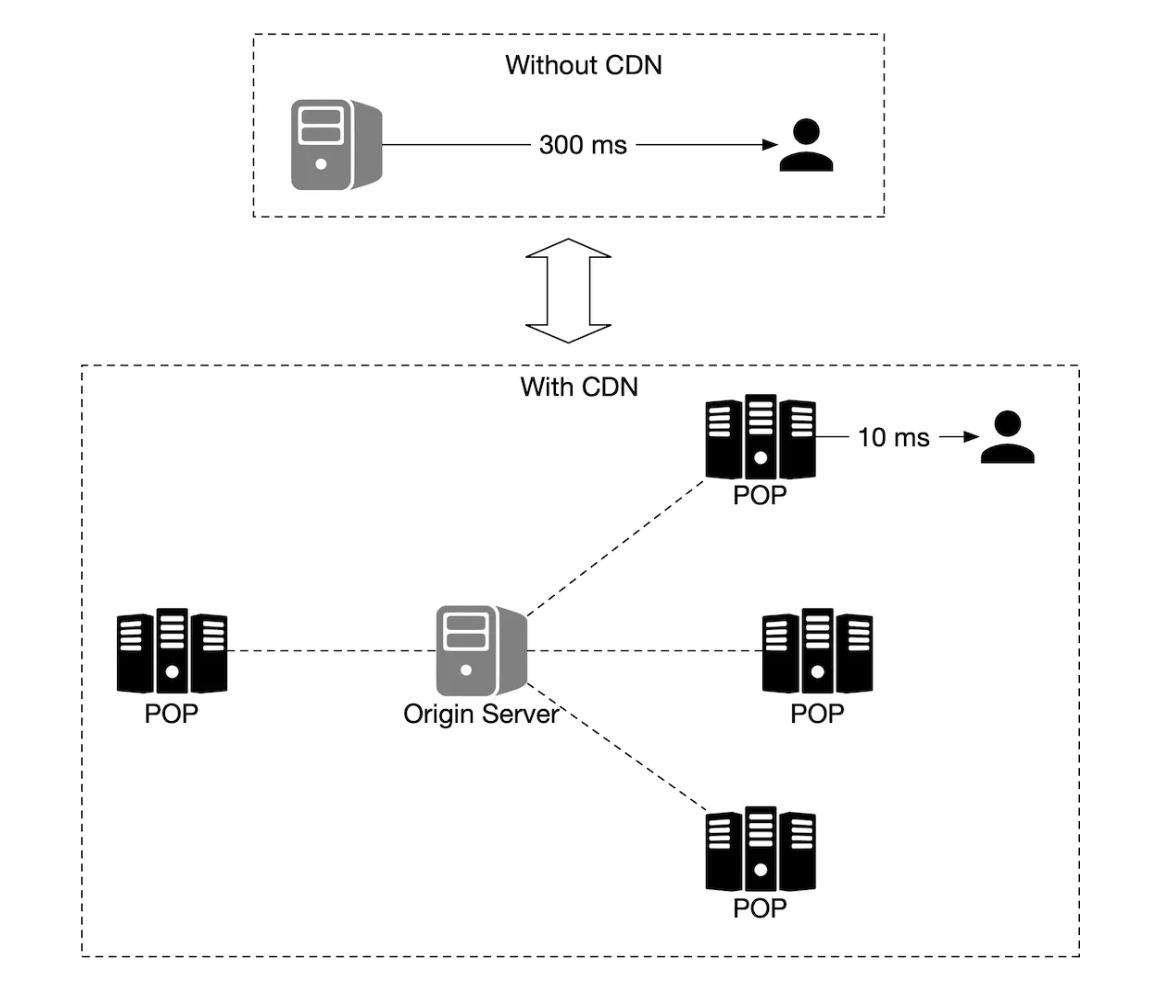
静态地图瓦片分发 把整个世界存成一张大图不可行,瓦片按需拉取。瓦片不动态生成,而是按 geohash 预先算好、静态存放在对象存储里,再由 CDN 就近分发给移动端。 移动端 请求瓦片 CDN 预计算瓦片 对象存储 拉取 回源 按 geohash 静态寻址,客户端可自行计算 URL 按 diagram-design 重绘 查看原图 CDN 使用户能够从最接近用户的接入点服务器(POP)获取地图瓦片,以最大限度降低延迟:
有无 CDN 的延迟对比 没有 CDN 时,用户直接连源站,往返延迟约 300 ms。有了 CDN,源站把瓦片同步到各地 POP(接入点),用户从最近的 POP 取瓦片,延迟降到约 10 ms。 无 CDN 有 CDN 源站 用户 源站 POP POP POP 用户 300 ms 10 ms 就近接入:POP 越近,首屏瓦片越快 按 diagram-design 重绘 查看原图 确定地图瓦片的可选方案:
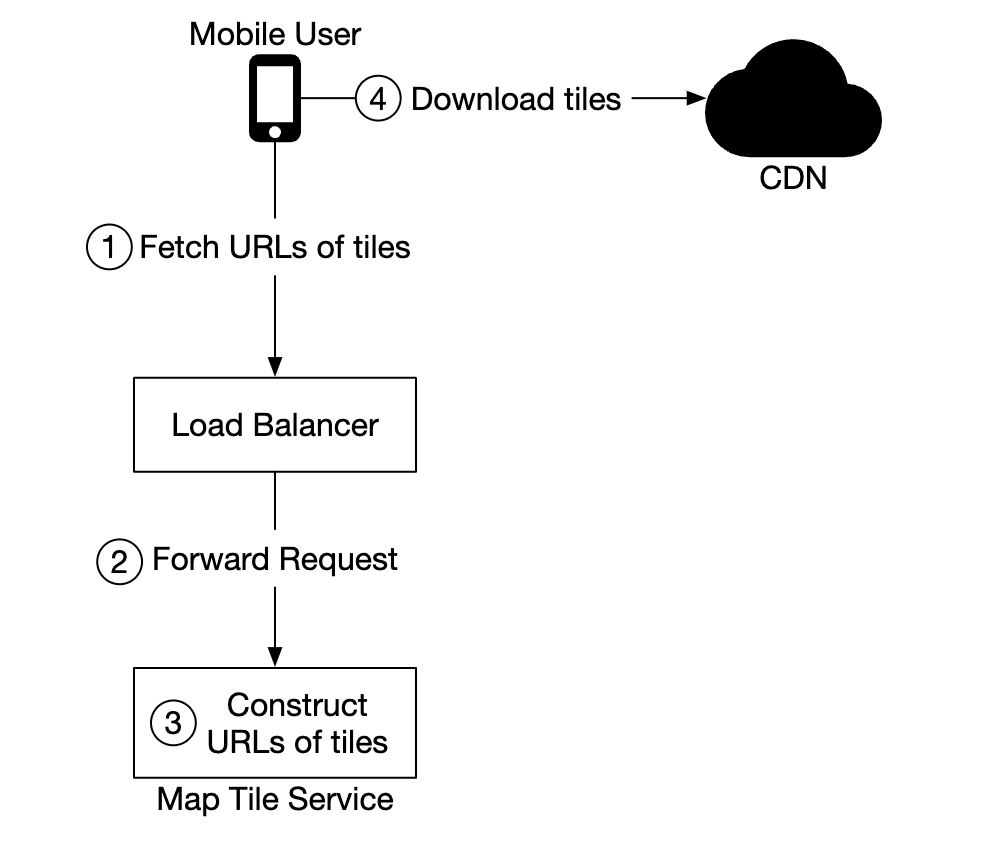
地图瓦片的 Geohash 可以在客户端计算。如果是这样,我们需要注意,我们长期要沿用这种地图瓦片计算方式,因为强迫客户端更新很困难
或者,我们可以提供一个简单 API 替客户端计算地图瓦片 URL,代价是额外的一次 API 调用
地图瓦片 URL 的计算方式 确定瓦片有两种做法:客户端自己按 geohash 算 URL(省一次请求,但一旦定下格式就很难改),或让地图瓦片服务代算(多一次 API 调用,但格式可随时调整)。拿到 URL 后,客户端再从 CDN 下载瓦片。 移动端 请求瓦片 负载均衡 地图瓦片服务 ③ 构造 URL CDN 边缘缓存 ① 取 URL ② 转发 ④ 下载瓦片 两种做法:客户端自算,或服务端代算 客户端自算省一次请求,但要长期兼容旧格式 按 diagram-design 重绘 查看原图 第 3 步:设计深入探讨
数据模型 我们来讨论如何存储所处理的不同类型数据。
路由瓦片
初始道路数据集来自不同来源。它会基于位置更新数据随时间不断改进。
道路数据是非结构化的。我们有一个周期性离线处理管道,将这些原始数据转换为我们应用所需的基于图的路由瓦片。
我们不使用数据库存储这些瓦片,因为不需要任何数据库功能。我们可以将它们存储在 S3 对象存储中,并积极缓存。
我们还可以利用库将邻接表高效压缩为二进制文件。
用户位置数据
用户位置数据对于更新交通状况和进行各种其他分析非常有用。
我们可以使用 Cassandra 存储这类数据,因为其本质是写入密集型。
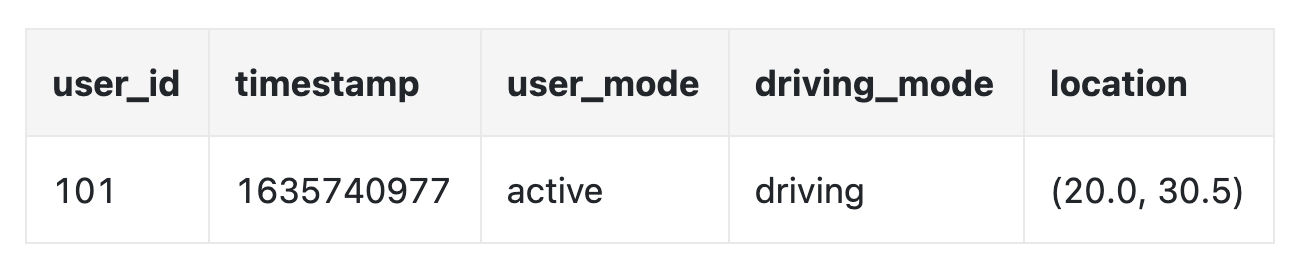
示例行:
位置更新的行结构 用户位置数据写多读少,适合 Cassandra。一行记录一次位置更新:user_id、timestamp、用户状态、出行方式与经纬度。user_id 做分区键,timestamp 做聚簇键,同一用户的位置按时间有序存放。 user_id timestamp user_mode driving_mode location 101 1635740977 active driving (20.0, 30.5) 一行 = 一次位置更新 user_id 分区键 + timestamp 聚簇键 按 diagram-design 重绘 查看原图 地理编码数据库
该数据库存储键值对,即经纬度对与地点之间的映射。
我们可以使用 Redis,因为它读取速度快,而我们的场景是频繁读取、写入很少。
预计算的世界地图图像
如前所述,我们会预计算地图瓦片图像并将其存储在 CDN 中。
预计算的地图瓦片 地图瓦片不动态生成,而是离线批量渲染好、切成一张张 256×256 的图片,再推送到 CDN 静态存放。客户端只要按 geohash 拼出 URL,就能就近拉到对应瓦片。 离线渲染 批量渲染 地图瓦片 256 × 256 CDN 静态分发 渲染 上传 离线算好、静态分发,避免动态生成的服务器压力 相似的瓦片(如沙漠)可大幅压缩 按 diagram-design 重绘 查看原图 服务 位置服务
我们来重点讨论该服务的数据库设计,以及用户位置的详细存储方式。
位置服务数据写入 深挖位置服务的数据库设计:移动端批量上报的位置更新经负载均衡器进入位置服务,由位置服务写入 NoSQL 位置库;用 user_id 分区、timestamp 聚簇,天然适配写多读少的负载。 移动端 批量上报 负载均衡 位置服务 用户位置 DB Cassandra 上报 转发 写入 user_id 为分区键,timestamp 为聚簇键 按 diagram-design 重绘 查看原图 我们可以使用 NoSQL 数据库来应对位置更新的大量写入负载。我们优先考虑可用性而非一致性,因为用户位置数据经常变化,新更新到来后旧数据就会过时。
我们将选择 Cassandra 作为数据库,因为它很好地满足我们的所有需求。
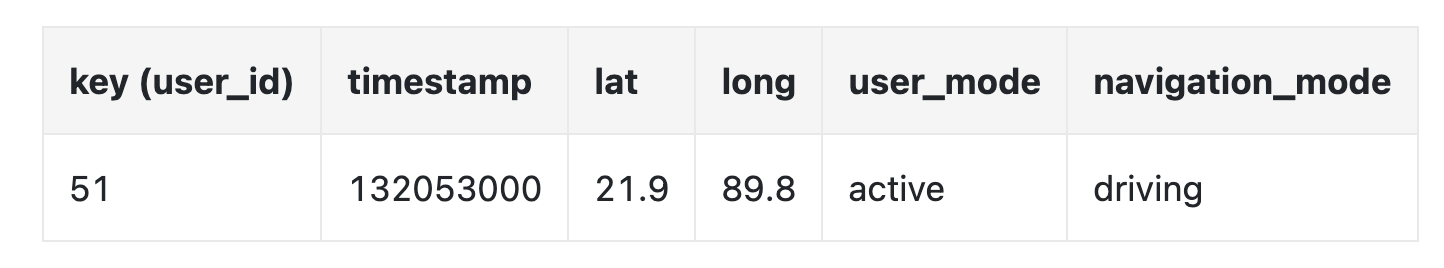
我们将存储的示例行:
位置行示例(含导航模式) 实际存下来的行还会带上导航模式:key(user_id)、timestamp、lat、long、user_mode 与 navigation_mode。这样既知道用户在哪儿,也知道他正在开车、走路还是骑行。 key (user_id) timestamp lat long user_mode navigation_mode 51 132053000 21.9 89.8 active driving 一行 = 一次位置更新 user_id 分区键 + timestamp 聚簇键,写多读少 按 diagram-design 重绘 查看原图
user_id 是分区键,以便快速访问特定用户的所有位置更新timestamp 是聚簇键,以便按位置更新接收时间排序存储数据
我们还利用 Kafka 将位置更新流式传输到各种其他服务,这些服务出于不同目的需要位置更新:
位置更新的流式下游 位置服务除了写位置库,还把更新投进 Kafka。多个下游各自消费:路况更新服务维护路况 DB、机器学习服务做个性化、瓦片处理服务更新路由瓦片、分析服务写入分析 DB。 下游消费方 移动端 上报位置 负载均衡 位置服务 用户位置 DB Cassandra Kafka 流式缓冲 路况更新服务 路况 DB ML 个性化服务 个性化 DB 瓦片处理服务 路由瓦片 分析服务 分析 DB 投递 一路写入、一路流式外送,互不阻塞 按 diagram-design 重绘 查看原图 地图渲染
地图瓦片按不同缩放级别存储。在最低缩放级别,整个世界由一个 256x256 瓦片表示。
随着缩放级别提高,地图瓦片数量变为原来的四倍:
缩放级与瓦片数量 地图瓦片按缩放级分层存放。最低缩放级用一张 256×256 瓦片表示整个世界;缩放级每升一级,瓦片数就翻两番(×4):1 → 4 → 16。客户端根据当前缩放级挑对应的瓦片。 缩放级 0 · 1 张 缩放级 1 · 4 张 缩放级 2 · 16 张 缩放级每升一级,瓦片数 ×4 1 张 · 4 张 · 16 张,按当前缩放级选择 按 diagram-design 重绘 查看原图 我们可以采用的一种优化是:不通过网络发送完整图像信息,而是将瓦片表示为向量(路径和多边形),让客户端动态渲染瓦片。
这将显著节省带宽。
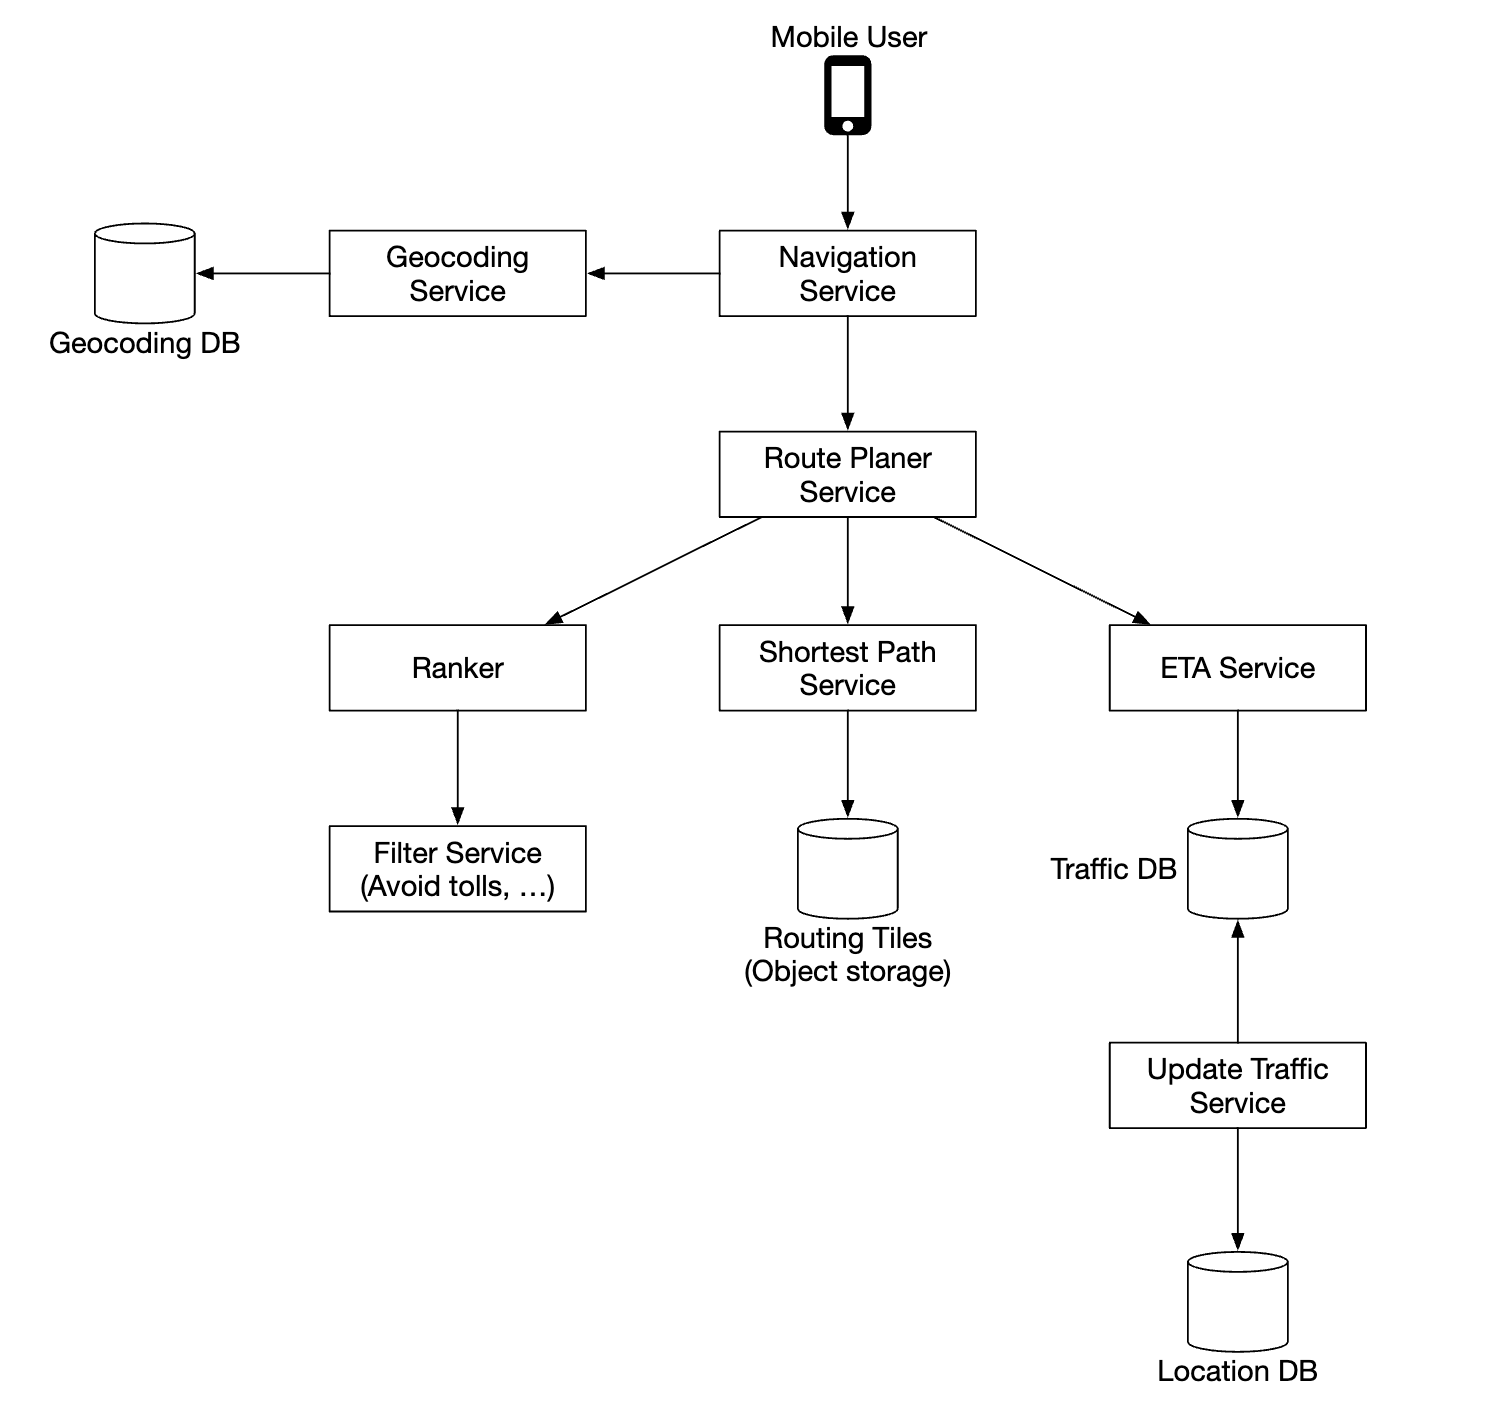
导航服务
该服务负责寻找最快路线:
导航服务内部组件 导航服务先把地址交给地理编码服务解析成经纬度,再转给路线规划服务。规划服务并行调用排序服务(按用户偏好过滤,如避开收费路)、最短路服务(在对象存储的路由瓦片上跑 A* 变体)和 ETA 服务(读路况 DB 预测时间);路况更新服务异步刷新路况 DB 与位置 DB。 移动端 发起导航 导航服务 地理编码服务 地理编码 DB 地理编码 路线规划服务 排序服务 过滤服务 最短路服务 路由瓦片 对象存储 ETA 服务 路况 DB 路况更新服务 位置 DB Cassandra 请求 规划 地址 查询 排序 路径 ETA 过滤 取瓦片 路况 更新 写入 地址 → 坐标 → 路线,三段式;允许少量延迟但要求准确 按 diagram-design 重绘 查看原图 我们来看一下该子系统中的每个组件。
首先,我们有地理编码服务,它将地址解析为经纬度对表示的位置。
请求示例:
https://maps.googleapis.com/maps/api/geocode/json?address=1600+Amphitheatre+Parkway,+Mountain+View,+CA
响应示例:
{
   "results" : [
      {
         "formatted_address" : "1600 Amphitheatre Parkway, Mountain View, CA 94043, USA",
         "geometry" : {
            "location" : {
               "lat" : 37.4224764,
               "lng" : -122.0842499
            },
            "location_type" : "ROOFTOP",
            "viewport" : {
               "northeast" : {
                  "lat" : 37.4238253802915,
                  "lng" : -122.0829009197085
               },
               "southwest" : {
                  "lat" : 37.4211274197085,
                  "lng" : -122.0855988802915
               }
            }
         },
         "place_id" : "ChIJ2eUgeAK6j4ARbn5u_wAGqWA",
         "plus_code": {
            "compound_code": "CWC8+W5 Mountain View, California, United States",
            "global_code": "849VCWC8+W5"
         },
         "types" : [ "street_address" ]
      }
   ],
   "status" : "OK"
}
路线规划服务根据当前交通状况计算建议路线,并针对行驶时间进行优化。
最短路径服务针对对象存储中的路由瓦片运行 A* 算法的一种变体,以计算最优路径:
它接收起点/终点对,将其转换为经纬度对,并从这些经纬度对推导出 Geohash,以确定路由瓦片
算法从初始路由瓦片开始遍历,直到找到一条到达目标瓦片的足够好的路径
最短路服务遍历瓦片 最短路服务接收起点/终点,转成经纬度后推出 geohash,定位到对应的路由瓦片。算法从起点瓦片开始,沿邻居引用一块块遍历,直到找到一条通往终点瓦片的足够好的路径。 路由瓦片 瓦片 1 瓦片 2 瓦片 3 瓦片 4 起点瓦片 → 沿邻居引用逐块遍历 → 终点瓦片 A* 变体在拼接出的大图上求最短路 起点 终点 按 diagram-design 重绘 查看原图 路线规划服务会调用 ETA 服务,以根据机器学习算法获取估算时间,这些算法基于交通数据预测 ETA。
排序服务负责根据用户传入的过滤条件(例如避开收费公路或高速公路的标记)对不同可能路径进行排序。
更新服务异步更新一些重要数据库,使其保持最新。
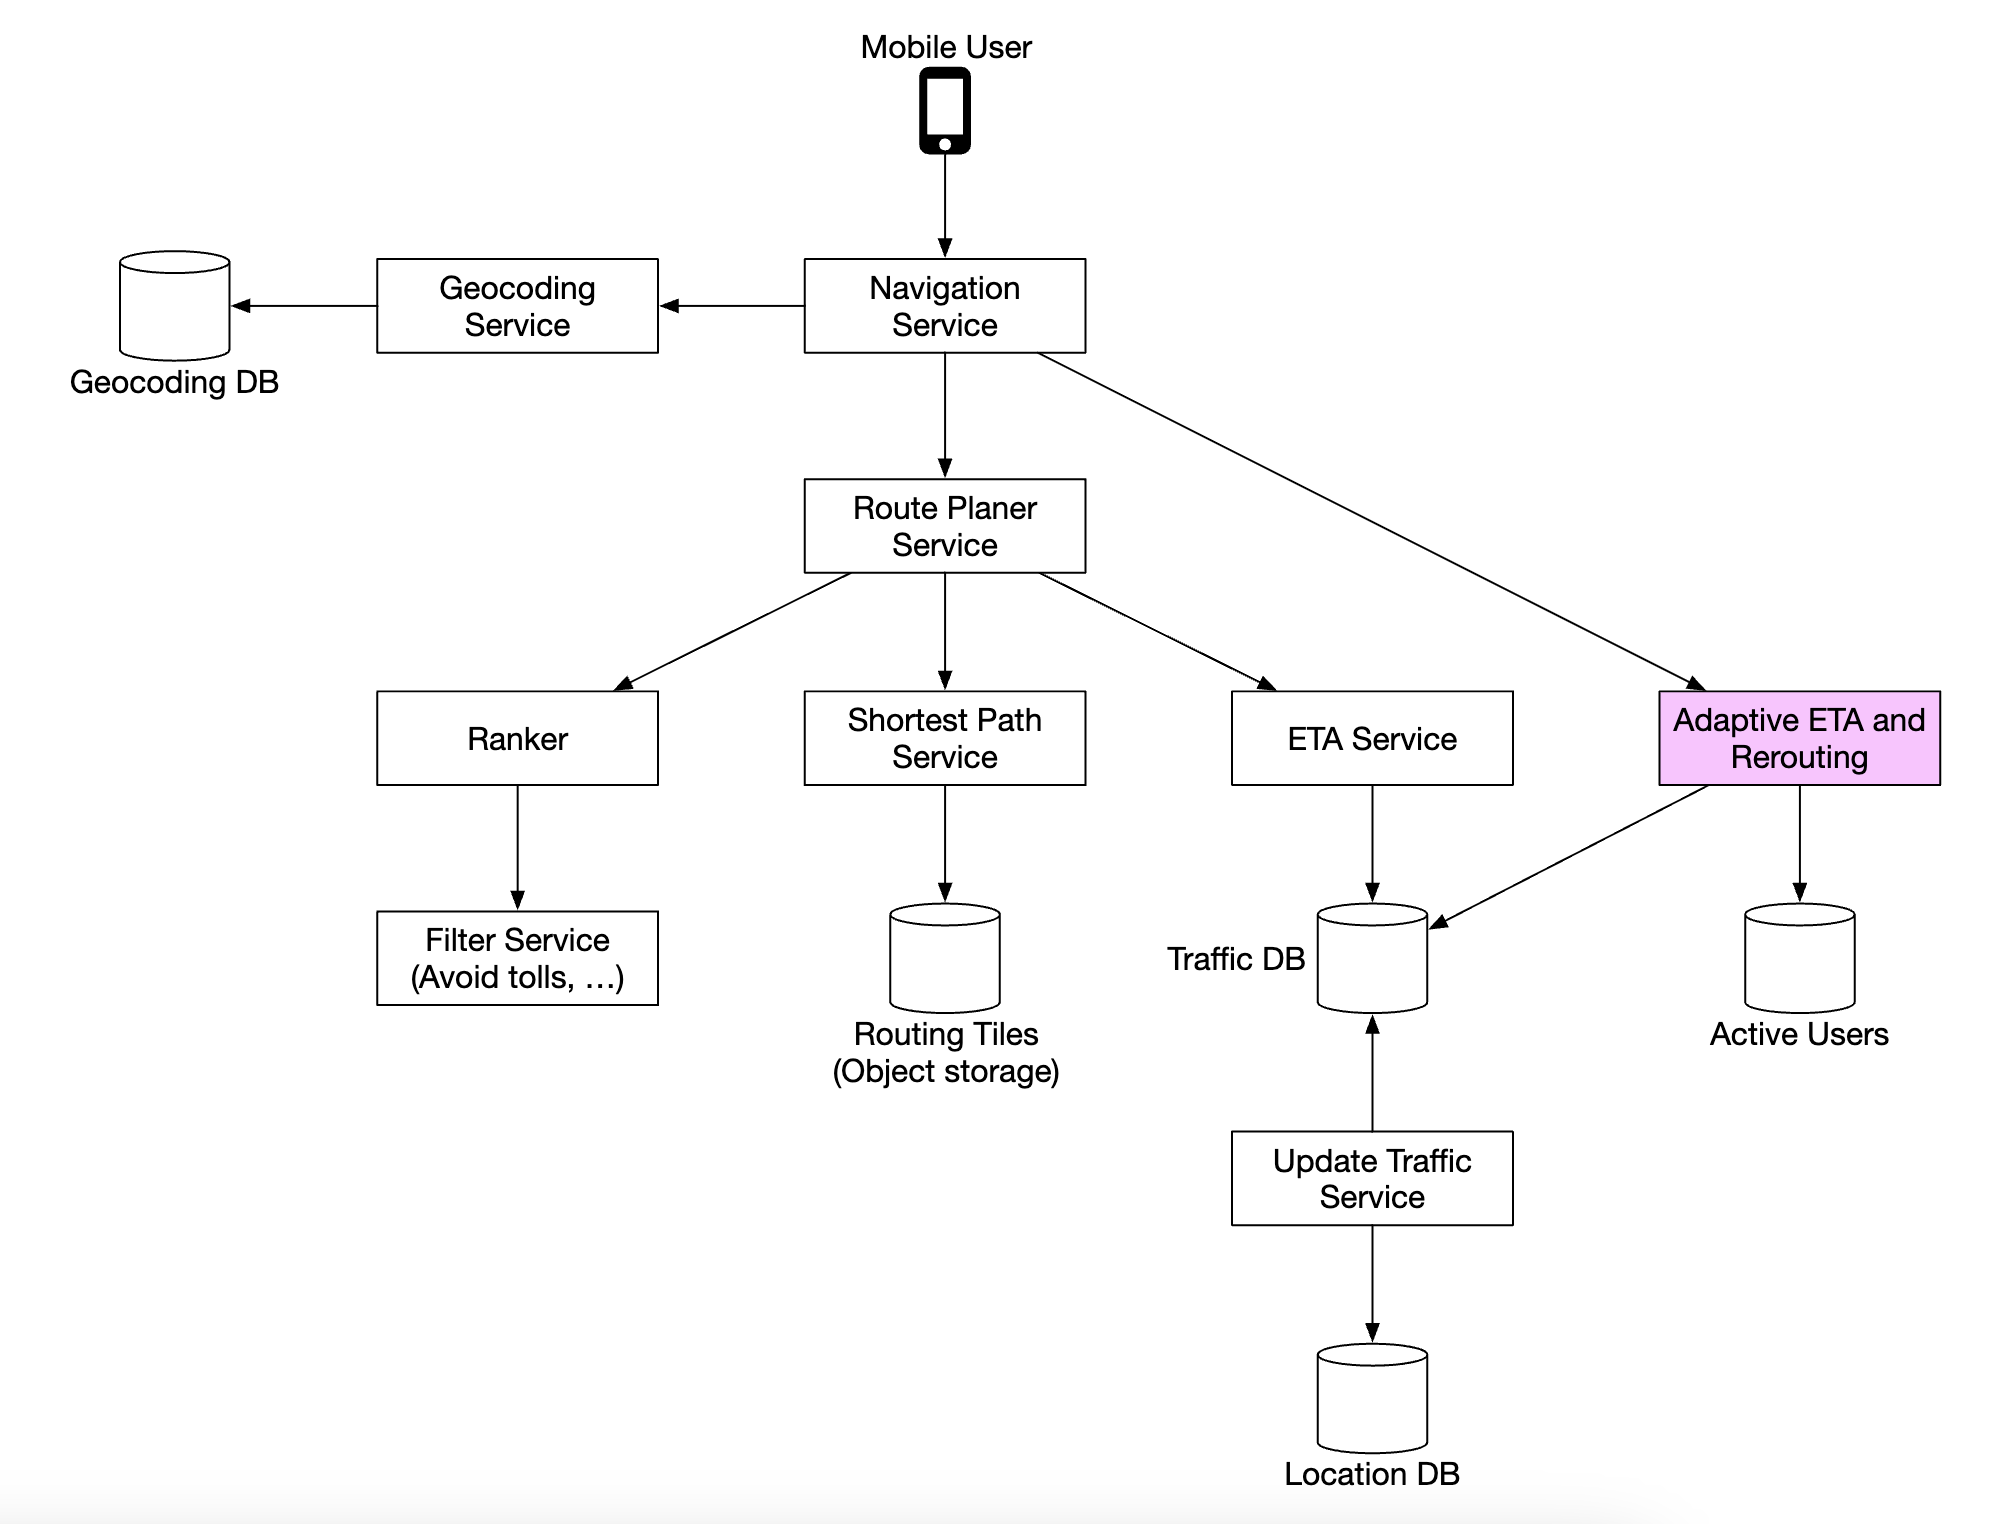
改进——自适应 ETA 与重新规划路线
我们可以做的一项改进是,根据新获得的交通数据自适应地更新进行中的路线。
实现方式之一是:在数据库中存储当前正在沿某条路线导航的用户,并保存他们应经过的所有瓦片。
数据可能如下:
user_1: r_1, r_2, r_3, …, r_k
user_2: r_4, r_6, r_9, …, r_n
user_3: r_2, r_8, r_9, …, r_m
...
user_n: r_2, r_10, r21, ..., r_l
如果某个瓦片上发生交通事故,我们可以识别所有路径经过该瓦片的用户并为其重新规划路线。
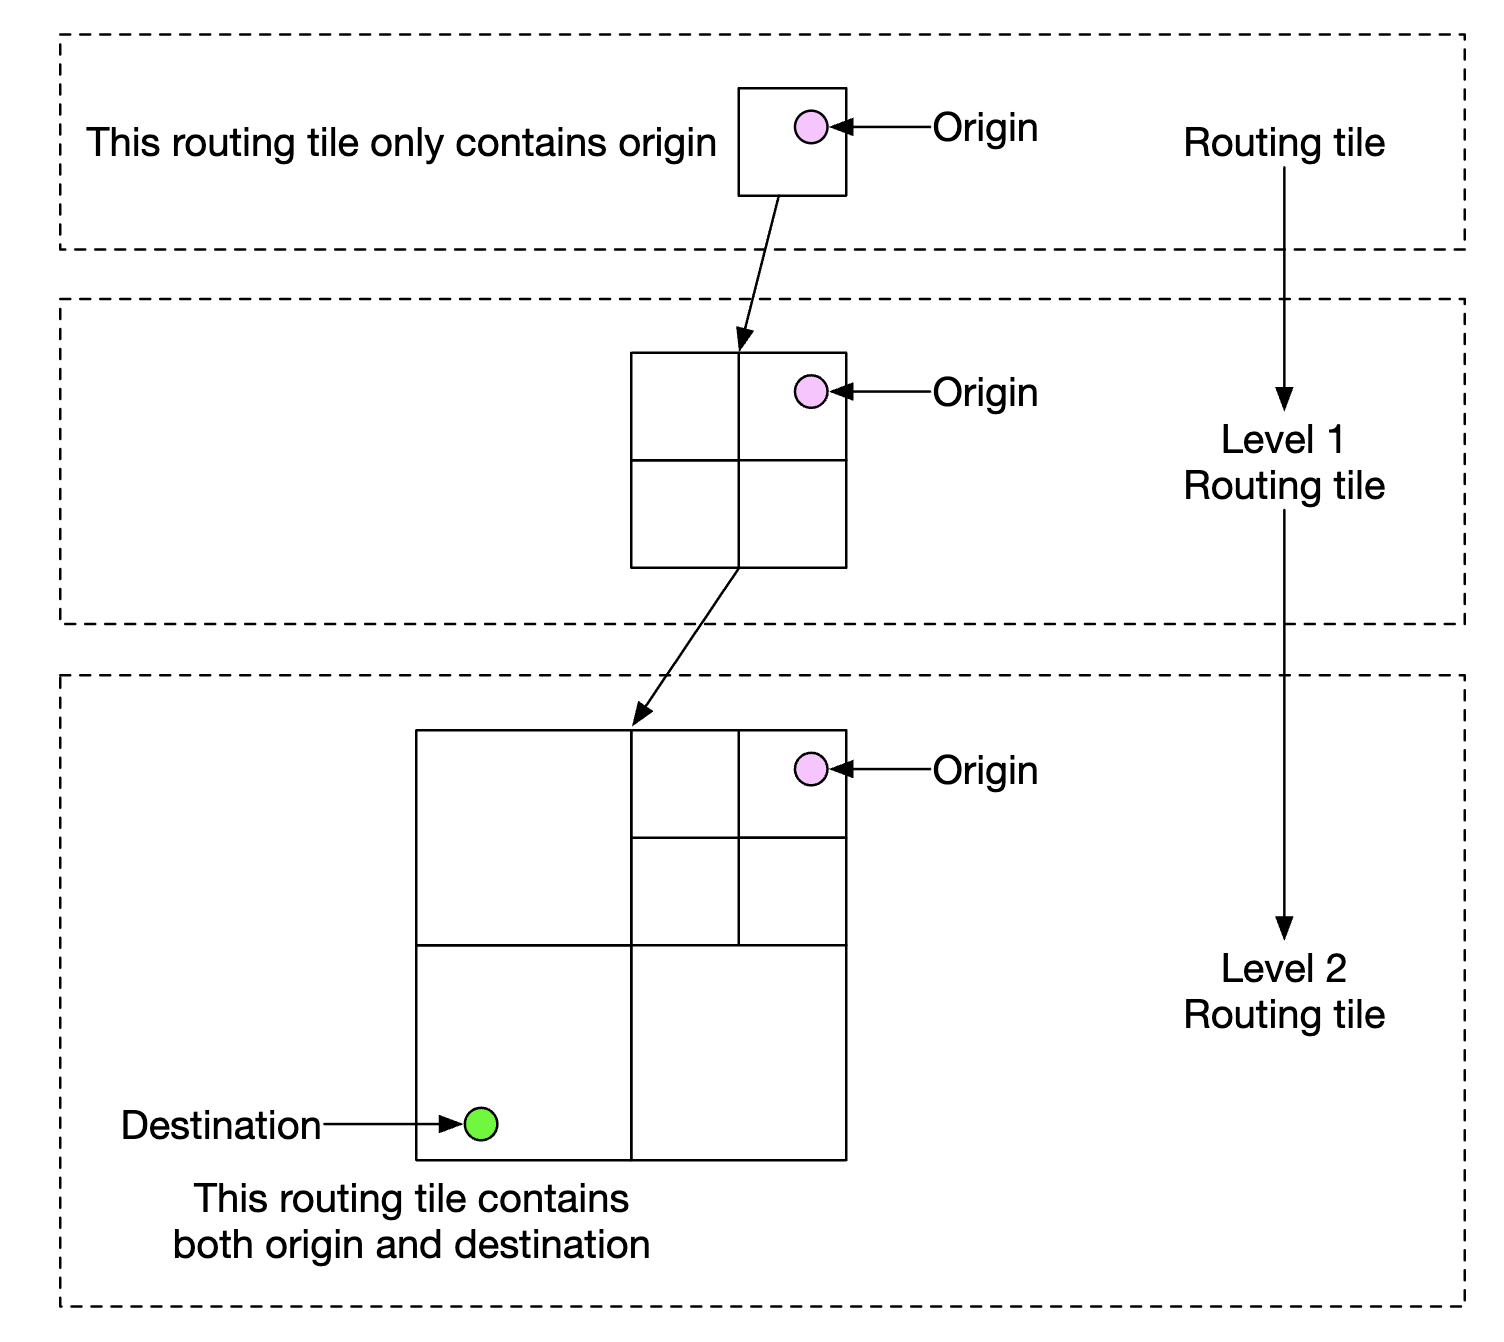
为了减少数据库中存储的瓦片数量,我们可以改为存储起点路由瓦片,以及不同分辨率级别的若干路由瓦片,直到目标瓦片也被包含在内:
user_1, r_1, super(r_1), super(super(r_1)), ...
自适应 ETA 的瓦片存储 为了在事故发生时快速找出受影响的用户,系统按瓦片索引导航中的用户,而不是存下整条路线。每个用户只存起点瓦片以及它的各级祖先瓦片(范围每级扩大 4 倍),一路存到包含终点的层级;只要检查最后那块瓦片是否命中事故瓦片即可。 层级 0 层级 1 层级 2 起点 起点 起点 终点 层级 0:只含起点瓦片 层级 1:范围扩大 4 倍 层级 2:同时含起点与终点 只存各级祖先瓦片,检查终点瓦片即可 按 diagram-design 重绘 查看原图 这样,我们只需检查用户的最终瓦片是否包含交通事故瓦片,即可判断用户是否受影响。
我们还可以跟踪正在导航的用户的所有可能路线,并在有更快的新路线时通知他们。
交付协议
我们有几种方案可以主动从服务器向客户端推送数据:
移动推送通知不可行,因为其载荷有限,而且 Web 应用无法使用
WebSocket 通常比长轮询更好,因为它在服务器上的计算开销更小
我们也可以使用服务器发送事件(SSE),但更倾向于 WebSocket,因为它支持双向通信,这在例如最后一公里配送功能中会很有用
第 4 步:总结
这是我们的最终设计:
最终设计:自适应 ETA 与重规划 在导航服务的基础上加入「自适应 ETA 与重规划」:它订阅路况 DB 的变化,并维护一张活跃用户表(记录每位导航中用户将要经过的各级瓦片)。一旦某块瓦片发生事故,就能立刻找出受影响的用户并下发新路线。 移动端 发起导航 导航服务 地理编码服务 地理编码 DB 地理编码 路线规划服务 排序服务 过滤服务 最短路服务 路由瓦片 对象存储 ETA 服务 路况 DB 路况更新服务 位置 DB Cassandra 自适应 ETA / 重规划 自适应重规划 活跃用户 活跃用户 请求 规划 订阅 地址 查询 排序 路径 ETA 过滤 取瓦片 路况 更新 写入 读路况 重规划 新增:按瓦片索引导航中的用户,事故即重规划 只存各级祖先瓦片,检查终点瓦片即可 按 diagram-design 重绘 查看原图 我们还可以提供一个附加功能——多途经点导航,它可以卖给 Uber 或 Lyft 等企业客户,用于确定为访问一组地点所需的最优路径。
第 19 章:分布式消息队列
引言
本章我们将设计一个分布式消息队列 。
消息队列的好处:
解耦 :消除组件之间的紧耦合,让它们可以独立更新。更好的可扩展性 :生产者和消费者可以根据流量独立扩展。更高的可用性 :如果系统某部分宕机,其他部分仍然可以继续与队列交互。更好的性能 :生产者可以在不等待消费者确认的情况下生产消息。
一些流行的消息队列实现:Kafka、RabbitMQ、RocketMQ、Apache Pulsar、ActiveMQ、ZeroMQ。
严格来说,Kafka 和 Pulsar 不是消息队列,它们是事件流平台。
然而,功能的融合模糊了消息队列和事件流平台之间的区别。
本章我们将构建一个消息队列,它支持更高级的特性,例如长数据保留、重复消息消费等。
第 1 步:理解问题并确定设计范围
消息队列应该支持一些基本功能——生产者生产消息,消费者消费消息。
然而,在性能、消息传递、数据保留等方面有不同的考虑。
以下是候选人与面试官之间可能提出的一组问题:
候选人:消息的格式和平均大小是什么?只有文本吗?
面试官:消息仅限文本,通常只有几 KB。
候选人:消息可以被重复消费吗?
面试官:可以,消息可以被不同的消费者重复消费。这是额外的要求,传统消息队列不支持。
候选人:消息会按照生产顺序被消费吗?
面试官:是的,需要保证顺序。这是额外的要求,传统消息队列不支持。
候选人:数据保留需求是什么?
面试官:消息需要保留两周。这是额外的要求。
候选人:我们希望支持多少生产者和消费者?
面试官:越多越好。
候选人:我们希望支持哪种数据传递语义?至多一次、至少一次、精确一次?
面试官:我们肯定要支持至少一次。理想情况下,可以支持所有语义并使其可配置。
候选人:端到端延迟的目标吞吐量是多少?
面试官:它应该支持日志聚合等用例的高吞吐量,并支持更传统用例的低吞吐量。
功能需求
生产者将消息发送到消息队列
消费者从队列中消费消息
消息可以被消费一次或多次
历史数据可以被截断
消息大小在 KB 范围内
需要保持消息的顺序
数据传递语义可配置——至多一次/至少一次/精确一次。
非功能需求
高吞吐量或低延迟 :可根据用例配置可扩展 :系统应该是分布式的,并能支持消息量的突然激增持久且耐用 :数据应持久化到磁盘并在节点之间复制
传统消息队列通常不支持数据保留,也不提供顺序保证。这大大简化了设计,我们将对此进行讨论。
第 2 步:提出高层设计并获得认可
消息队列的关键组件:
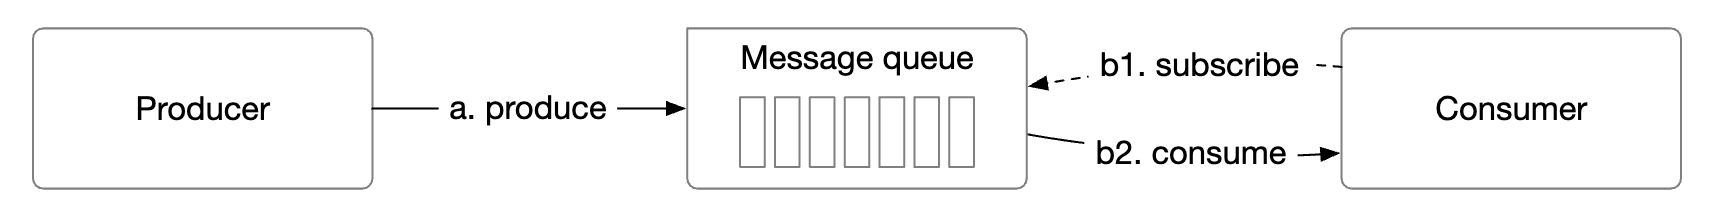
消息队列的核心组件 生产者把消息发到消息队列,消费者订阅队列并消费消息。队列居中解耦两端,让生产者和消费者可以各自独立伸缩——两者都是客户端,消息队列是服务端。 生产者 消息队列 消费者 生产 消费 订阅 生产者与消费者互不感知,只与队列交互 按 diagram-design 重绘 查看原图
生产者将消息发送到队列
消费者订阅队列并消费订阅的消息
消息队列是中间的服务,将生产者与消费者解耦,使它们能够独立扩展。
生产者和消费者都是客户端,而消息队列是服务端。
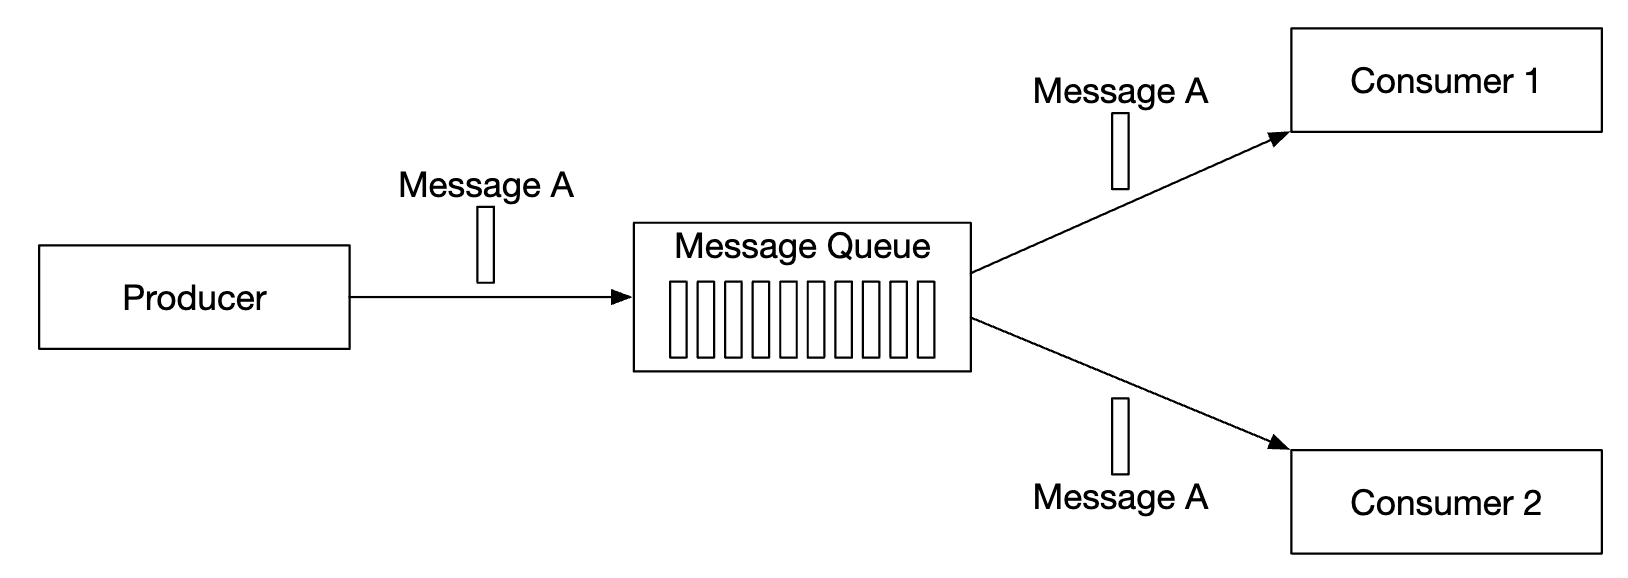
消息模型 第一种消息模型是点对点,它常见于传统消息队列中:
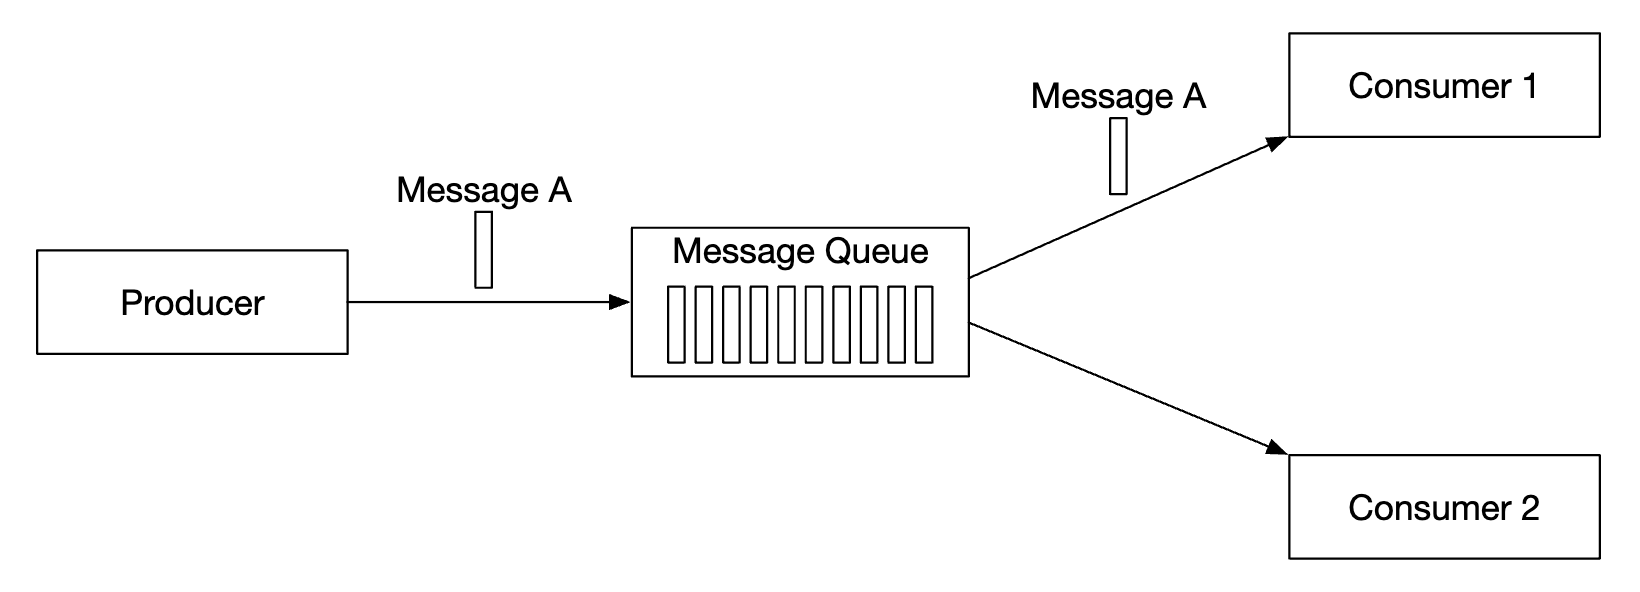
点对点模型 消息发到队列后只会被一个消费者消费:即使有多个消费者,同一条消息也仅投递给其中一个;一旦被确认消费即从队列移除,因此传统点对点模型没有数据保留。 生产者 消息队列 消费者 1 消费者 2 生产 消息 A 同一条消息只投递给一个消费者 确认消费后即从队列移除 按 diagram-design 重绘 查看原图
消息被发送到队列,并且只能由一个消费者消费。
可以有多个消费者,但一条消息只会被消费一次。
一旦消息被确认消费,它就会从队列中移除。
点对点模型中没有数据保留,但在我们的设计中有。
另一方面,发布-订阅模型在事件流平台中更为常见:
发布订阅模型 消息关联到某个 topic,订阅该 topic 的每个消费者都会收到全部消息。与点对点不同,同一条消息会被广播给所有订阅者,这是事件流平台更常见的模型。 生产者 消息队列 消费者 1 消费者 2 发布 消息 A 消息 A 订阅同一 topic 的消费者都收到消息 按 diagram-design 重绘 查看原图
在这个模型中,消息与主题相关联。
消费者订阅某个主题,并接收发送到该主题的所有消息。
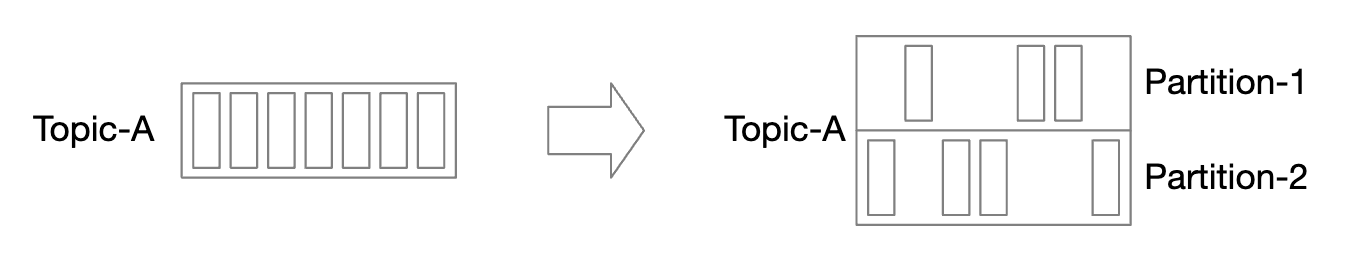
主题、分区和代理 如果某个主题的数据量太大怎么办?一种扩展方法是将主题拆分为多个分区(也称为分片):
Topic 拆分为分区 当单个 topic 的数据量过大时,可以把它拆成多个分区来横向扩展。发往 topic 的消息被均匀分到各分区,每个分区像一条 FIFO 队列,分区内保持消息顺序;承载分区的服务器称为 broker。 Topic-A 分区 1 Partition-1 Topic-A Partition-2 Topic-A 均匀分布 分区内 FIFO;消息位置即 offset 按 diagram-design 重绘 查看原图
发送到主题的消息会均匀分布到各个分区
承载分区的服务器称为代理
每个主题像队列一样使用 FIFO 处理消息。消息顺序在单个分区内得到保证。
消息在分区内的位置称为偏移量 。
每条生产的消息都会发送到特定的分区。分区键指定消息应落入哪个分区。
例如,可以使用 user_id 作为分区键,以保证同一用户的消息顺序。
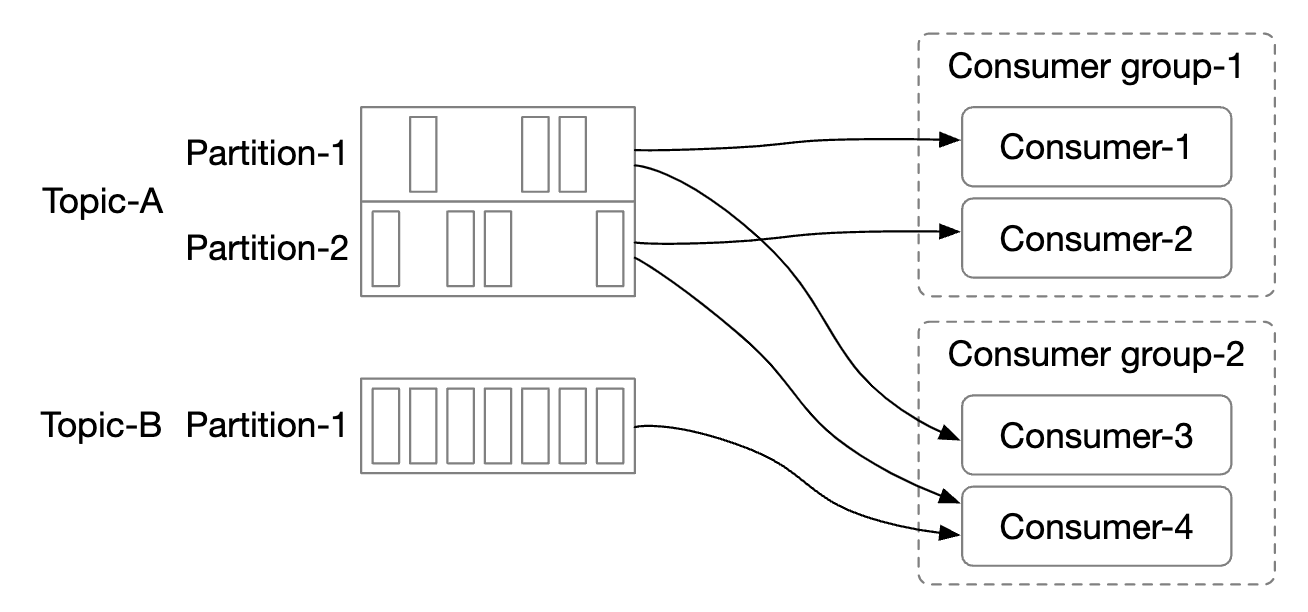
每个消费者订阅一个或多个分区。当多个消费者消费相同消息时,它们组成一个消费者组。
消费者组 消费者组是一组协同工作、从主题中消费消息的消费者:
消费组 消费组是一组协同消费同一 topic 的消费者。消息按消费组(而非按消费者)复制,每个组各自维护 offset;组内每个分区只允许一个消费者订阅,因此并行读能提升吞吐,同时保留分区内的顺序。 消费组 1 消费组 2 Partition-1 Topic-A Partition-2 Topic-A Partition-1 Topic-B 消费者 1 消费者 2 消费者 3 消费者 4 订阅 组内一个分区只被一个消费者订阅 按 diagram-design 重绘 查看原图
消息按消费者组复制(而不是按消费者)。
每个消费者组维护自己的偏移量。
消费者组并行读取消息可以提高吞吐量,但会削弱顺序保证。
可以通过只允许组中的一个消费者订阅某个分区来缓解这个问题。
这意味着组中的消费者数量不能超过分区数量。
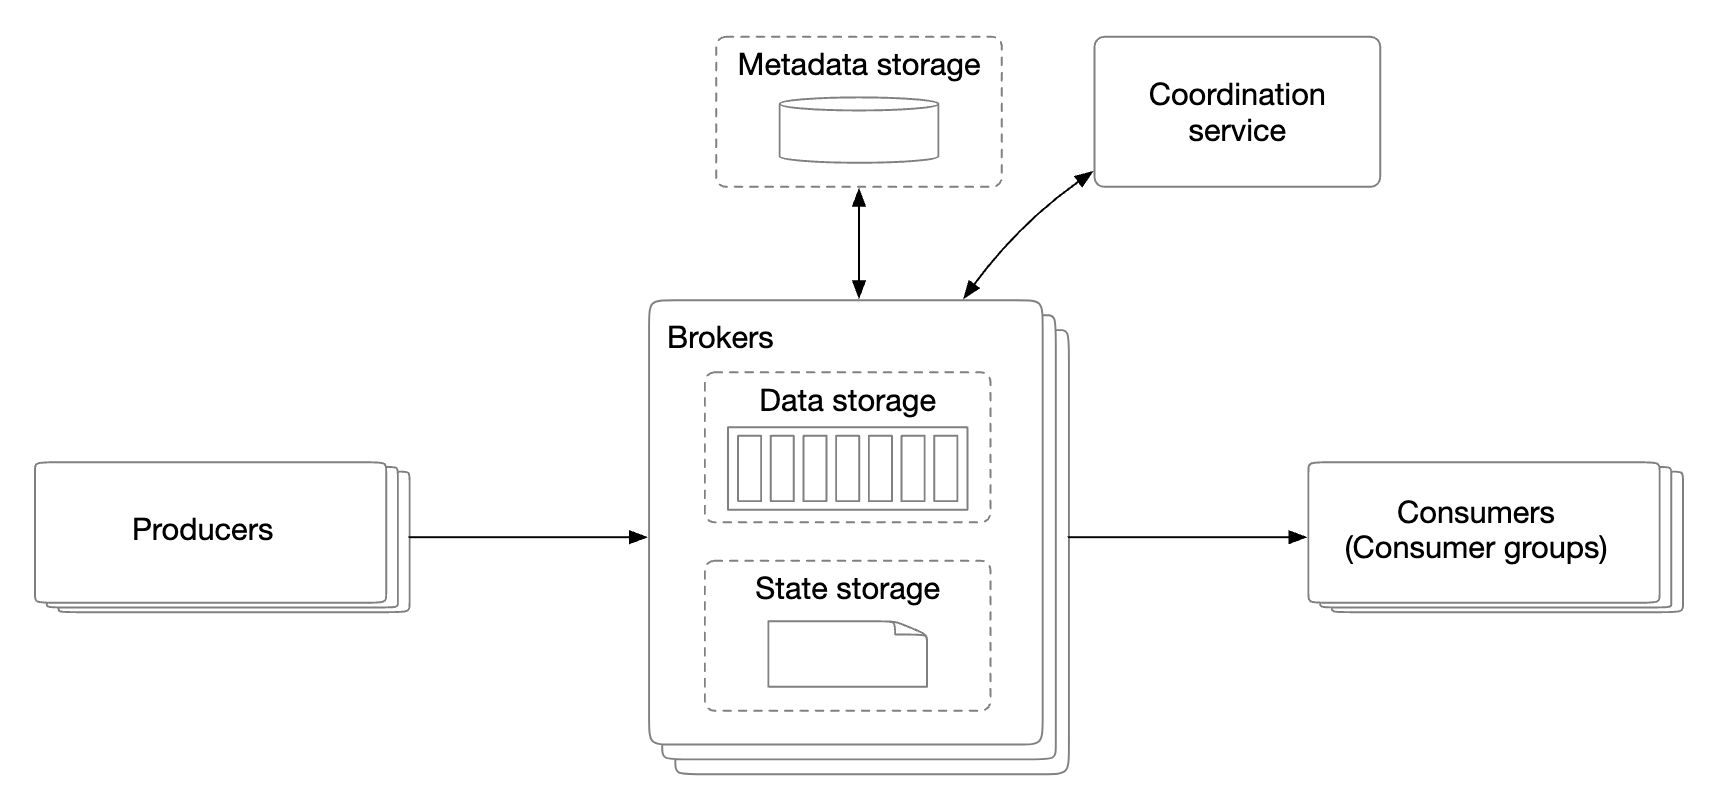
高层架构
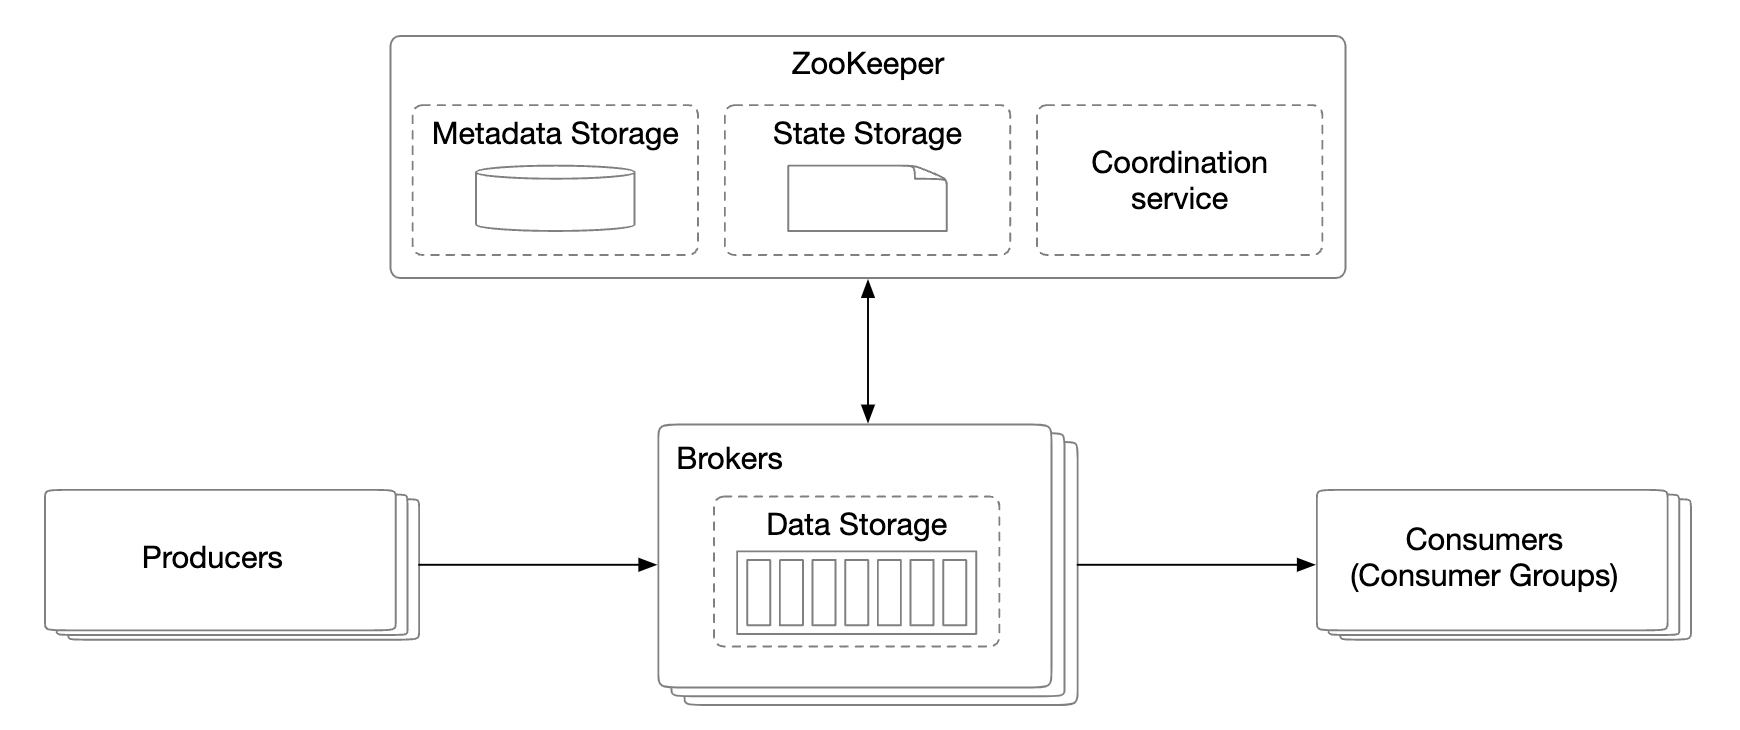
消息队列高层架构 生产者把消息推给指定 topic,消费组订阅并消费。Broker 持有多个分区,消息持久化在数据存储里,消费状态单独存放;元数据存储保存配置与 topic 属性,协调服务负责服务发现(哪些 broker 存活)与 leader 选举。 生产者 Brokers 分区 + 副本 消费者 数据存储 消息分段 状态存储 消费偏移 元数据存储 配置 / Topic 协调服务 发现 / 选举 生产 消费 写消息 存偏移 协调服务负责发现与选举 按 diagram-design 重绘 查看原图
客户端 :生产者和消费者。生产者将消息推送到指定主题。消费者组订阅某个主题的消息。代理 :持有多个分区。一个分区保存某个主题的消息子集。数据存储 :在分区中存储消息。状态存储 :保存消费者状态。元数据存储 :存储配置和主题属性协调服务 :负责服务发现(哪些代理是存活的)和领导者选举(哪个代理是领导者,负责分配分区)。
第 3 步:设计深入探讨
为了实现高吞吐量并满足高数据保留要求,我们做了一些重要的设计选择:
我们选择了一种磁盘数据结构,它利用了现代 HDD 的特性以及现代操作系统的磁盘缓存策略。
消息数据结构是不可变的,以避免额外复制,这是我们在高容量/高流量系统中希望避免的。
我们围绕批处理设计写入,因为小 I/O 是高吞吐量的大敌。
数据存储 为了找到最适合消息的数据存储,我们必须考察消息的特性:
写入密集、读取密集
没有更新/删除操作。在传统消息队列中,由于消息不被保留,存在“删除”操作。
主要是顺序读写访问模式。
我们有哪些选择:
数据库 :不太理想,因为典型数据库不能很好地同时支持写入密集和读取密集的系统。预写日志(WAL) :一种纯文本文件,仅支持追加写入,对 HDD 非常友好。
我们将分区拆分为多个段,以避免维护非常大的文件。
旧段是只读的。只有最新段接受写入。
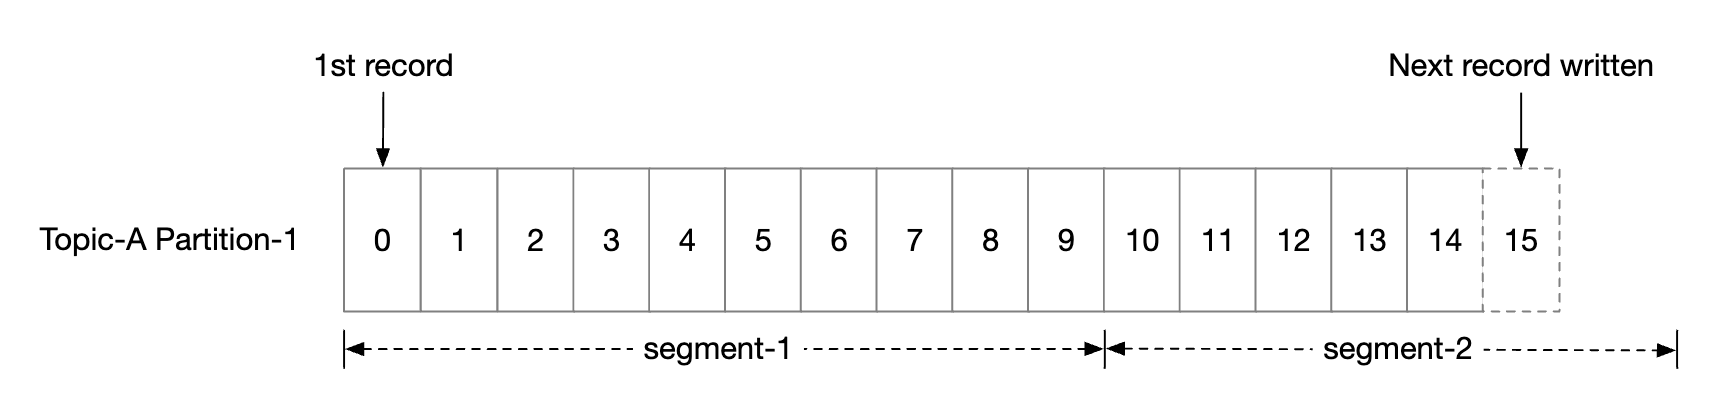
WAL 分段存储 分区用只追加的 write-ahead log 落盘,并拆成多个 segment 以免单个文件过大。旧 segment 只读,只有最新的 segment 接收写入;顺序追加对机械硬盘极其友好,再叠加操作系统页缓存即可获得可观吞吐。 segment-1(只读) segment-2(可写) 0 1 2 3 4 5 6 7 8 9 Topic-A Partition-1:offset 从 0 顺序追加 写满后滚动出新 segment,旧段转只读 按 diagram-design 重绘 查看原图 WAL 文件在传统 HDD 上使用时效率极高。
有一个误解是 HDD 访问很慢,但这在很大程度上取决于访问模式。
当访问模式是顺序的(如我们的场景),HDD 可以达到几 MB/s 的读写速度,足以满足我们的需求。
我们还利用了操作系统会积极地在内存中缓存磁盘数据这一事实。
消息数据结构 消息模式在生产者和消费者以及队列之间保持一致非常重要,以避免额外复制。这可以大大提高处理效率。
示例消息结构:
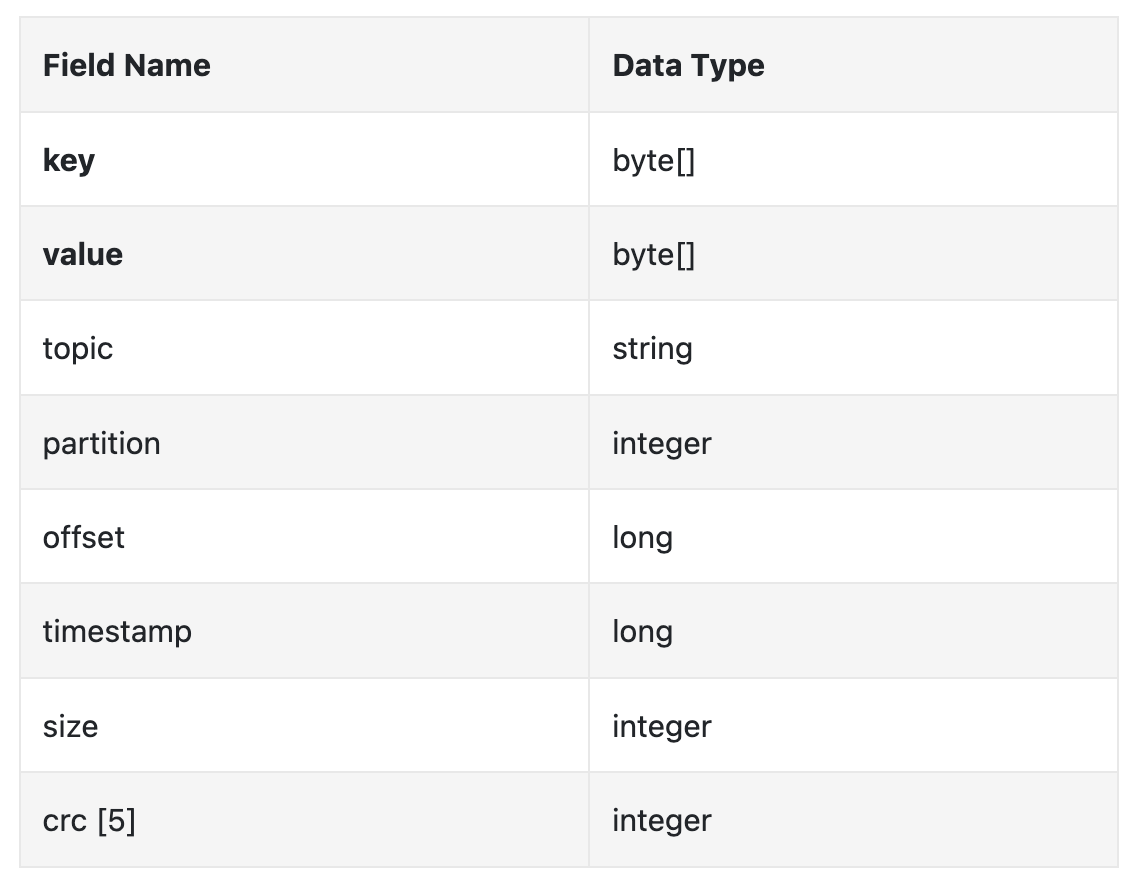
消息结构 生产、队列、消费者三方共用同一套 schema 才能避免额外拷贝。key 决定消息落到哪个分区(如 hash(key) % numPartitions),value 是负载;topic、partition、offset 三者可唯一定位一条消息,timestamp、size、crc 则用于时序、计量与完整性校验。 key byte[] value byte[] topic string partition integer offset long timestamp long size integer crc integer key 决定分区;key 无需唯一,也可缺省 topic + partition + offset 唯一定位一条消息 按 diagram-design 重绘 查看原图 消息的键指定消息属于哪个分区。一个映射示例是 hash(key) % numPartitions。
为了更灵活,生产者可以覆盖默认键,以控制消息分发到哪些分区。
消息值是消息的有效载荷。它可以是纯文本或压缩的二进制块。
**注意:**与传统 KV 存储不同,消息键不必是唯一的。允许存在重复键,甚至也可以缺失。
其他消息字段:
主题 :消息所属的主题分区 :消息所属分区的 ID偏移量 :消息在分区中的位置。可以通过 topic、partition、offset 定位消息。时间戳 :消息存储的时间大小 :此消息的大小CRC :校验和,用于确保消息完整性
通过添加额外字段,可以支持过滤等附加功能。
批处理 批处理对于系统性能至关重要。我们在生产者、消费者和消息队列中都应用了批处理。
它之所以重要,是因为:
它允许操作系统将消息分组,从而分摊昂贵的网络往返开销
消息按组顺序写入 WAL,这会带来大量顺序写入和磁盘缓存。
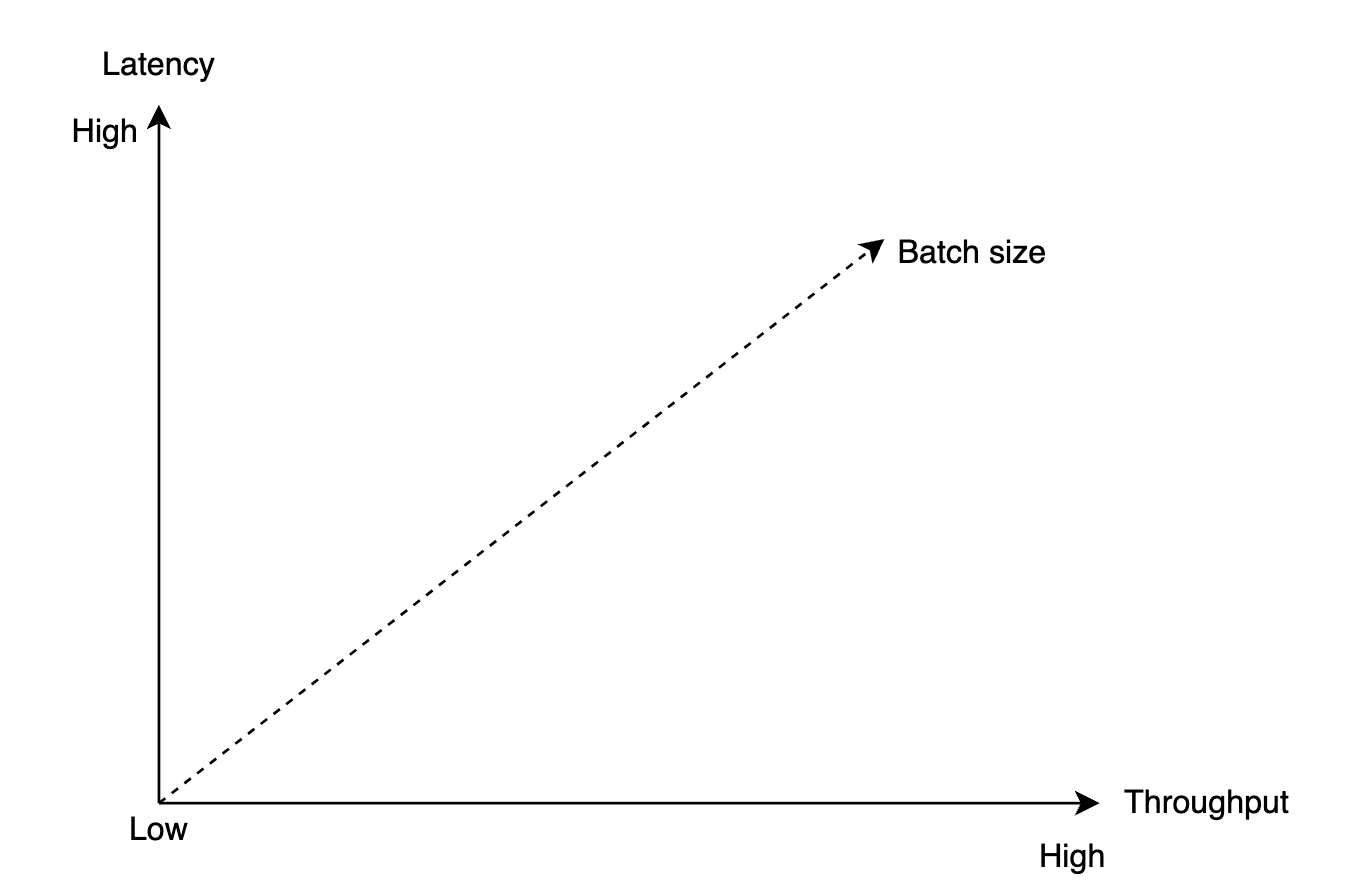
在延迟和吞吐量之间存在权衡:
较高的批处理会带来更高的吞吐量和更高的延迟。
较低的批处理会带来较低的吞吐量和较低的延迟。
如果因为系统作为传统消息队列部署而需要支持较低的延迟,可以将系统调整为使用较小的批大小。
如果针对吞吐量进行调优,我们可能需要每个主题有更多分区,以弥补较慢的顺序磁盘写入吞吐量。
生产者流程 如果生产者想要向某个分区发送消息,它应该连接到哪个代理?
一种选择是引入路由层,将消息路由到正确的代理。如果启用了复制,正确的代理就是主副本:
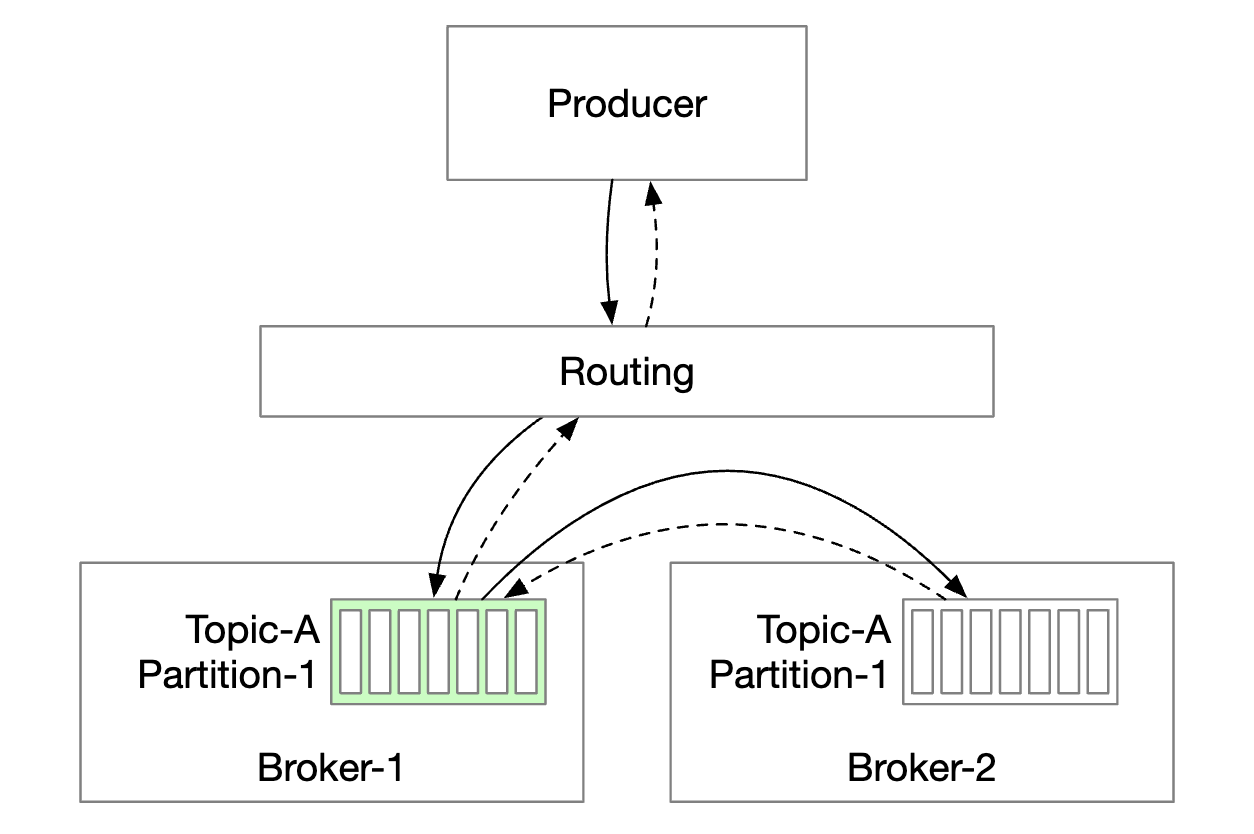
独立路由层 路由层从元数据存储读取副本分布计划并缓存,生产者把消息发给它,它再转发给该分区的 leader 副本。从副本向 leader 拉取新消息,确认足够多后 leader 提交并回 ack;代价是多了一跳网络往返,且不利于批量发送。 生产者 路由层 Broker-1 Topic-A P1 · leader Broker-2 Topic-A P1 · follower 生产 转发给 leader 复制拉取 leader 提交后向生产者返回 ack 按 diagram-design 重绘 查看原图
路由层从元数据存储中读取复制计划并在本地缓存。
生产者将消息发送到路由层。
消息被转发到代理 1,它是给定分区的主副本
从副本从主副本拉取新消息。一旦收到足够的确认,主副本就提交数据并响应生产者。
拥有副本的原因是为了实现容错。
这种方法可行,但有一些缺点:
由于额外的组件导致额外的网络跳数
该设计不支持消息批处理
为了缓解这些问题,我们可以将路由层嵌入到生产者中:
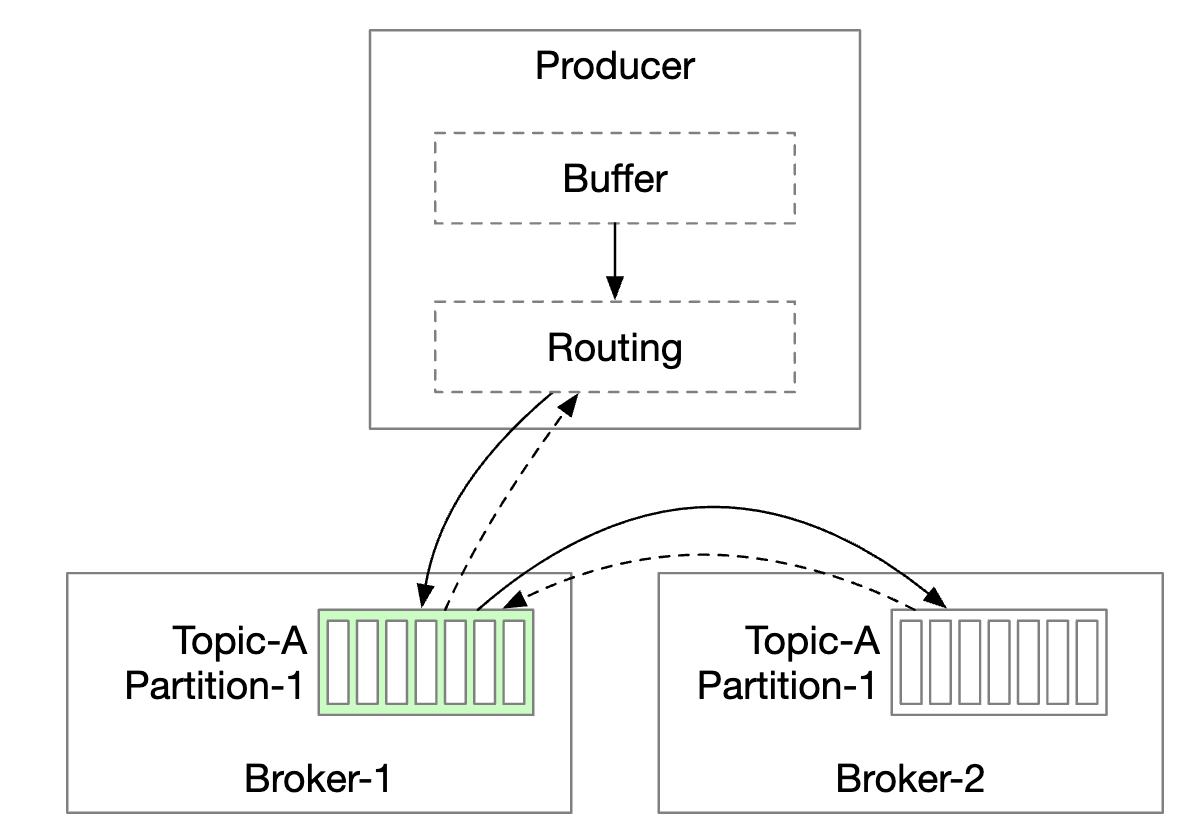
路由层内嵌到生产者 把路由层搬进生产者可以省掉一跳、降低延迟,也让生产者自己决定消息进哪个分区。生产者内的缓冲区把消息在内存里攒成更大的批次再一次性发出,从而提升吞吐。 生产者 缓冲区 批量攒消息 路由层 按分区路由 Broker-1 Topic-A P1 · leader Broker-2 Topic-A P1 · follower 路由到 leader 复制 少一跳、可自行控分区、可攒批 按 diagram-design 重绘 查看原图
更少的网络跳数带来更低的延迟
生产者可以控制消息路由到哪个分区
缓冲区允许我们在内存中批量处理消息,并在单个请求中发送更大的批次,从而提高吞吐量。
批大小的选择是吞吐量与延迟之间的经典权衡。
批量大小的取舍 批量是吞吐与延迟之间的经典权衡:批量越大,攒批等待越久、延迟越高,但单次请求摊薄了网络往返、吞吐越高;批量越小,请求发得越早、延迟越低,吞吐也随之下降。按传统消息队列场景调小批量,按日志聚合场景调大批量。 小批量 低延迟 · 低吞吐 大批量 高延迟 · 高吞吐 批量增大 批量是吞吐与延迟的经典权衡 追求吞吐时需更多分区来补偿顺序写 按 diagram-design 重绘 查看原图
较大的批大小会导致提交之前的等待时间更长。
较小的批大小会导致请求更早发送,延迟更低,但吞吐量更低。
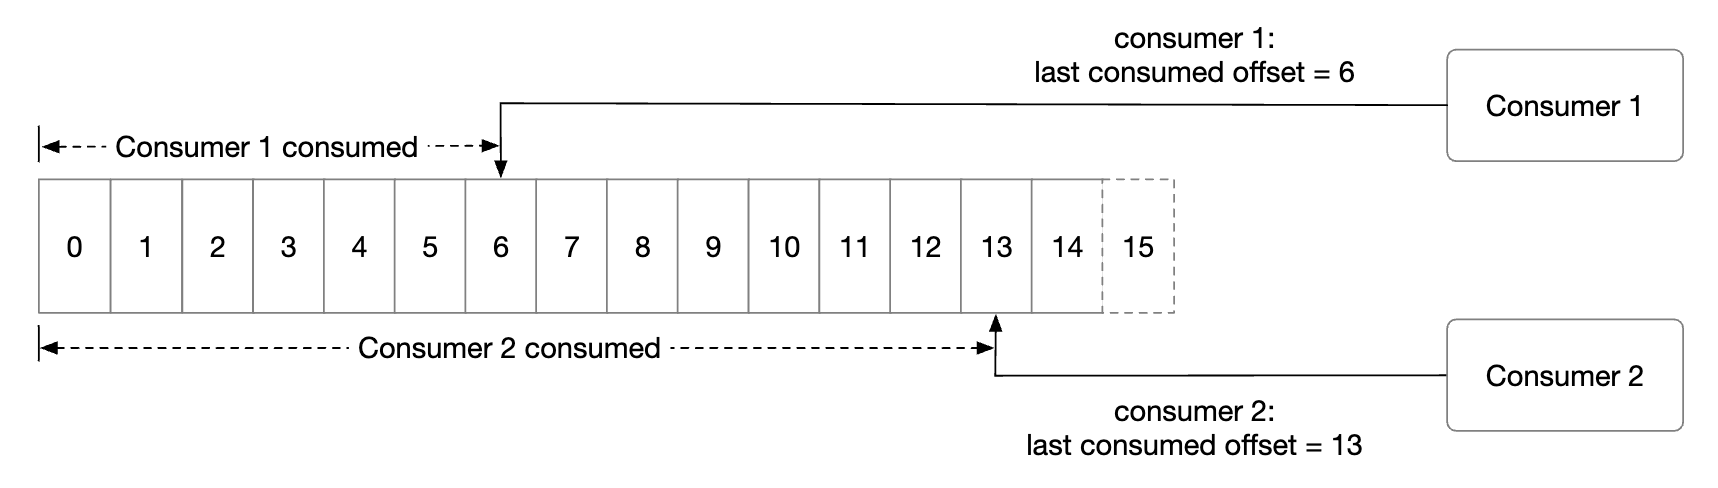
消费者流程 消费者指定其在分区中的偏移量,并从该偏移量开始接收一批消息:
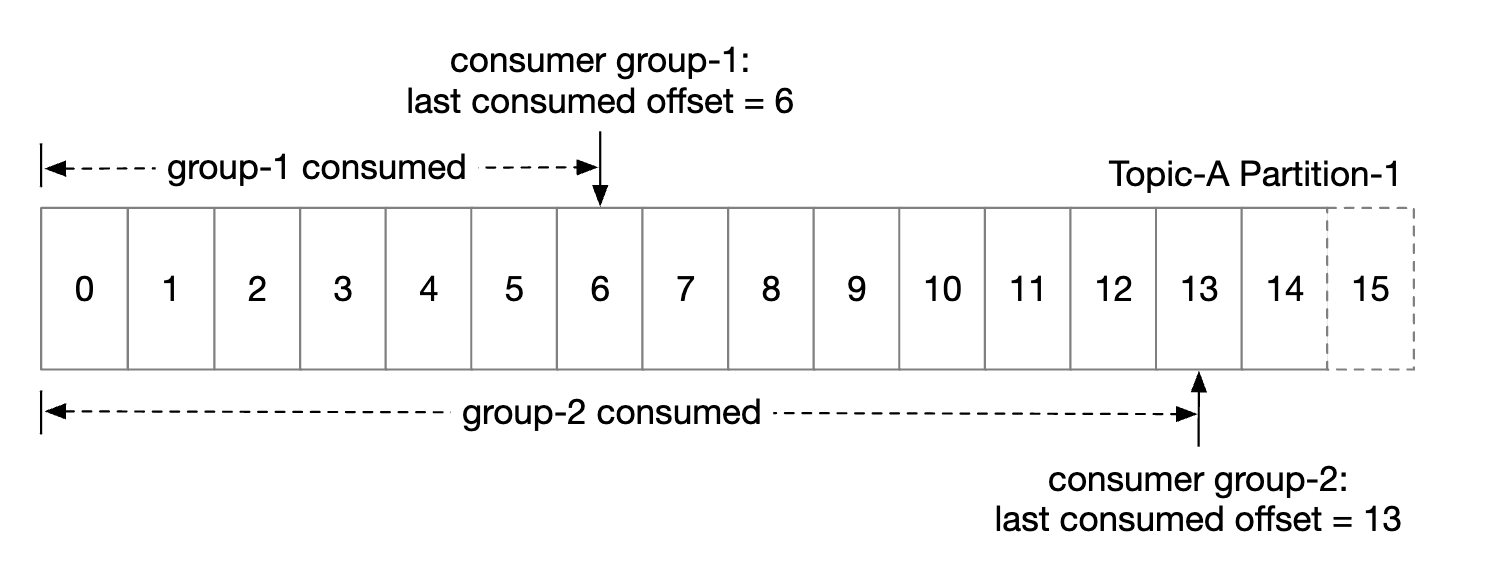
消费者按 offset 拉取 消费者在分区里指定自己的 offset,从该位置开始接收一批消息。示例中消费者 1 已消费到 offset 6、消费者 2 已消费到 offset 13;读取位置由消费者自己维护,因此可以回放或跳过。 Topic-A Partition-1 offset 0–15 消费者 1 last offset = 6 消费者 2 last offset = 13 拉取 拉取 offset 由消费者自己维护,可回放 按 diagram-design 重绘 查看原图 设计消费者时的一个重要考虑是使用推送模型还是拉取模型:
推送模型 :由于代理在收到消息时将其推送给消费者,因此有较低的延迟。
但是,如果消费速率落后于生产速率,消费者可能会被压垮。
由于代理控制消费速率,因此很难处理处理能力不同的消费者。
拉取模型 :使消费者控制消费速率。
如果消费速率较慢,消费者不会被压垮,我们可以扩展它以跟上进度。
拉取模型更适合批处理,因为在推送模型中,代理无法知道消费者能够处理多少消息。
另一方面,在拉取模型中,消费者可以主动拉取大批消息。
缺点是当没有新消息时会有更高的延迟和额外的网络调用。后一个问题可以通过长轮询来缓解。
因此,大多数消息队列(以及我们)选择拉取模型。
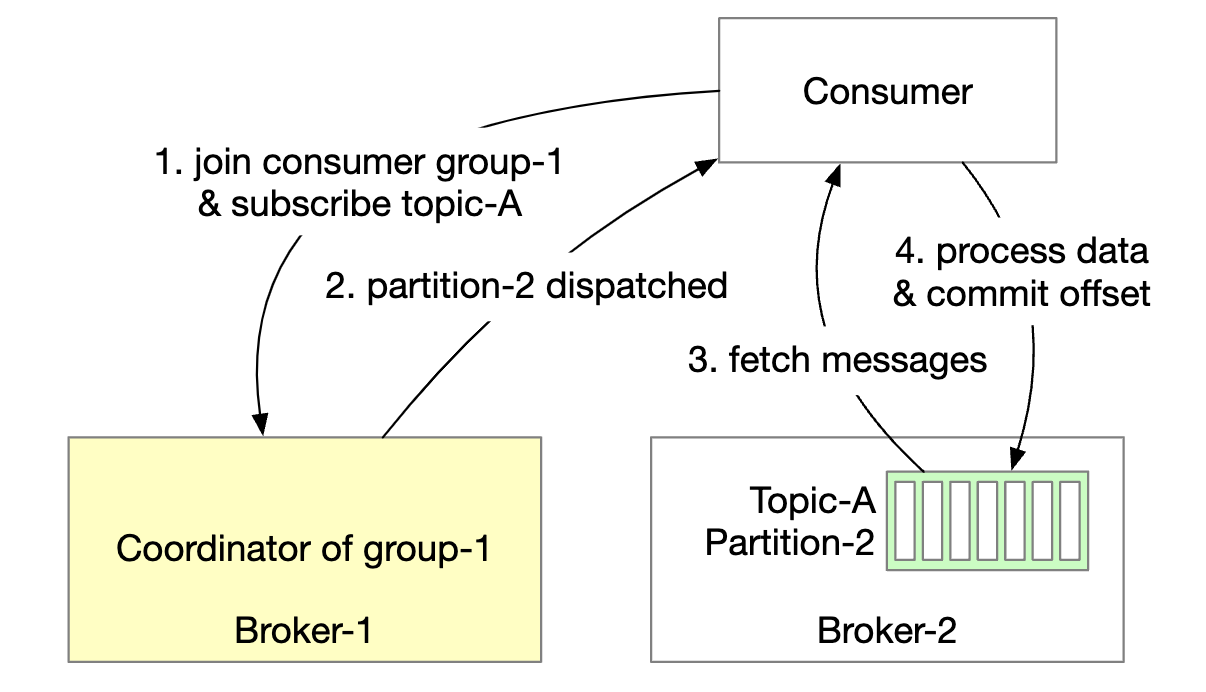
消费者接入流程 新消费者订阅 topic A 并加入 group-1;协调者由 group 名哈希定位,因此同组消费者都连到同一个 broker。协调者确认加入并把分区 2 分配给该消费者,消费者从上次 offset 拉取、处理,再把 offset 提交回 broker——这两步的先后决定了投递语义。 消费者 新加入 Broker-1 group-1 协调者 Broker-2 Topic-A Partition-2 1. 加入组 2. 分配分区 3. 拉取消息 4. 处理消息后再提交 offset 按 diagram-design 重绘 查看原图
新消费者订阅主题 A 并加入组 1。
通过对组名进行哈希来找到正确的代理节点。这样,组中的所有消费者都连接到同一个代理。
请注意,此消费者组协调器不同于协调服务(ZooKeeper)。
协调器确认消费者已加入组,并将分区 2 分配给该消费者。
有不同的分区分配策略——轮询、范围等。
消费者从上一个偏移量开始拉取最新消息。状态存储保存消费者偏移量。
消费者处理消息并将偏移量提交给代理。这些操作的顺序会影响消息传递语义。
消费者再平衡 消费者再平衡负责决定哪些消费者负责哪些分区。
当消费者加入/离开或分区被添加/移除时,会发生此过程。
代理作为协调器,在编排再平衡工作流中扮演着重要角色。
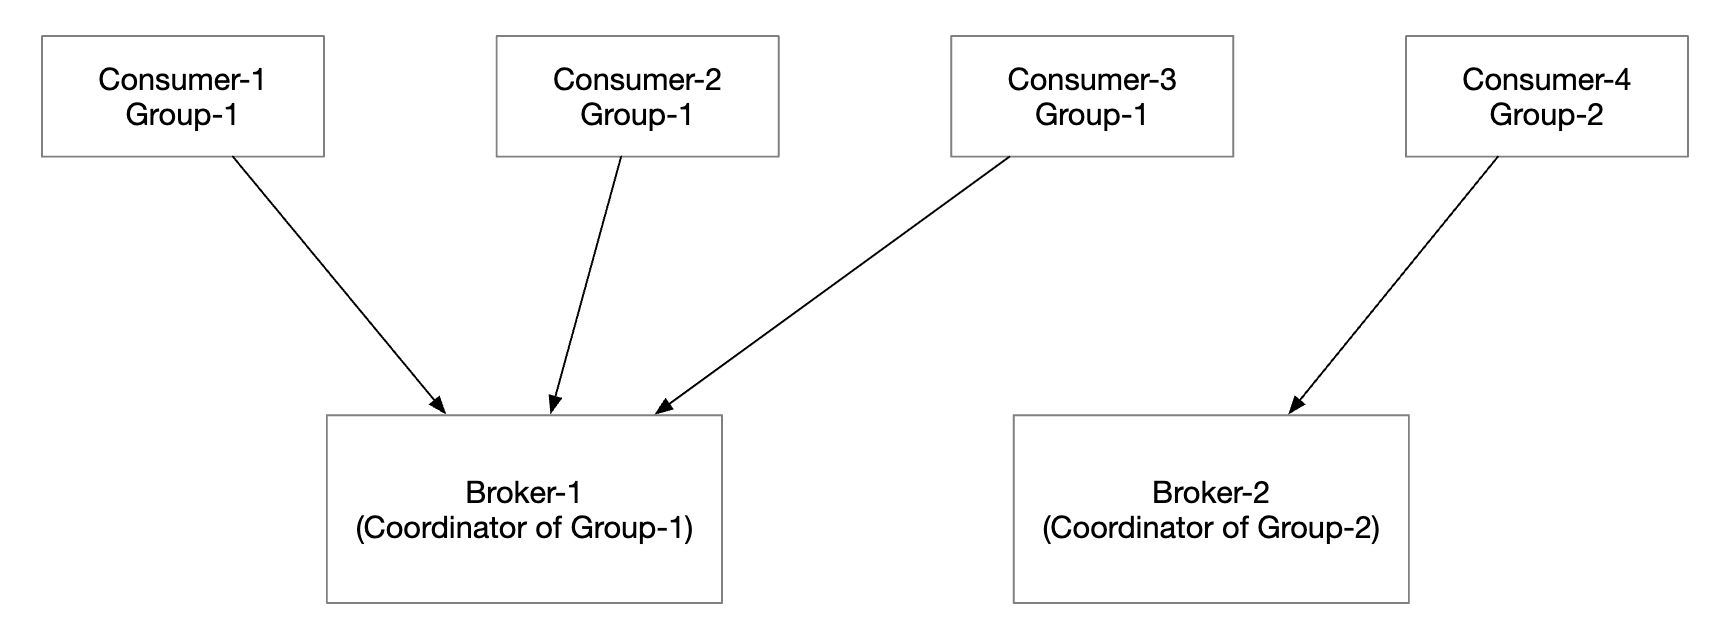
消费者重平衡 重平衡决定哪个消费者负责哪些分区,在消费者加入/离开或分区增删时触发。同组消费者都连到同一个协调者(按 group 名哈希得到);成员变化时协调者选出新的组 leader,由 leader 算出分区分配方案,经协调者广播给其余消费者。 消费者 1 Group-1 消费者 2 Group-1 消费者 3 Group-1 消费者 4 Group-2 Broker-1 Group-1 协调者 Broker-2 Group-2 协调者 心跳 协调者 = 按 group 名哈希选出的 broker 按 diagram-design 重绘 查看原图
来自同一组的所有消费者都连接到同一个协调器。协调器通过哈希组名找到。
当消费者列表发生变化时,协调器会选出组的新领导者。
组领导者计算新的分区分配计划,并将其报告给协调器,协调器将其广播给其他消费者。
当协调器不再收到组中消费者的心跳时,就会触发再平衡:
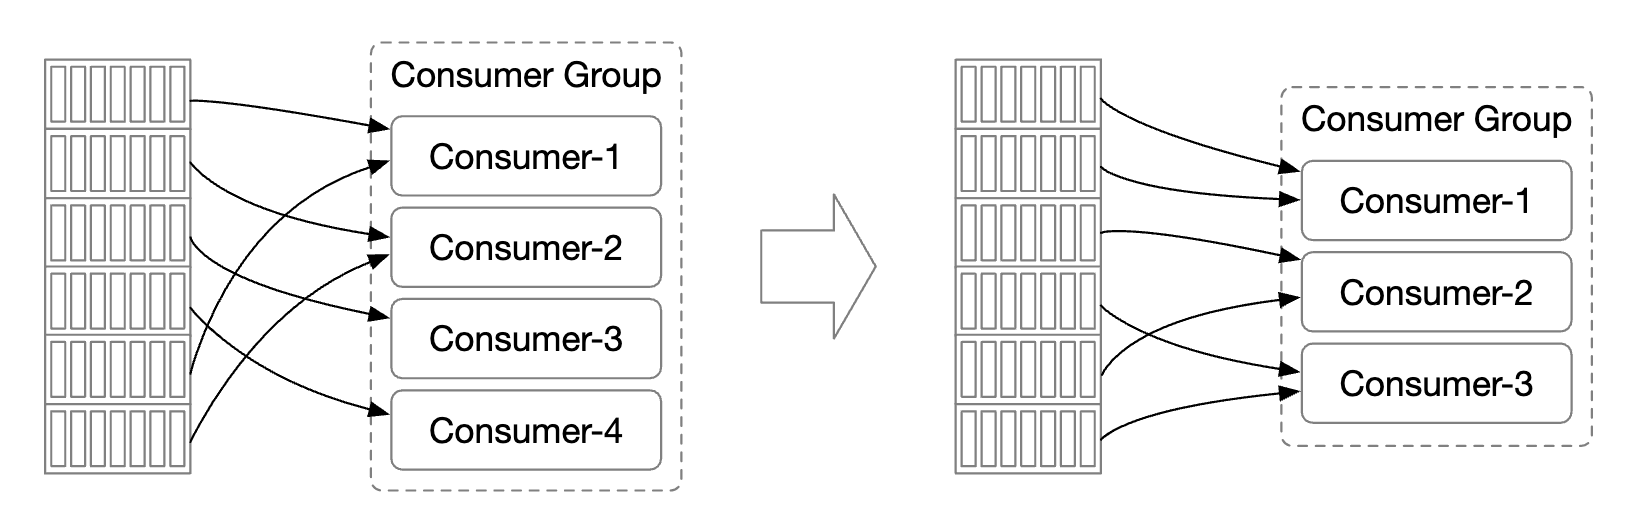
分区减少触发重平衡 分区数量变化会触发重平衡:左边 4 个分区对应组内 4 个消费者,分区减少到 3 个后,消费者列表也要相应收敛,每个分区仍只被一个消费者读取。 消费组 消费组 P1 P2 P3 P4 消费者 1 消费者 2 消费者 3 消费者 4 P1 P2 P3 消费者 1 消费者 2 消费者 3 分区数 4 → 3 重平衡收敛消费者 按 diagram-design 重绘 查看原图 让我们探讨当消费者加入组时会发生什么:
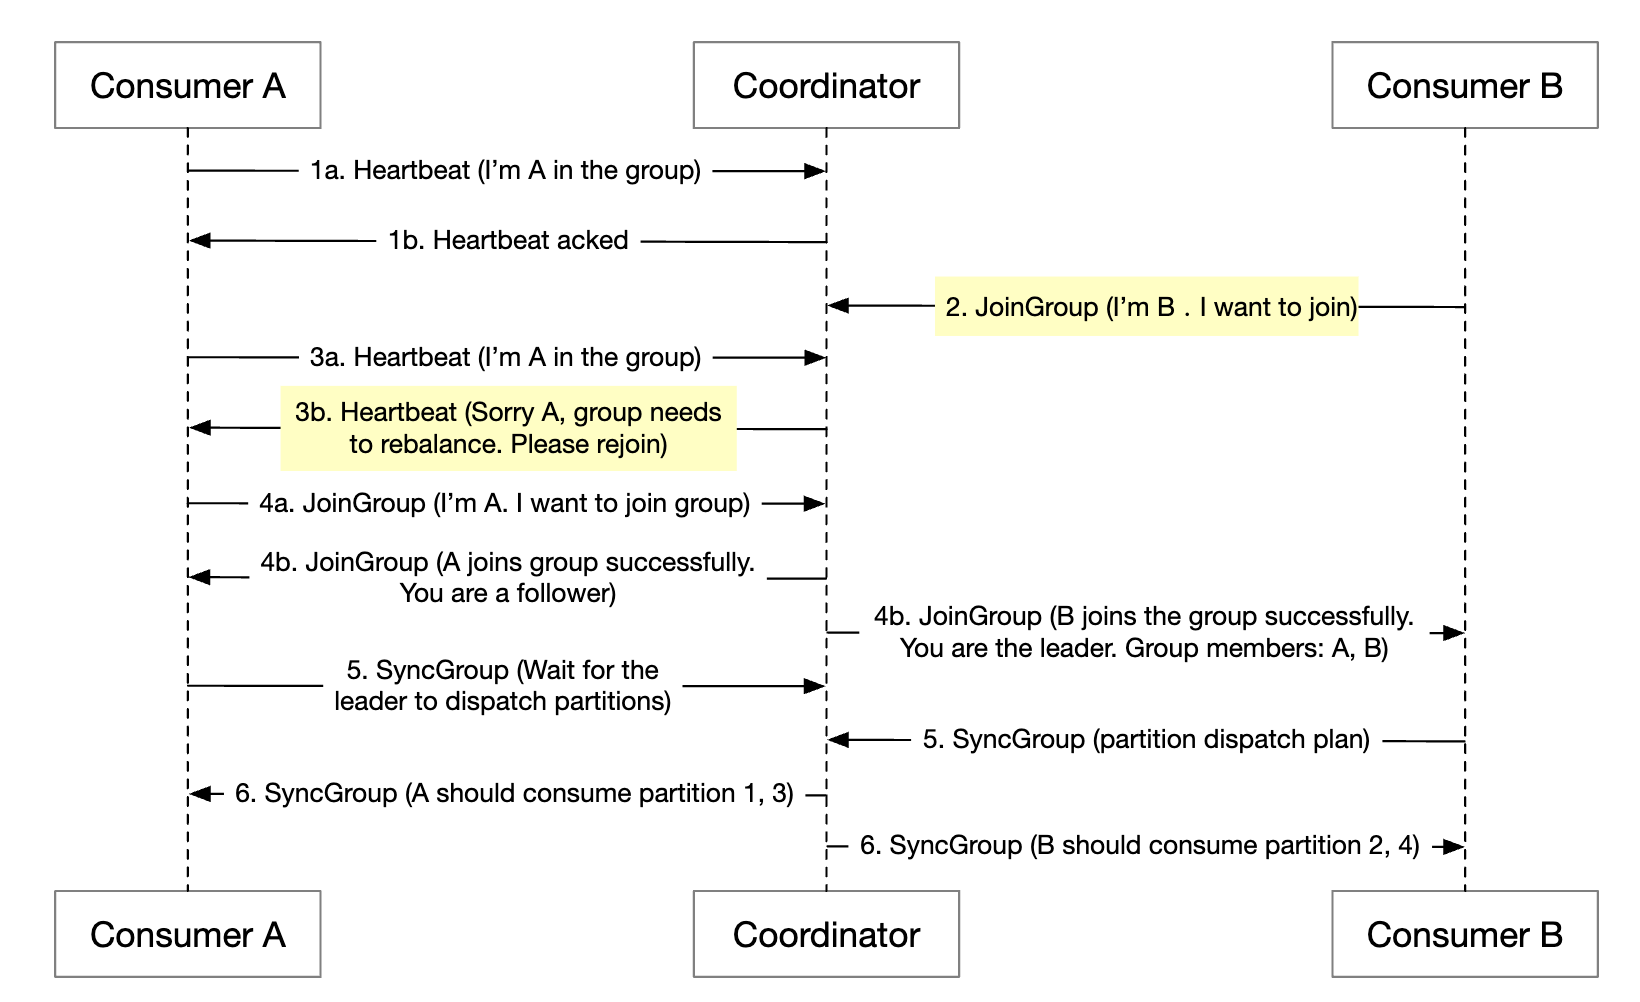
消费者加入组的时序 起初只有消费者 A 在组内、消费全部分区。B 请求加入后,协调者借心跳通知组内成员被动重平衡;成员重新加入后协调者选出 leader 并广播结果,leader 生成分区分配方案经协调者下发,随后各消费者开始消费新分到的分区。 消费者 A Coordinator 消费者 B 1a 心跳 3b 请求重平衡 4a 重新加入 2 加入组 4b 成为 leader 5 分发方案 同一组消费者都连到同一个协调者 按 diagram-design 重绘 查看原图
最初,组中只有消费者 A,它消费所有分区。
消费者 B 发送加入组的请求。
协调器通过心跳响应被动地通知所有组成员需要进行再平衡。
一旦所有消费者重新加入组,协调器就会选出一个领导者,并将选举结果通知其他消费者。
领导者生成分区分配计划并将其发送给协调器。其他消费者等待分配计划。
消费者开始从新分配的分区进行消费。
以下是当消费者离开组时会发生的情况:
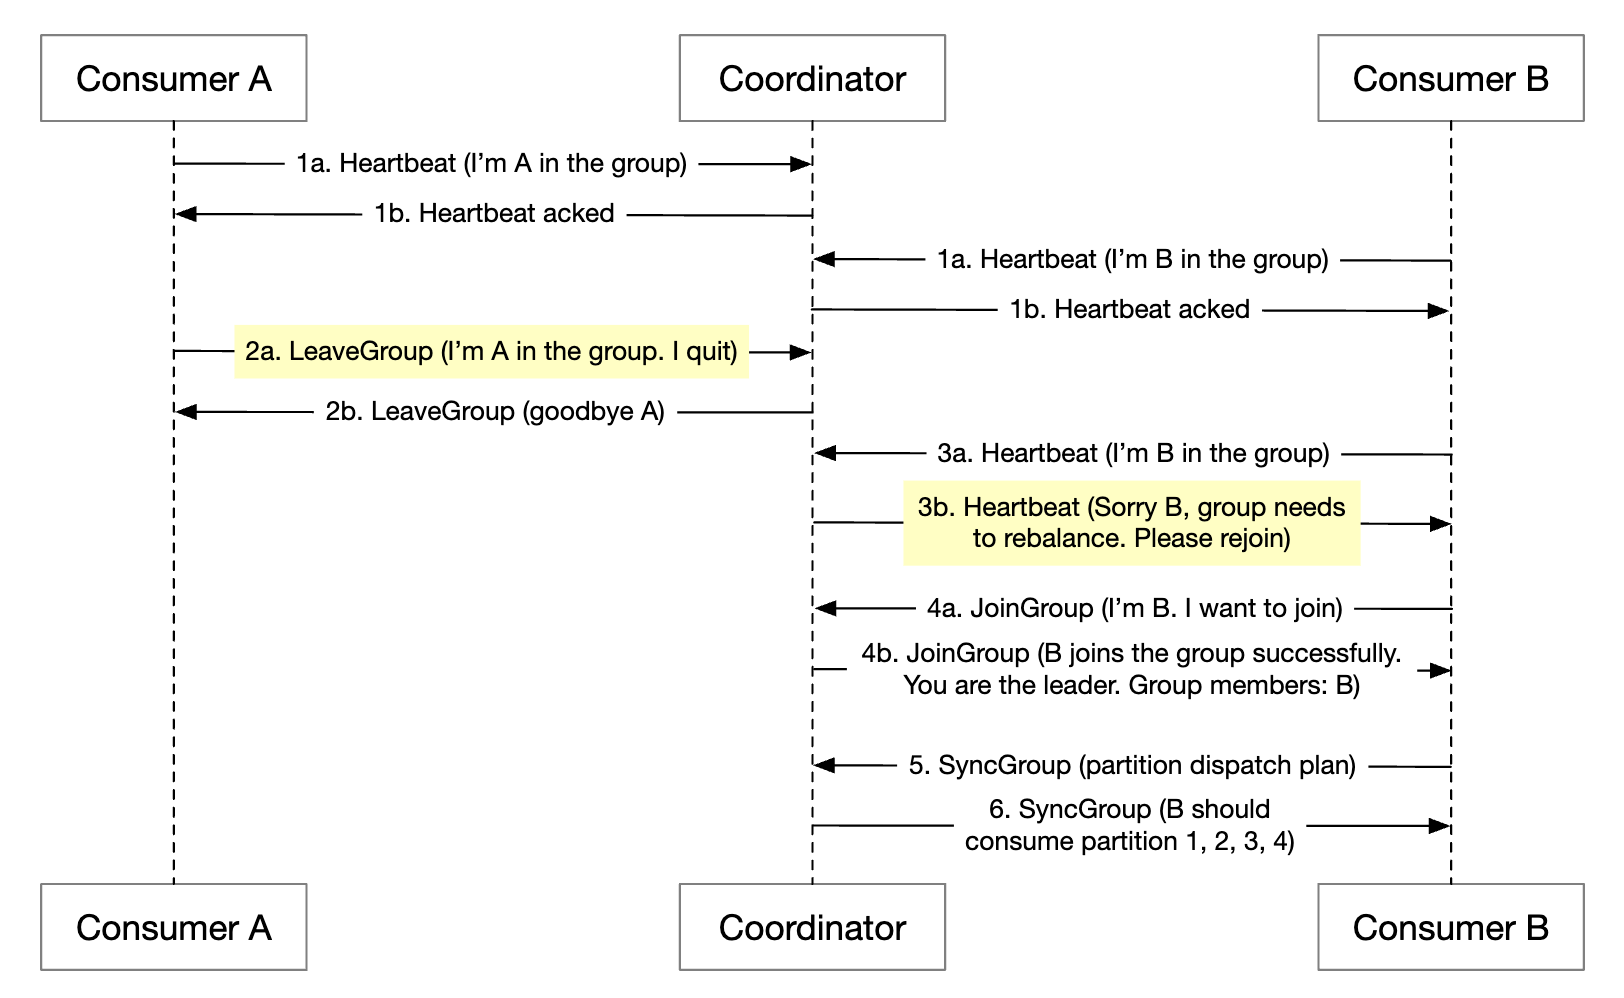
消费者离开组的时序 消费者 A、B 同组。B 请求退出后,协调者在收到 A 的心跳时告知需要重平衡;其余步骤与加入组一致——重新加入、选 leader、下发新的分区方案。 消费者 A Coordinator 消费者 B 1a 心跳 2a 退出组 2b 确认退出 3a 心跳 3b 请求重平衡 5 分发方案 离开组同样经心跳触发被动重平衡 按 diagram-design 重绘 查看原图
消费者 A 和 B 在同一个组中
消费者 B 请求离开组
当协调器收到 A 的心跳时,它会通知他们需要进行再平衡。
其余步骤相同。
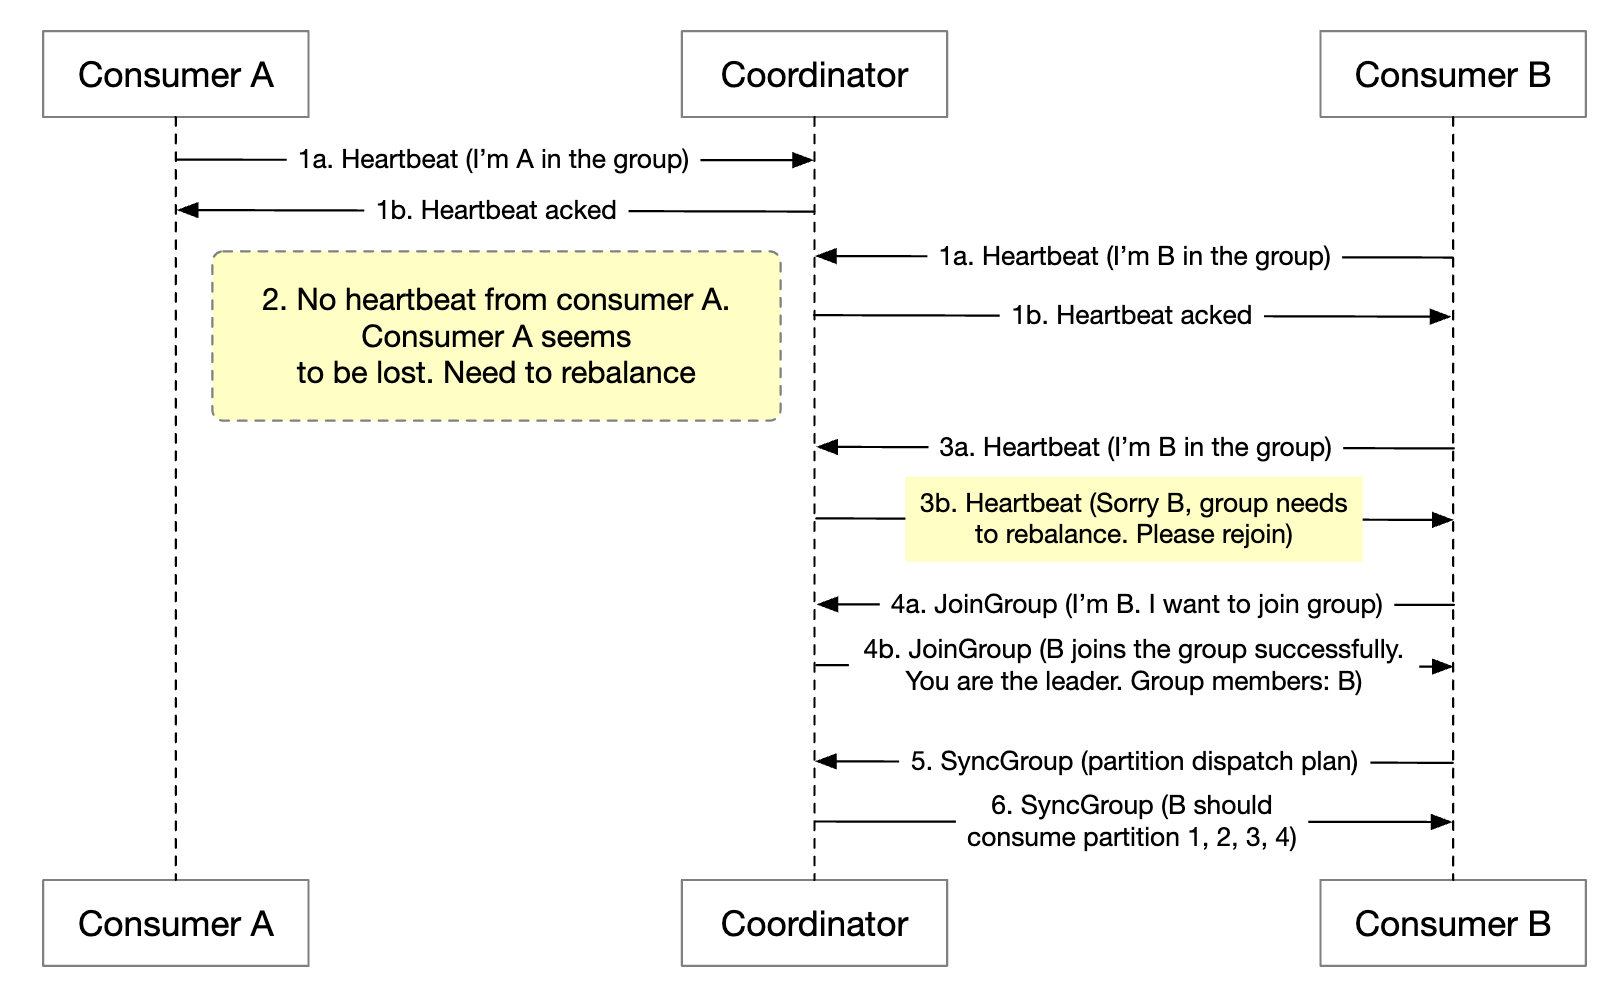
当消费者长时间没有发送心跳时,过程类似:
消费者失联的时序 协调者长时间收不到某消费者的心跳,就判定它已失联并触发重平衡,把它的分区交给组内其他消费者。处理流程与离开组一致。 消费者 A Coordinator 消费者 B 1a 心跳 1b 心跳确认 2a 心跳 2b 心跳确认 3b 请求重平衡 6 分发方案 A 长时间无心跳 → 判定失联,触发重平衡 按 diagram-design 重绘 查看原图 状态存储 状态存储存储分区与消费者之间的映射,以及分区的最后消费偏移量。
状态存储 状态存储保存分区与消费者的映射,以及每个分区最后消费到的 offset。示例中 group-1 停在 offset 6、group-2 停在 offset 13;消费者崩溃后,新消费者就从该位置继续,不会漏读也不会重读已提交的部分。 Topic-A Partition-1 offset 0–15 Group-1 offset = 6 Group-2 offset = 13 读到 6 读到 13 读写频繁但量小,一致性要求高 按 diagram-design 重绘 查看原图 组 1 的偏移量为 6,意味着之前的所有消息都已消费。如果消费者崩溃,新消费者将从该消息之后继续消费。
消费者状态的数据访问模式:
频繁的读写操作,但数据量小
数据频繁更新,但很少删除
随机读写
数据一致性很重要
鉴于这些要求,像 Zookeeper 这样的快速 KV 存储是理想的选择。
元数据存储 元数据存储存储配置和主题属性——分区数量、保留期限、副本分布。
元数据不经常变化且数据量小,但一致性要求高。
Zookeeper 是这种存储的不错选择。
ZooKeeper Zookeeper 对于构建分布式消息队列至关重要。
它是一种分层键值存储,通常用于分布式配置、同步服务和命名注册(即服务发现)。
ZooKeeper 统一承载元数据与状态 ZooKeeper 是分层键值存储,常被用作分布式配置、同步服务与命名注册(服务发现)。把元数据存储、状态存储与协调服务一并交给它之后,broker 只需维护消息数据本身,副本的 leader 选举也由 ZooKeeper 协助完成。 ZooKeeper 元数据存储 Metadata 状态存储 State 协调服务 Coordination Brokers 只存消息数据 生产者 消费者 偏移状态 选举 生产 消费 配置、状态、协调统一托管 按 diagram-design 重绘 查看原图 通过这一改变,代理只需要维护消息数据。元数据和状态存储都在 Zookeeper 中。
Zookeeper 还有助于代理副本的主副本选举。
复制 在分布式系统中,硬件问题是不可避免的。我们可以通过复制来实现高可用性。
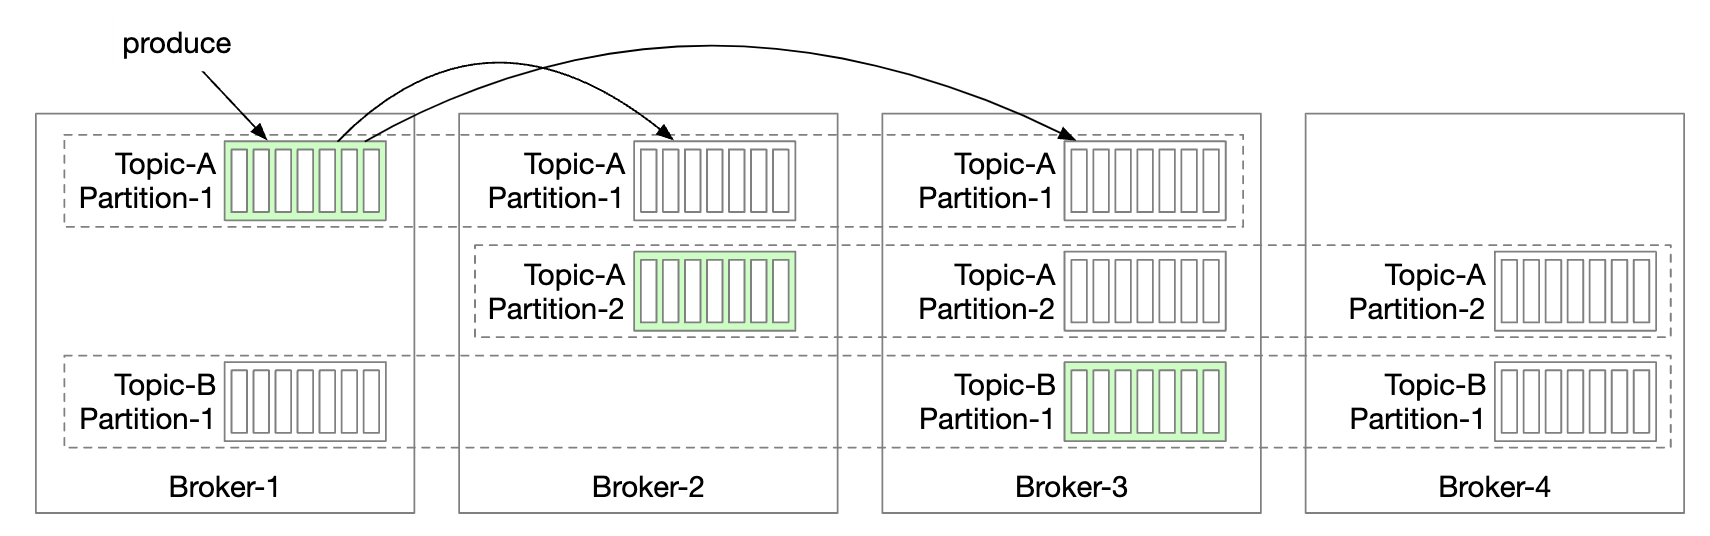
分区复制 每个分区被复制到多个 broker,但只有一个 leader 副本。生产者把消息发给 leader,副本向 leader 拉取;当足够多的副本同步完成后 leader 才向生产者返回确认。副本的分布方案称为副本分布计划,由 leader 生成并写入 ZooKeeper。 生产者 Broker-1 Topic-A P1 · leader Broker-2 副本 · follower Broker-3 副本 · follower 生产 复制 复制 每个分区只有一个 leader,其余为副本 按 diagram-design 重绘 查看原图
每个分区在多个代理之间进行复制,但只有一个主副本。
生产者将消息发送到主副本
从副本从主副本拉取复制消息
一旦足够多的副本同步,主副本就向生产者返回确认
每个分区的副本分布称为副本分布计划。
给定分区的主副本创建副本分布计划并将其保存到 Zookeeper。
同步副本 我们需要解决的一个问题是保持给定分区的主副本和从副本之间的消息同步。
同步副本(ISR)是分区中与主副本保持同步的副本。
replica.lag.max.messages 定义了副本可以落后主副本多少条消息才被视为同步。
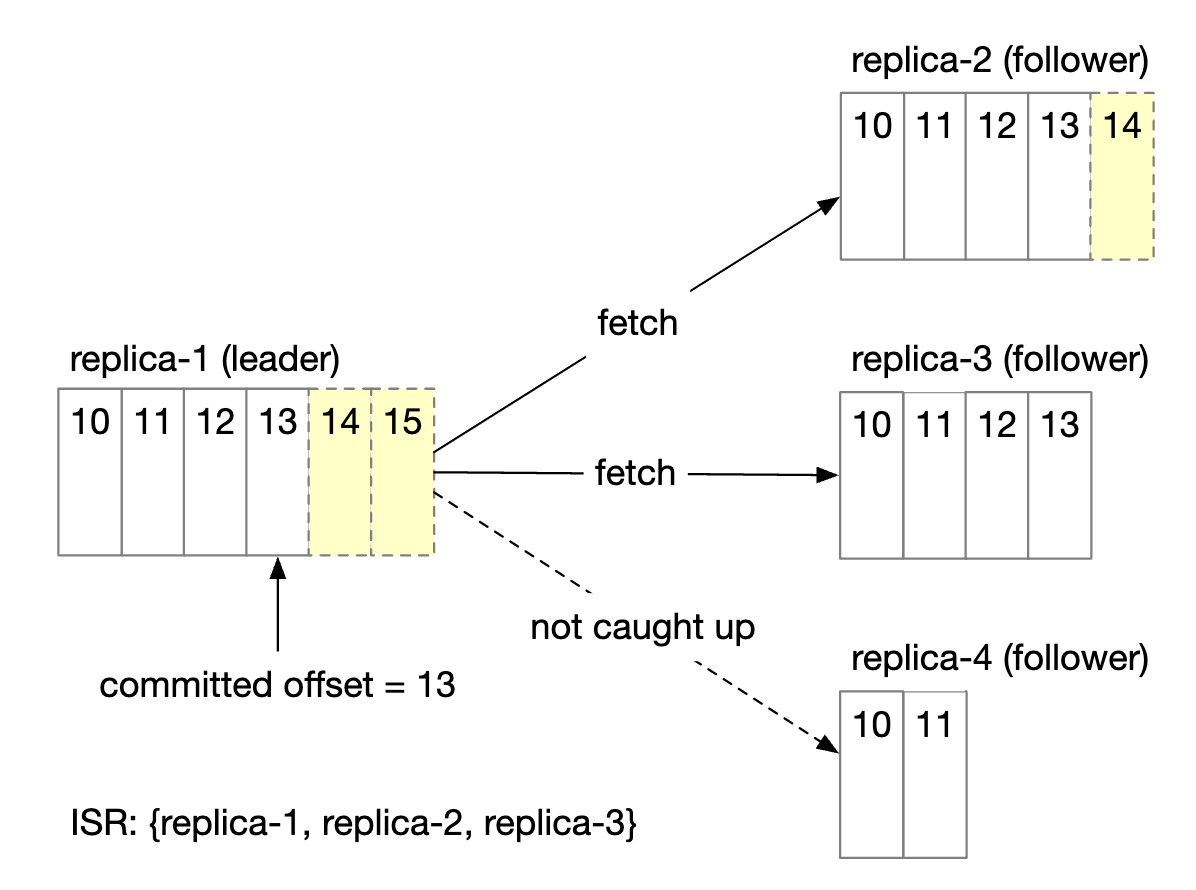
同步副本(ISR) 已提交 offset 为 13,leader 又写入两条尚未提交的消息。一条消息只有在 ISR 内所有副本都同步后才算提交;replica-2、replica-3 已完全追上 leader 属于 ISR,replica-4 落后太多暂时被移出 ISR。ISR 是性能与持久性之间的权衡。 replica-1 leader · 10–15 replica-2 follower · 10–14 replica-3 follower · 10–13 replica-4 follower · 10–11 落后 fetch fetch 未追上 committed offset = 13 ISR: {replica-1, replica-2, replica-3} 按 diagram-design 重绘 查看原图
已提交的偏移量为 13
两条新消息已写入主副本,但尚未提交。
一旦 ISR 中的所有副本都同步了某条消息,该消息就被提交
副本 2 和 3 已完全追上主副本,因此它们在 ISR 中
副本 4 落后了,因此暂时从 ISR 中移除
ISR 体现了性能和耐用性之间的权衡。
为了不让生产者丢失消息,所有副本应在发送确认之前同步
但缓慢的副本会导致整个分区不可用
确认处理是可配置的。
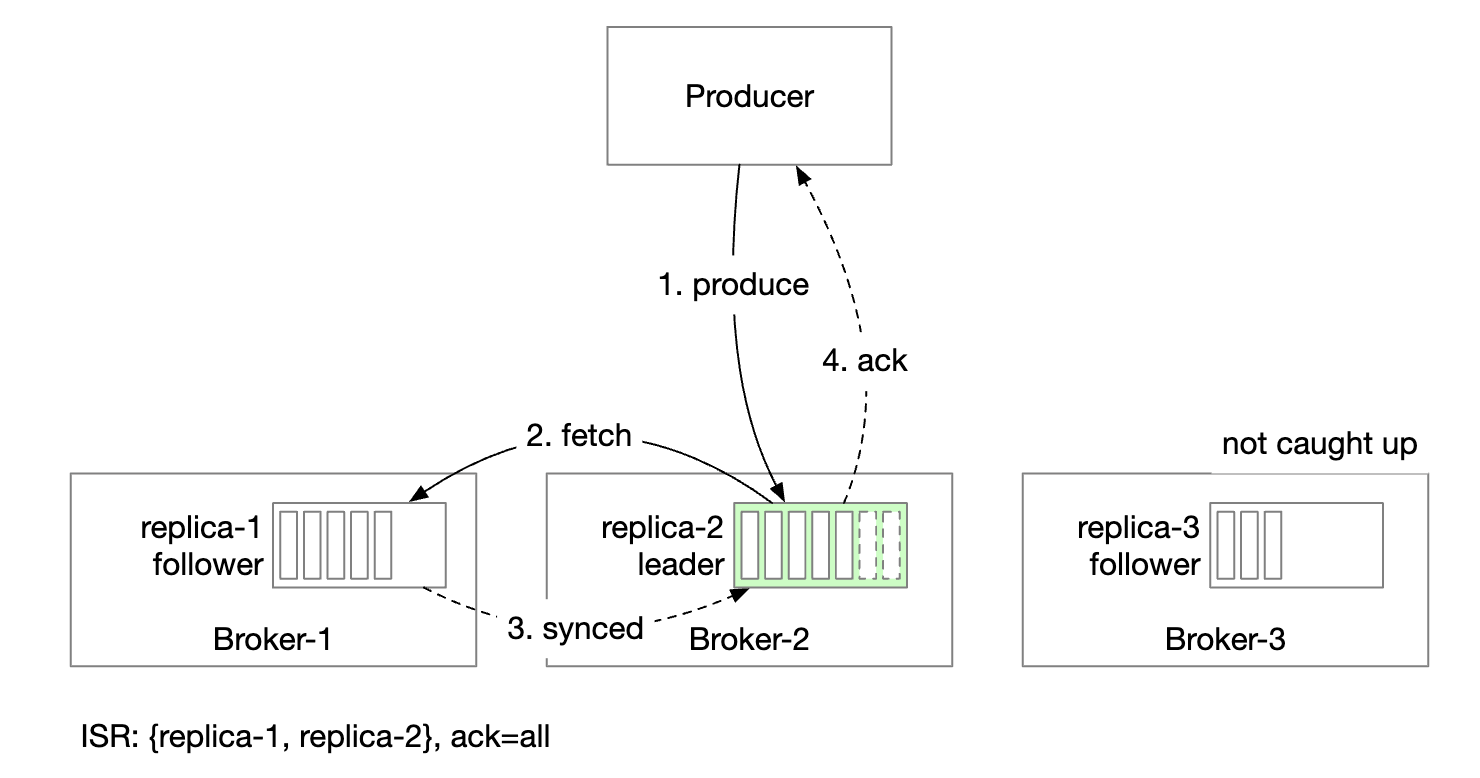
ACK=all 表示 ISR 中的所有副本都必须同步消息。消息发送较慢,但消息耐用性最高。
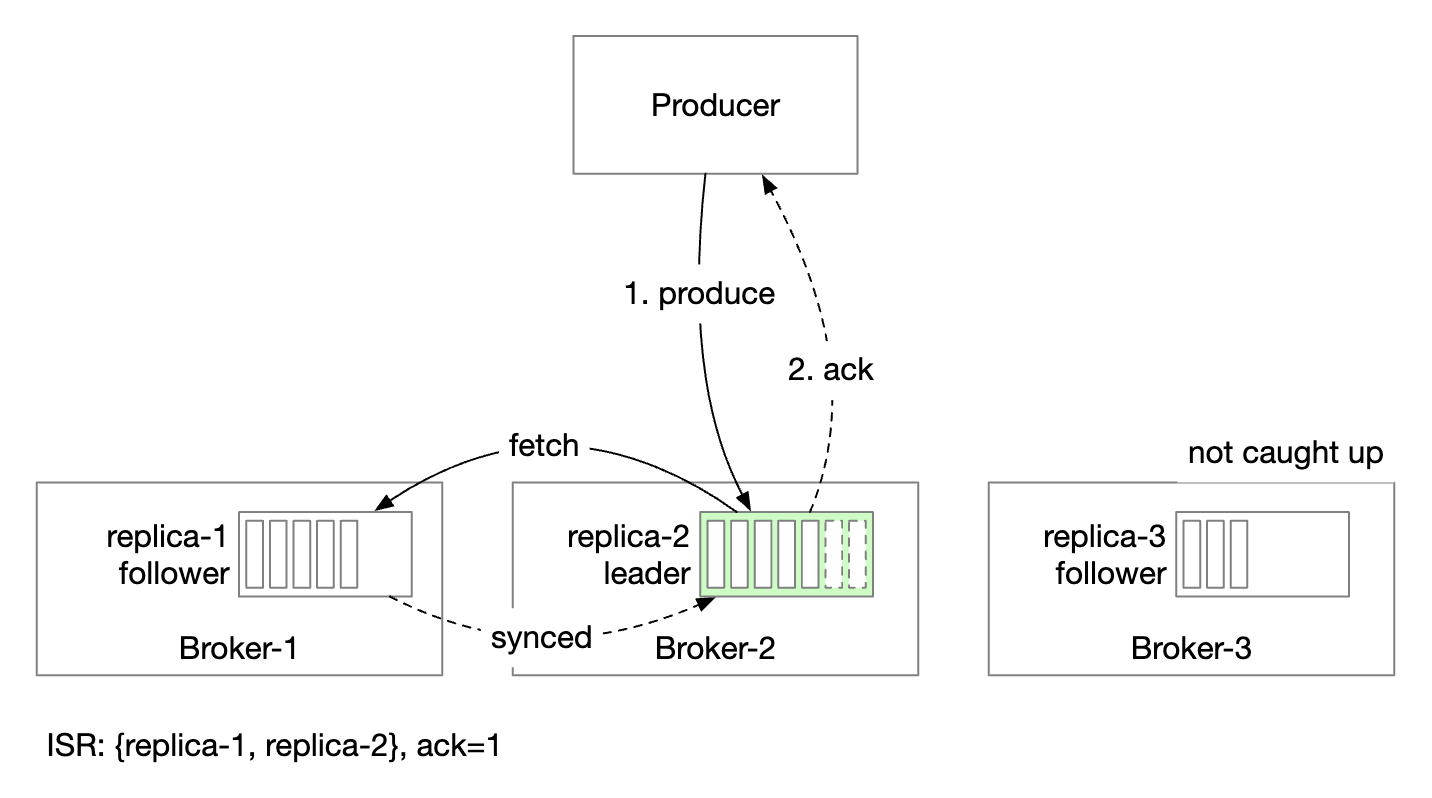
ACK=all ACK=all 要求 ISR 内所有副本都同步该消息后 leader 才回 ack:发送慢,但持久性最高。示例中 ISR 为 {replica-1, replica-2},replica-3 尚未追上。 生产者 Broker-1 replica-1 · follower Broker-2 replica-2 · leader Broker-3 replica-3 · 落后 1. 生产 2. fetch 4. ack 未追上 ISR: {replica-1, replica-2}, ack=all 按 diagram-design 重绘 查看原图 ACK=1 表示一旦主副本收到消息,生产者就会收到确认。消息发送快,但消息耐用性低。
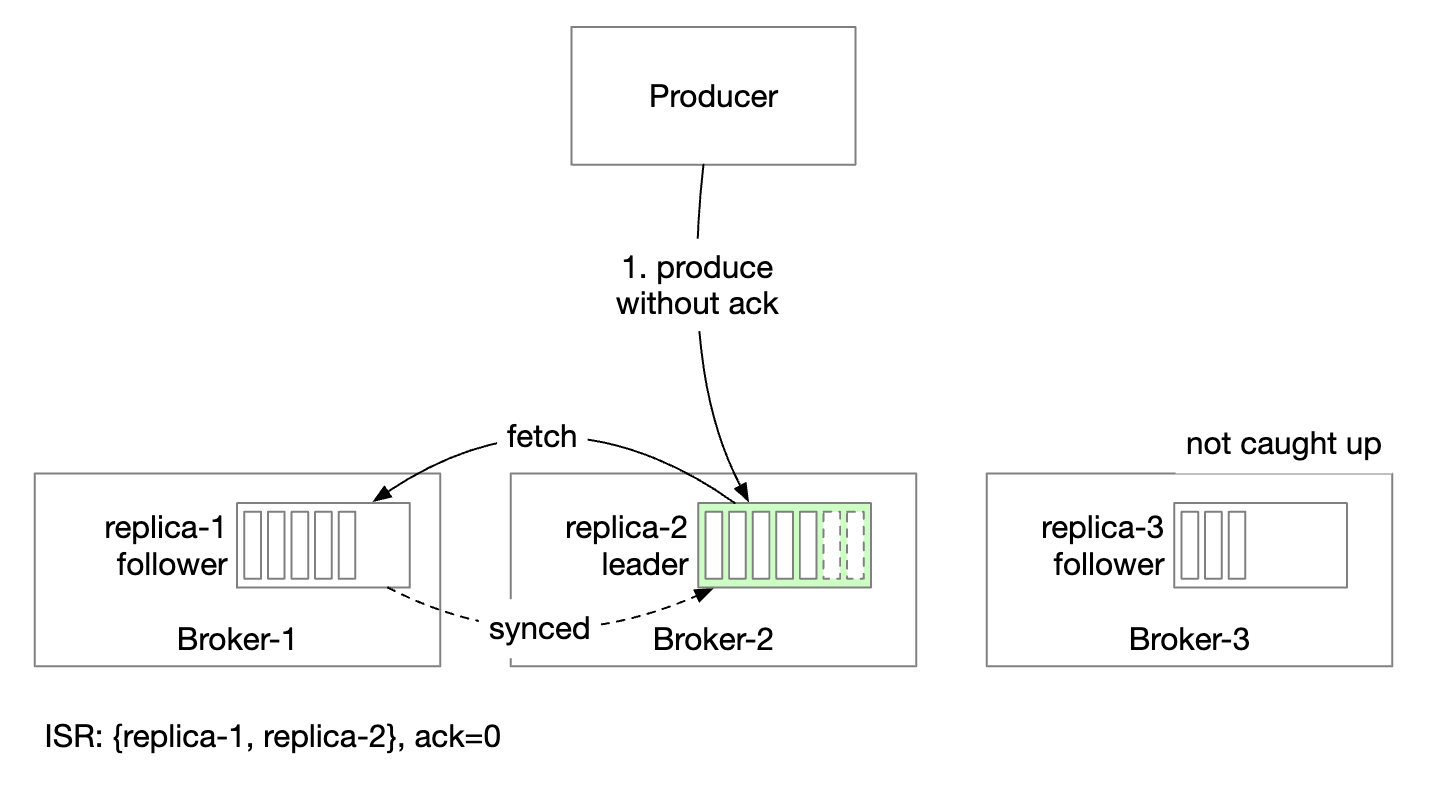
ACK=1 ACK=1 下 leader 一收到消息就回 ack:发送快,但持久性偏低——若 leader 在副本同步前宕机,消息可能丢失。示例 ISR 为 {replica-1, replica-2},replica-3 未追上。 生产者 Broker-1 replica-1 · follower Broker-2 replica-2 · leader Broker-3 replica-3 · 落后 1. 生产 fetch 2. ack 未追上 ISR: {replica-1, replica-2}, ack=1 按 diagram-design 重绘 查看原图 ACK=0 表示生产者发送消息而无需等待主副本的任何确认。消息发送最快,消息耐用性最低。
ACK=0 ACK=0 下生产者发出消息后完全不等待 leader 的确认:发送最快,持久性最低,消息可能在网络或 leader 侧丢失而生产者无感知。 生产者 Broker-1 replica-1 · follower Broker-2 replica-2 · leader Broker-3 replica-3 · 落后 生产(不等 ack) fetch 未追上 ISR: {replica-1, replica-2}, ack=0 按 diagram-design 重绘 查看原图 在消费者端,我们可以将所有消费者连接到某个分区的主副本,并让它们从主副本读取消息:
这是最简单的设计和操作方式
分区中的消息仅发送给组中的一个消费者,这限制了对主副本的连接
只要主题不是超级热门,到主副本的连接数通常不会很高
我们可以通过增加分区和消费者的数量来扩展热门主题
在某些场景下,让消费者从 ISR 读取可能是合理的,例如它们位于不同的数据中心
ISR 列表由主副本维护,它跟踪自身与每个副本之间的落后情况。
可扩展性 让我们评估如何扩展系统的不同部分。
生产者
生产者比消费者简单得多。通过添加/移除新的生产者实例可以轻松实现其可扩展性。
消费者
消费者组彼此隔离。可以随意添加/移除消费者组。
再平衡有助于优雅地处理消费者从组中添加/移除的情况。
消费者组和再平衡帮助我们实现可扩展性和容错。
代理
代理如何处理故障?
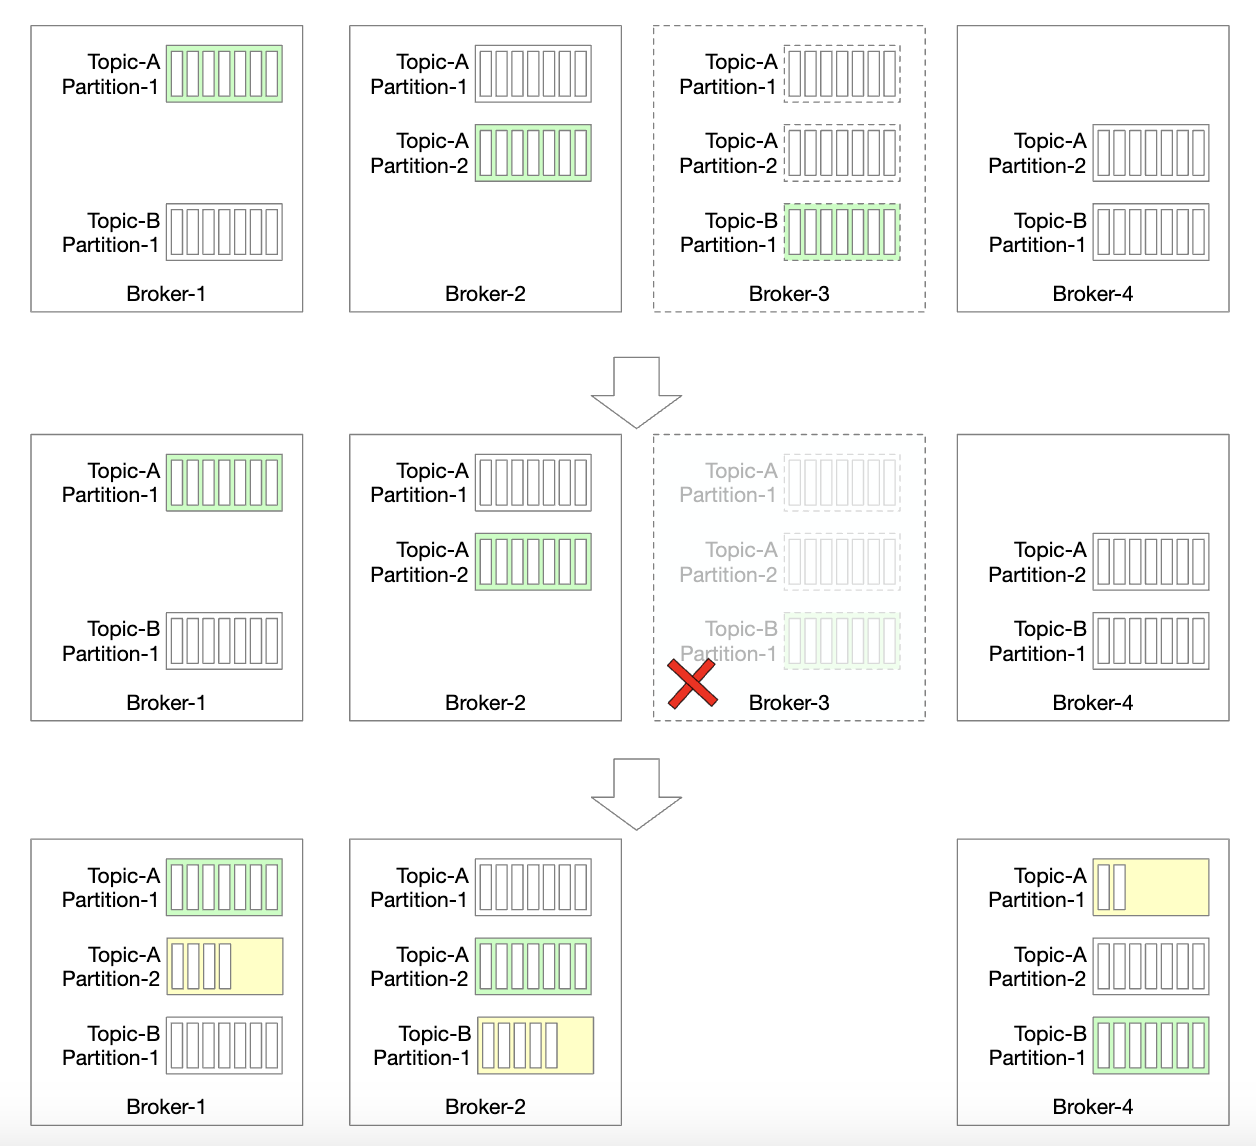
Broker 故障恢复 某个 broker 故障后,只要还有足够副本就不会丢分区数据:协调者选出新的 leader,并把故障 broker 上的分区重分配给其余副本;这些副本先以 follower 身份追赶,追上后再进入 ISR。 Broker-1 接管 P2 Broker-2 接管 P1 Broker-3 故障下线 Broker-4 接管 P3 迁移 迁移 故障 broker 的分区重分配到其余副本 新 leader 由协调者选举产生 按 diagram-design 重绘 查看原图
一旦代理发生故障,仍会有足够的副本以避免分区数据丢失
选举新的主副本,代理协调器将故障代理上的分区重新分配给现有副本
现有副本接管新分区,并作为从副本运行,直到它们追上主副本并成为 ISR
使代理容错的其他考虑因素:
ISR 的最小数量在延迟和安全性之间取得平衡。可以对其进行微调以满足需求。
如果某个分区的所有副本都在同一节点上,那就是资源浪费。副本应分布在不同的代理上。
如果某个分区的所有副本都崩溃,那么数据将永久丢失。将副本分布在不同数据中心会有所帮助,但会增加大量延迟。一种选择是使用数据镜像 作为变通方案。
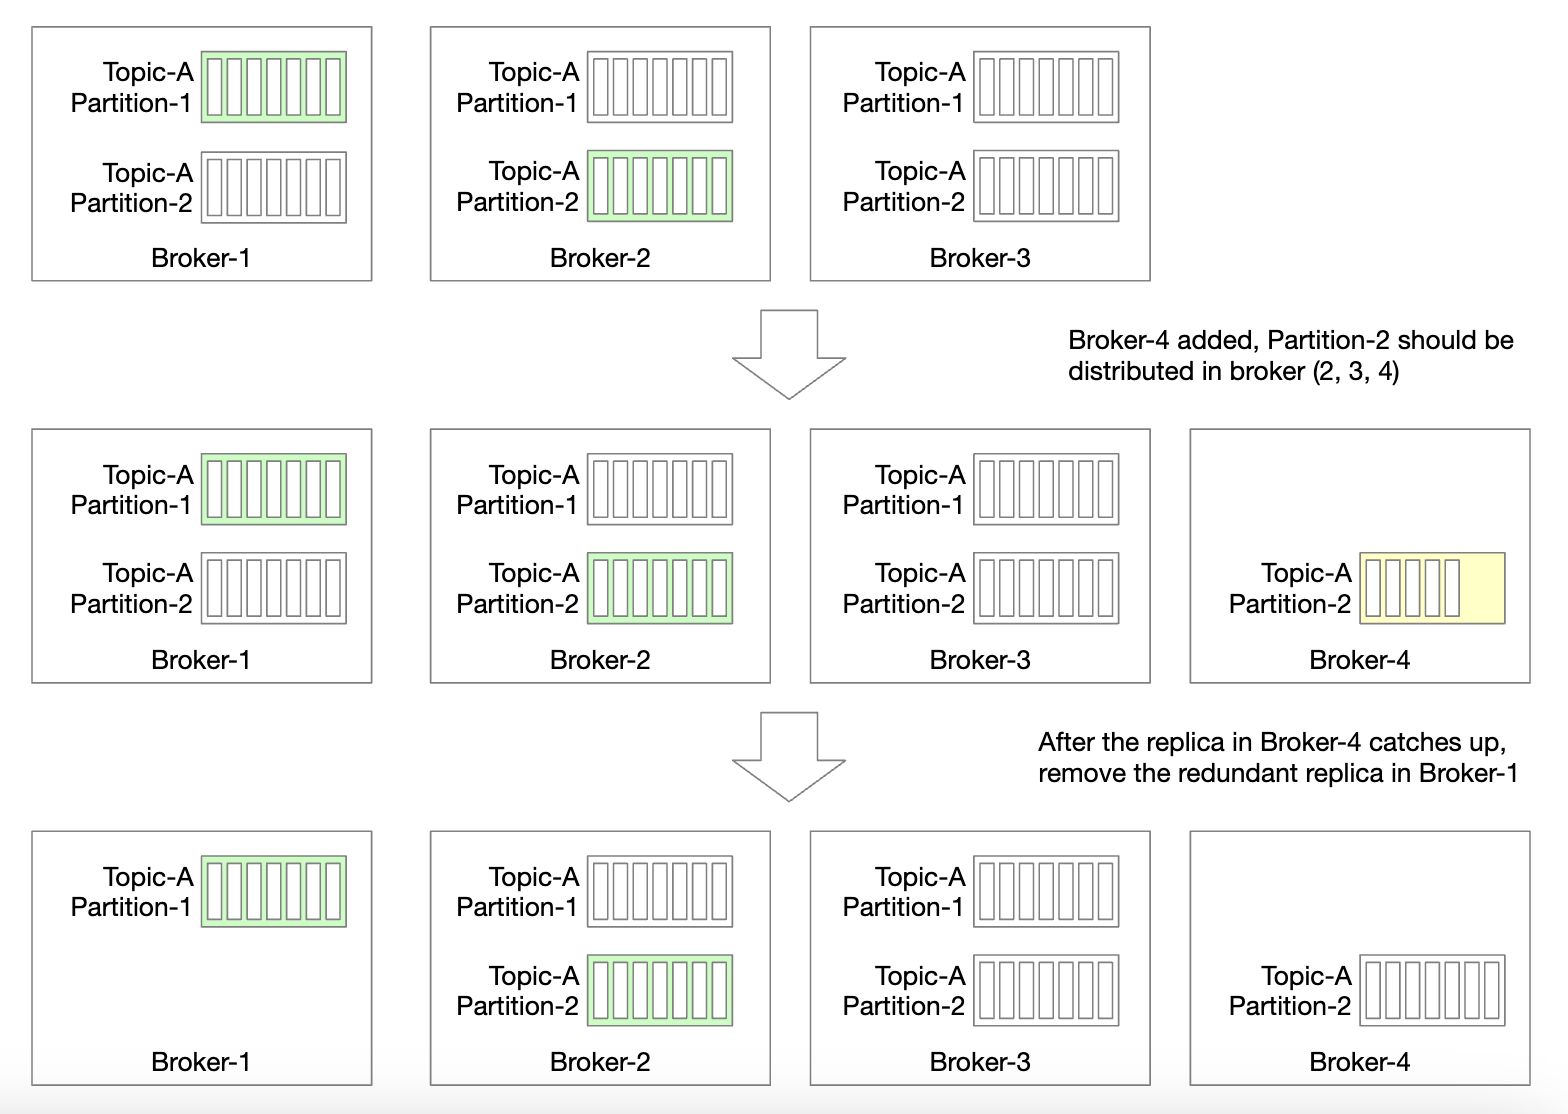
当添加新代理时,我们如何处理副本的重新分配?
新增 Broker 后的副本重分配 加入新 broker 时可以临时容忍副本数超过配置,等新 broker 追上后再删掉多余的副本。示例中 Topic-A Partition-2 从 Broker-1 复制到新增的 Broker-4,追平后移除 Broker-1 上的冗余副本。 Broker-1 P1, P2 Broker-2 P1, P2 Broker-3 P1, P2 Broker-4 新增 · 追平中 副本迁移 追平后移除不再需要的冗余副本 临时允许副本数超过配置 按 diagram-design 重绘 查看原图
我们可以暂时允许比配置更多的副本,直到新代理赶上进度
一旦赶上,我们就可以移除不再需要的分区副本
分区
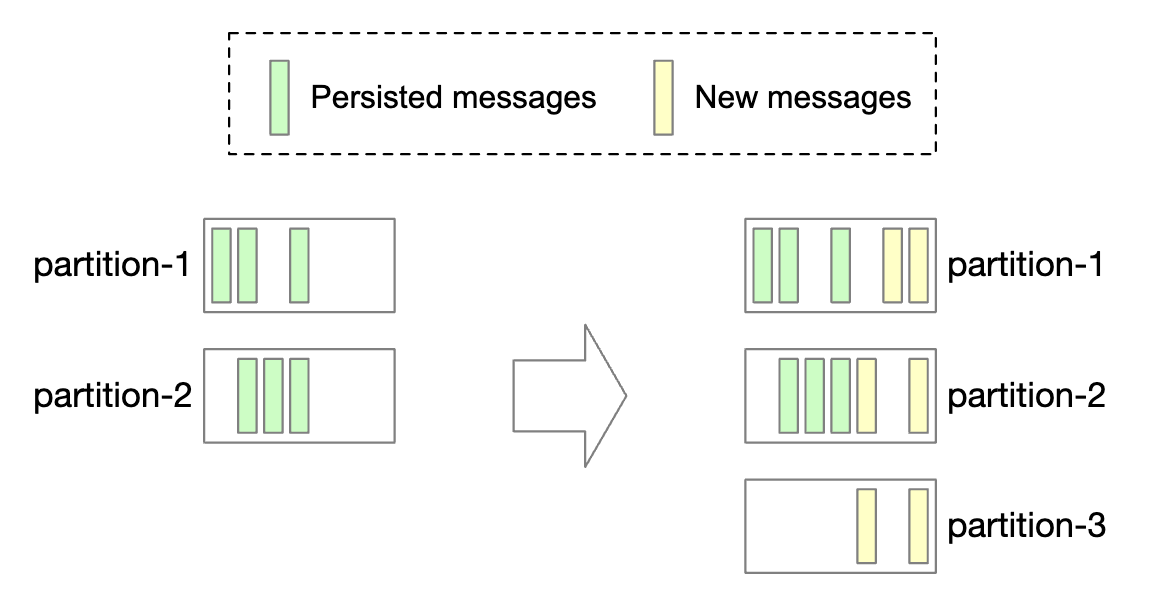
每当添加新分区时,生产者会收到通知,并触发消费者再平衡。
在数据存储方面,我们可以只将新消息存储到新分区,而不是尝试复制所有旧消息:
新增分区 新增分区时,旧分区的历史消息不迁移,只有新消息会写入新分区:生产者收到通知、消费者触发重平衡后即可感知新分区。这样避免了拷贝全量历史数据的高昂代价。 partition-1 持久消息 partition-2 持久消息 partition-1 旧 + 新消息 partition-2 旧 + 新消息 partition-3 仅新消息 原样保留 原样保留 历史数据不迁移,只写入新分区 生产者收到通知,消费者触发重平衡 按 diagram-design 重绘 查看原图 减少分区数量更复杂:
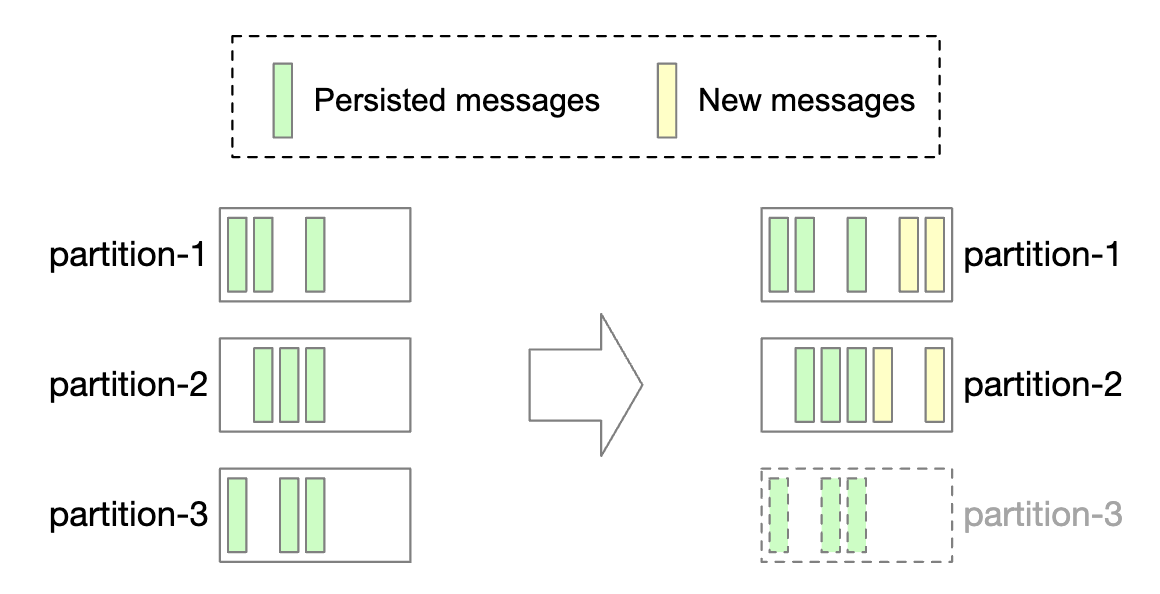
减少分区 分区退役后,新消息只发往剩余分区,但退役分区不会立刻删除,消费者仍可继续读;等预配置的保留期过去再截断数据、释放存储。过渡期内生产者只写活跃分区,消费者则从全部分区读取。 partition-1 保留 partition-2 保留 partition-3 退役 partition-1 旧 + 新 partition-2 旧 + 新 partition-3 只读 · 待截断 停止写入 保留期到期后截断并释放存储 按 diagram-design 重绘 查看原图
一旦分区被停用,新消息只会由剩余分区接收
停用的分区不会立即删除,因为仍然可以从中消费消息
一旦预配置的保留期过后,我们就截断数据并释放存储空间
在过渡期间,生产者只向活跃分区发送消息,但消费者从所有分区读取
一旦保留期结束,消费者就会再平衡
数据传递语义 让我们讨论不同的传递语义。
至多一次
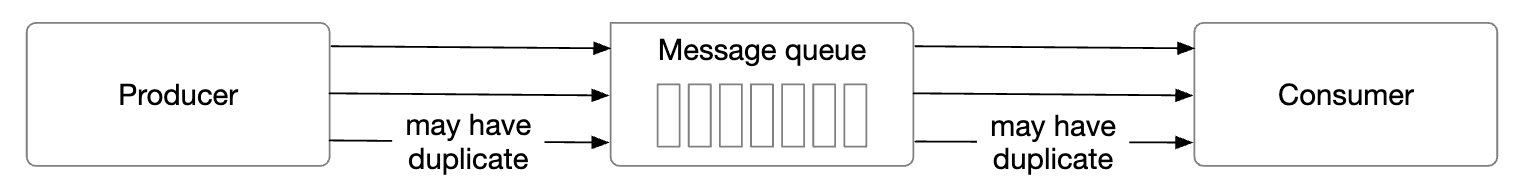
在这种保证下,消息最多传递一次,也可能根本不传递。
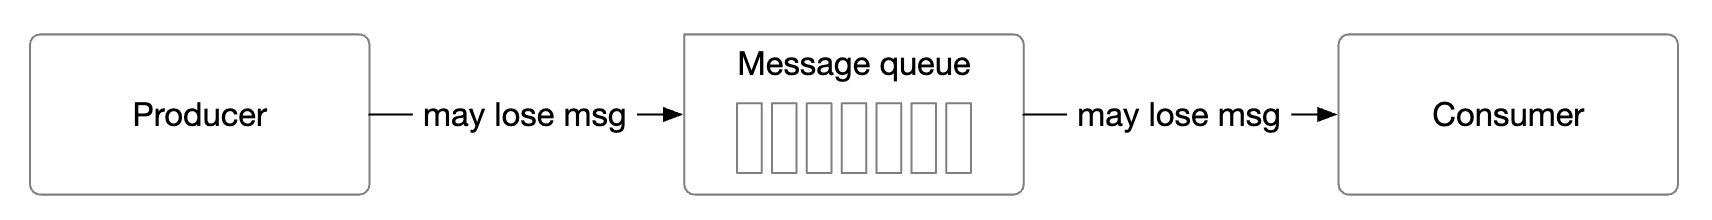
至多一次(at-most-once) 消息至多被投递一次,也可能完全丢失。生产者异步发送、失败不重试;消费者取到消息后立即提交 offset,若在真正处理前崩溃,这条消息就再也不会被处理。 生产者 消息队列 消费者 可能丢消息 可能丢消息 不重试;消费后立即提交 offset 按 diagram-design 重绘 查看原图
生产者异步将消息发送到主题。如果消息传递失败,不会重试。
消费者拉取消息并立即提交偏移量。如果消费者在处理消息之前崩溃,该消息将不会被处理。
至少一次
消息可能被发送多次,任何消息都不应未被处理。
至少一次(at-least-once) 消息不会漏处理,但可能重复投递。生产者用 ack=1 或 ack=all 发送、出错就重试;消费者处理完才提交 offset,因此若在处理后、提交前崩溃,这条消息会被再次投递——适合可去重或允许重复的场景。 生产者 消息队列 消费者 可能重复 可能重复 失败重试;处理完才提交 offset 按 diagram-design 重绘 查看原图
生产者使用 ack=1 或 ack=all 发送消息。如果有任何问题,它会一直重试。
消费者拉取消息,并且只有在处理完成后才提交偏移量。
如果消费者在处理后提交偏移量之前崩溃,消息可能会被传递多次。
这就是为什么它适用于可接受数据重复或可以进行去重的用例。
精确一次
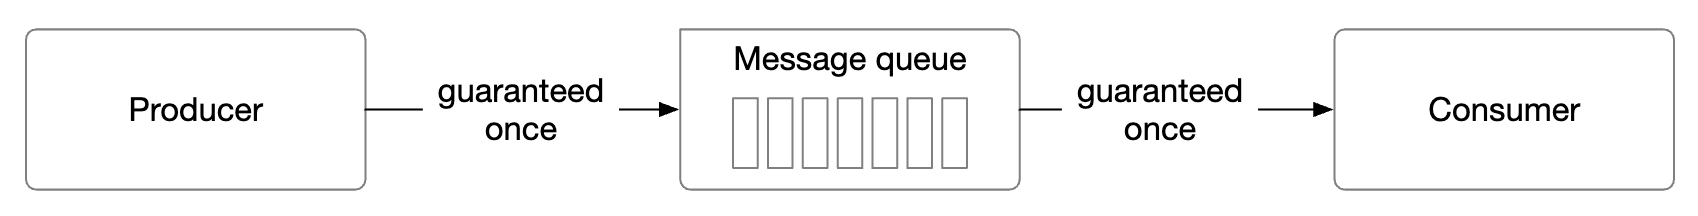
尽管对用户而言这是最友好的保证,但在系统中实现成本极高:
恰好一次(exactly-once) 消息有且仅有一次,对使用者最友好,但实现代价极高:需要生产者幂等、事务提交与消费者侧的精确一次语义配合,通常只在关键链路才开启。 生产者 消息队列 消费者 恰好一次 恰好一次 实现代价高,通常按需开启 按 diagram-design 重绘 查看原图 高级特性 让我们讨论一些高级特性,这些在面试中可能会讨论到。
消息过滤
一些消费者可能只想消费分区内特定类型的消息。
可以通过为每个消息子集构建单独的主题来实现,但如果系统有太多不同的用例,这可能会很昂贵。
在不同主题上存储相同的消息是资源浪费
生产者现在与消费者紧密耦合,因为它会随着每个新的消费者需求而变化
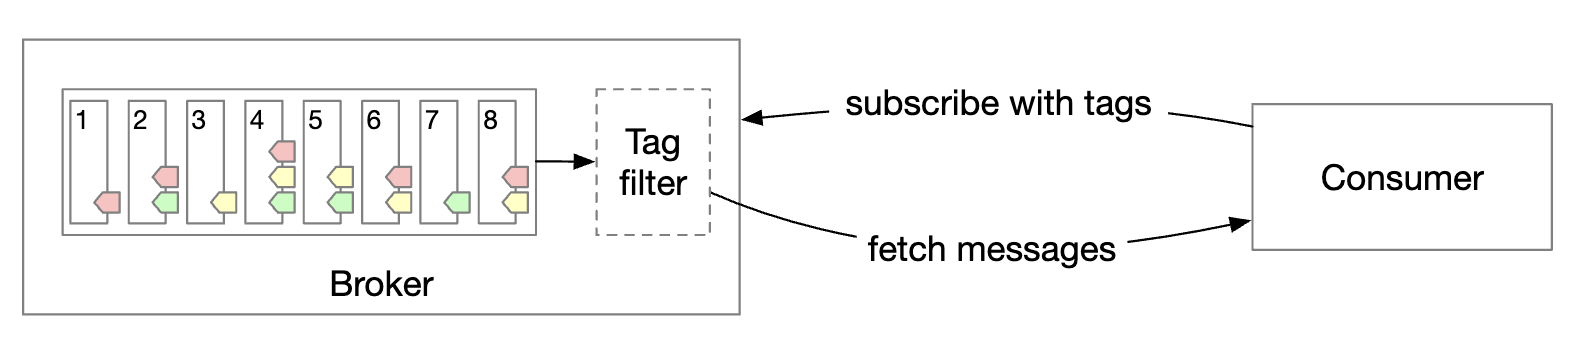
我们可以使用消息过滤来解决这个问题。
一种天真的方法是在消费者端进行过滤,但这会引入不必要的消费者流量
或者,可以为消息附加标签,消费者可以指定它们订阅了哪些标签
过滤也可以通过消息有效载荷来完成,但对于加密/序列化消息来说,这可能具有挑战性且不安全
对于更复杂的数学公式,代理可以实现语法解析器或脚本执行器,但这对于消息队列来说可能过于重量级
消息过滤 同一个分区里的消息可能只有一部分是某消费者关心的。与其为每种需求单独建 topic(浪费存储、还让生产者与消费者耦合),不如给消息打 tag,消费者只订阅自己关心的 tag,由 broker 侧过滤,避免把无关消息推给消费者。 Broker M1 tag:A M2 tag:B M3 tag:A M4 tag:B 标签过滤 Tag filter 消费者 拉取 订阅 tag:A 按 tag 过滤,减少消费者无效流量 按 diagram-design 重绘 查看原图 延迟消息和定时消息
对于某些用例,我们可能希望延迟或定时传递消息。
例如,我们可以提交一个 30 分钟后的付款验证检查,触发消费者查看付款是否成功。
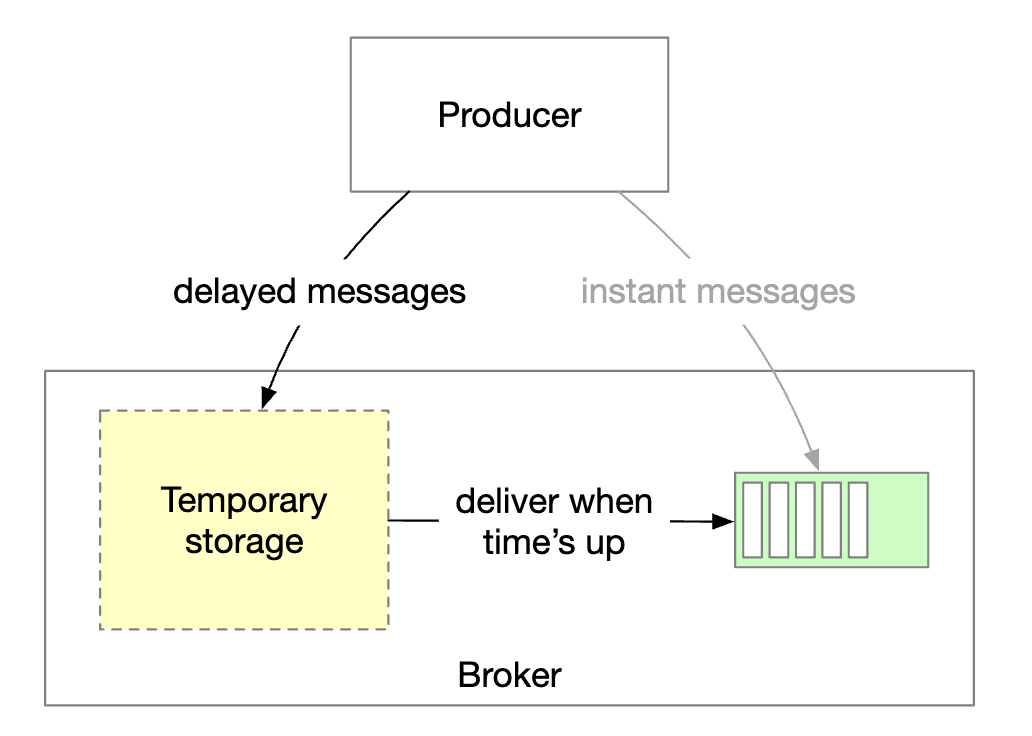
这可以通过将消息发送到代理中的临时存储,并在适当的时间将消息移动到分区来实现:
延迟消息实现 延迟或定时消息先写进 broker 内的临时存储,到点再搬进目标分区供消费者读取。临时存储可以是一个或多个特殊 topic,计时则由专用延迟队列或分层时间轮实现。 Broker 生产者 临时存储 延迟消息 Topic-A Partition-1 即时消息 延迟消息 即时消息 到时投递 临时存储可为特殊 topic;计时用时间轮 按 diagram-design 重绘 查看原图
临时存储可以是一个或多个特殊消息主题
定时功能可以使用专用延迟队列或分层时间轮 来实现
第 4 步:总结
额外的讨论要点:
通信协议 :重要考虑因素——支持所有用例和高数据量,以及验证消息完整性。流行的协议——AMQP 和 Kafka 协议。重试消费 :如果我们无法立即处理消息,可以将其发送到专用的重试主题,稍后再尝试。历史数据归档 :旧消息可以备份到高容量存储中,例如 HDFS 或对象存储(如 S3)。
第 20 章:指标监控与告警系统
引言
本章重点设计一个高度可扩展的指标监控与告警系统 ,这对于确保高可用性和可靠性至关重要。
第 1 步:理解问题并确定设计范围
指标监控系统的含义可能非常宽泛——例如,当面试官只对基础设施指标感兴趣时,你不想设计一个日志聚合系统。
我们先来理解问题:
面试者:我们为谁构建这个系统?是为大型科技公司构建内部监控系统,还是像 DataDog 这样的 SaaS?
面试官:我们仅供内部使用。
面试者:我们想收集哪些指标?
面试官:操作系统指标——CPU 负载、内存、数据磁盘空间。也包括每秒请求数等高层指标。业务指标不在范围内。
面试者:我们要监控的基础设施规模有多大?
面试官:100mil 日活跃用户,1000 个服务器池,每个池 100 台机器
面试者:数据应保留多久?
面试官:假设保留 1y。
面试者:长期存储时能否降低指标数据分辨率?
面试官:新收到的指标保留 7 天。之后 30 天汇总到 1m 分辨率。30 天后再汇总到 1h 分辨率。
面试者:支持哪些告警渠道?
面试官:邮件、电话、PagerDuty 或 webhooks。
面试者:需要收集错误或访问日志吗?
面试官:不需要
面试者:需要支持分布式系统追踪吗?
面试官:不需要
高层需求与假设 被监控的基础设施规模很大:
100mil DAU
1000 个服务器池 * 100 台机器 * 每台约 100 个指标 -> ~10mil 指标
1-year 数据保留
数据保留策略——原始数据保留 7d,1-minute 分辨率保留 30d,1h 分辨率保留 1y
可监控的指标类型多样:
CPU 负载
请求数
内存使用量
消息队列中的消息数
非功能需求
可扩展性 :系统应可扩展以容纳更多指标和告警低延迟 :系统对仪表盘和告警的查询延迟要低可靠性 :系统应高度可靠,避免漏掉关键告警灵活性 :系统未来应能轻松集成新技术
哪些需求不在范围内?
日志监控 :ELK 技术栈在此场景非常流行分布式系统追踪 :指收集请求在系统内流经多个服务时的生命周期数据
第 2 步:提出高层设计并获得认可
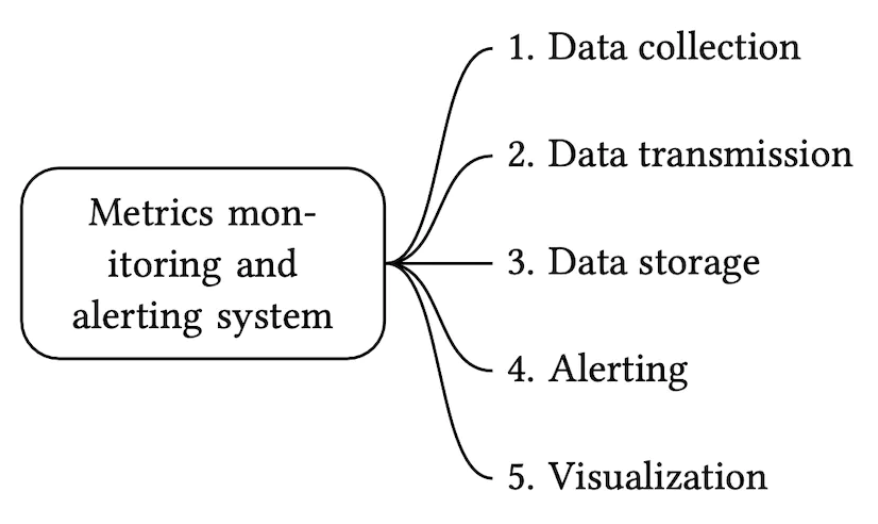
基础 指标监控与告警系统涉及五个核心组件:
五大核心组件 指标监控与告警系统由五个核心部分组成:数据采集、数据传输、数据存储、告警、可视化。前两者负责把指标从各处汇集进来,数据存储按时间序列组织落盘,告警分析数据并触发通知,可视化把结果画成图表。 指标监控与告警系统 五大核心组件 ① 数据采集 ② 数据传输 ③ 数据存储 ④ 告警 ⑤ 可视化 五个环节串成一条链路:采集 → 传输 → 存储 → 告警 / 可视化 按 diagram-design 重绘 查看原图
数据收集 :从不同来源收集指标数据数据传输 :将数据从来源传输到指标监控系统数据存储 :组织并存储传入数据告警 :分析传入数据、检测异常并生成告警可视化 :以图形、图表等形式呈现数据
数据模型 指标数据通常记录为时间序列,其中包含一组带时间戳的值。
序列可由名称和一组可选标签标识。
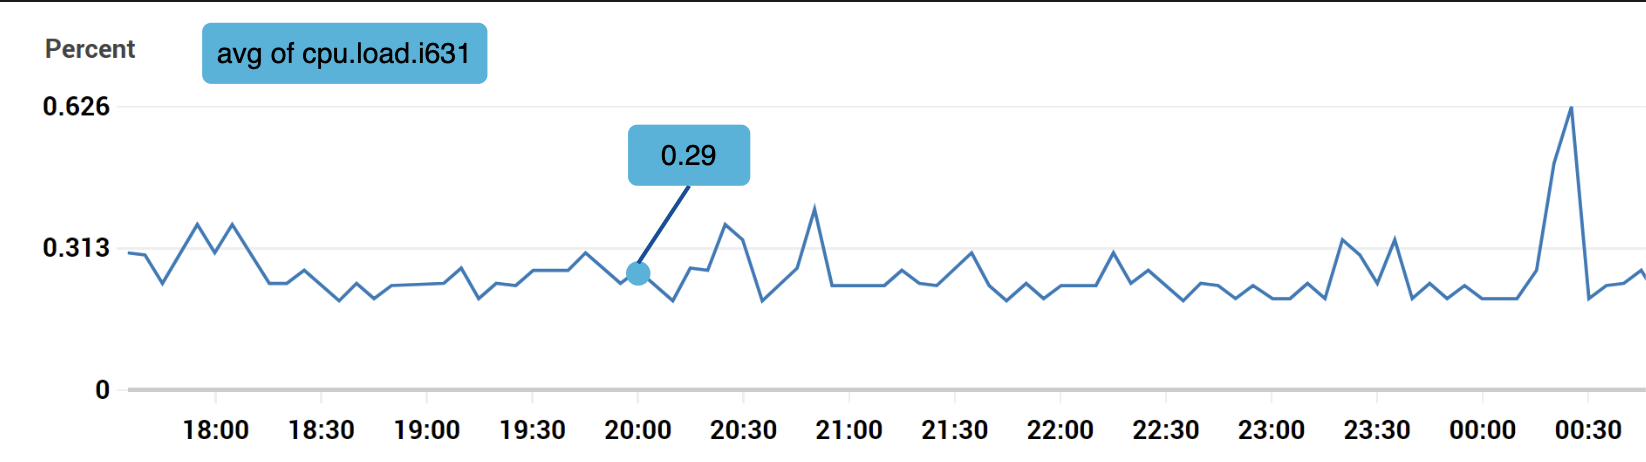
示例 1——生产服务器实例 i631 在 20:00 的 CPU 负载是多少?
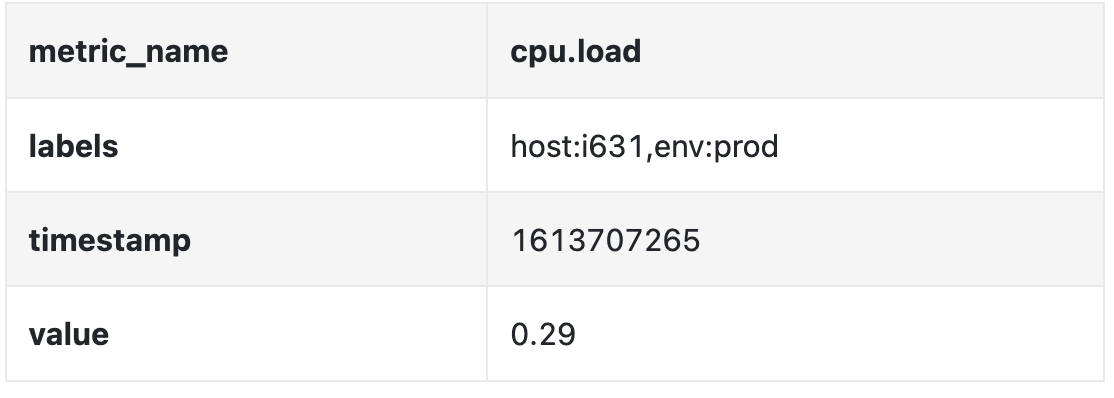
指标查询示例:单点取值 查询「生产机 i631 在 20:00 的 CPU 负载」会返回一条时间序列。曲线在 0.313 附近波动,其中 20:00 这个采样点的值是 0.29,图中用气泡标注出来。 avg of cpu.load.i631 折线图 18:00 ≈0.31 19:00 ≈0.31 20:00 0.29 21:00 ≈0.31 00:30 ≈0.63 该点 0.29 曲线示意:数值在 0.313 附近波动 y 轴 Percent:0 → 0.626 x 轴:时间 18:00 → 次日 00:30 按 diagram-design 重绘 查看原图 数据可用下表标识:
一个数据点的四个字段 上例取到的那个点可以拆成四个字段:指标名 cpu.load、标签 host:i631 与 env:prod、Unix 时间戳 1613707265、以及该时刻的值 0.29。指标名 + 标签确定是哪条时序,时间戳 + 值确定是哪个采样点。 指标名 cpu.load 标签 host:i631, env:prod 时间戳 1613707265 值 0.29 指标名 + 标签 → 定位一条时序 标签用于切分与聚合 Unix 时间戳(秒) 该时刻的采样值 按 diagram-design 重绘 查看原图 时间序列由指标名称、标签以及特定时刻的数据点标识。
示例 2——过去 10min 内 us-west 区域所有 Web 服务器的平均 CPU 负载是多少?
CPU.load host=webserver01,region=us-west 1613707265 50

CPU.load host=webserver01,region=us-west 1613707265 62

CPU.load host=webserver02,region=us-west 1613707265 43

CPU.load host=webserver02,region=us-west 1613707265 53

...

CPU.load host=webserver01,region=us-west 1613707265 76

CPU.load host=webserver01,region=us-west 1613707265 83
这是我们从存储中拉取用来回答该问题的示例数据。
平均 CPU 负载可以通过对各行最后一列的值求平均来计算。
上面展示的格式称为 line protocol,被市场上许多流行监控软件使用——例如 Prometheus、OpenTSDB。
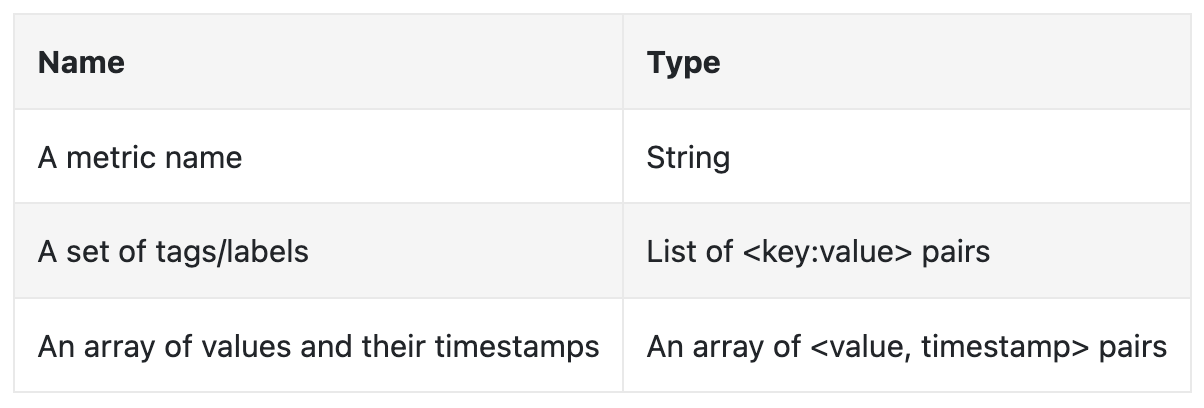
每个时间序列包含什么:
一条时序由什么组成 每条时间序列包含三部分:一个指标名(字符串);一组标签(key:value 列表);以及一串值与时间戳(value, timestamp 对)。这三者共同定义了一条时序及其历史数据。 指标名 String 标签集合 List of <key:value> 值与时间戳数组 Array of <value, timestamp> 一条时序 = 指标名 + 标签 + 值序列 唯一标识一条时序 决定查询与聚合的维度 按时间排列的历史采样 按 diagram-design 重绘 查看原图 一个直观展示数据形态的好方法:
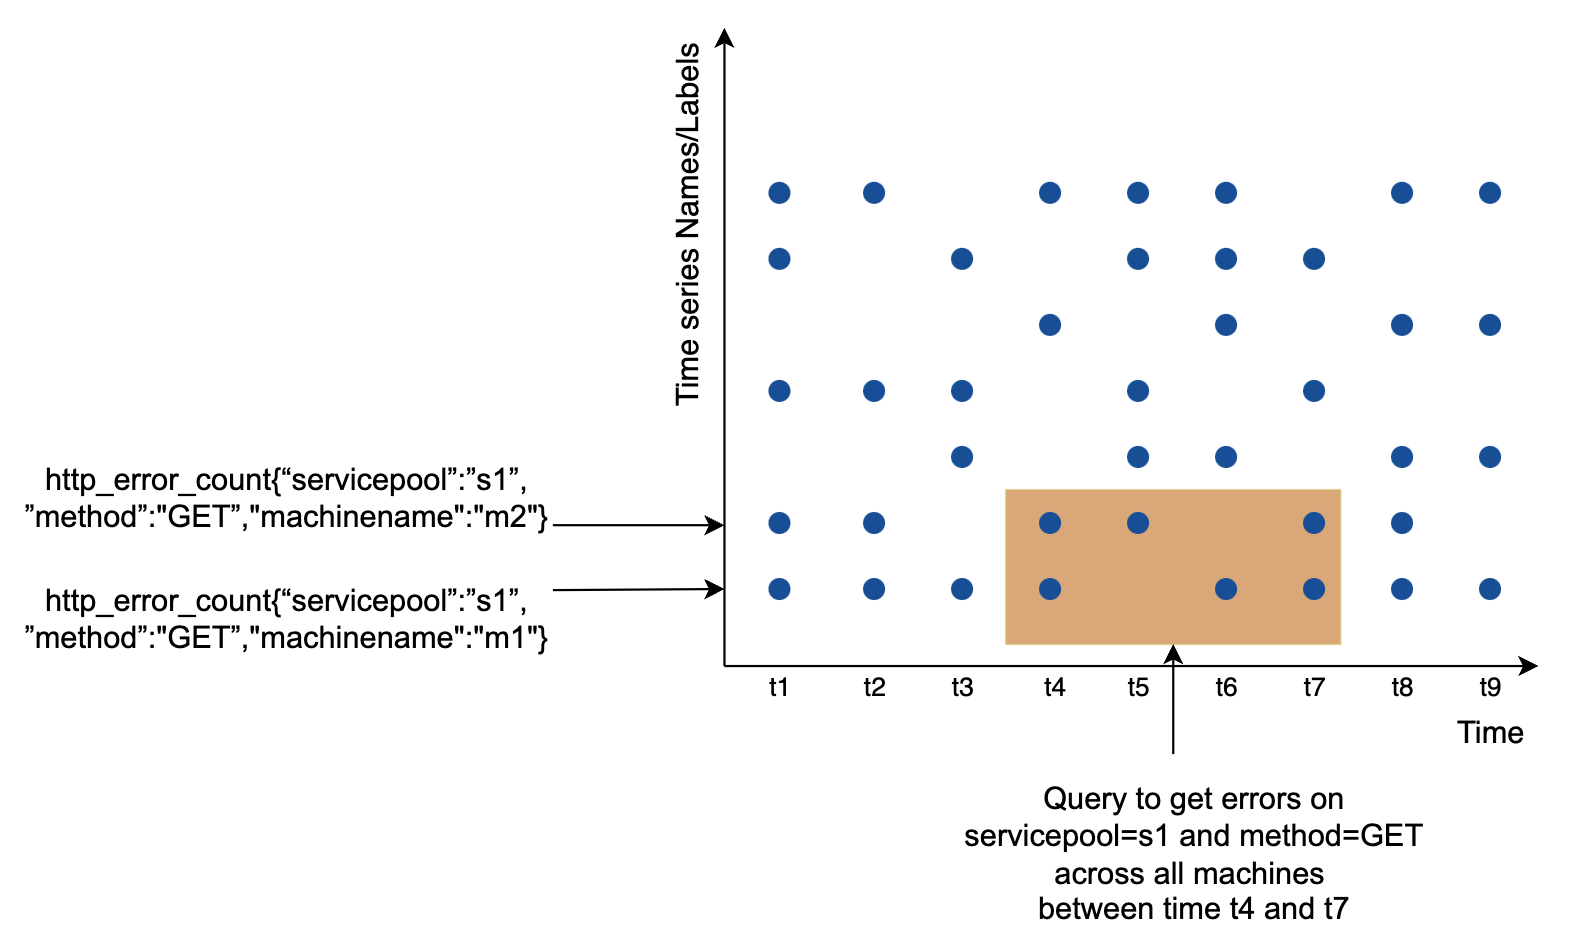
时序数据的可视化方式 把时序数据画成散点:x 轴是时间,y 轴是要查询的维度(指标名、标签等)。每个点是一次采样;高亮区域是查询「servicepool=s1 且 method=GET、跨所有机器、时间 t4 到 t7」命中的点集。 散点示意:x 轴时间 t1…t9,y 轴时序名 / 标签 时序 m2 machinename:m2 时序 m1 machinename:m1 查询结果 t4 – t7 每条时序 = 一组标签的唯一组合 查询:servicepool=s1 且 method=GET,跨所有机器,时间 t4–t7 按 diagram-design 重绘 查看原图
x 轴是时间
y 轴是你要查询的维度——例如指标名称、标签等
数据访问模式是写入密集且读取呈尖峰状,因为我们收集大量指标,但它们很少被访问,不过在有事故发生时会突发访问。
数据存储系统是本次设计的核心。
不建议对此问题使用通用数据库,尽管通过专家级调优可能达到不错的规模。
理论上使用 NoSQL 数据库可行,但很难设计出可扩展的模式来高效存储和查询时间序列数据。
有许多专门为存储时间序列数据而设计的数据库。其中许多支持自定义查询接口,可高效查询时间序列数据。
OpenTSDB 是一个分布式时间序列数据库,但它基于 Hadoop 和 HBase。如果你没有预置这些基础设施,使用该技术会很困难。
Twitter 使用 MetricsDB,Amazon 提供 Timestream。
最流行的两个时间序列数据库是 InfluxDB 和 Prometheus。
它们专为存储大量时间序列数据而设计,都基于内存缓存 + 磁盘存储。
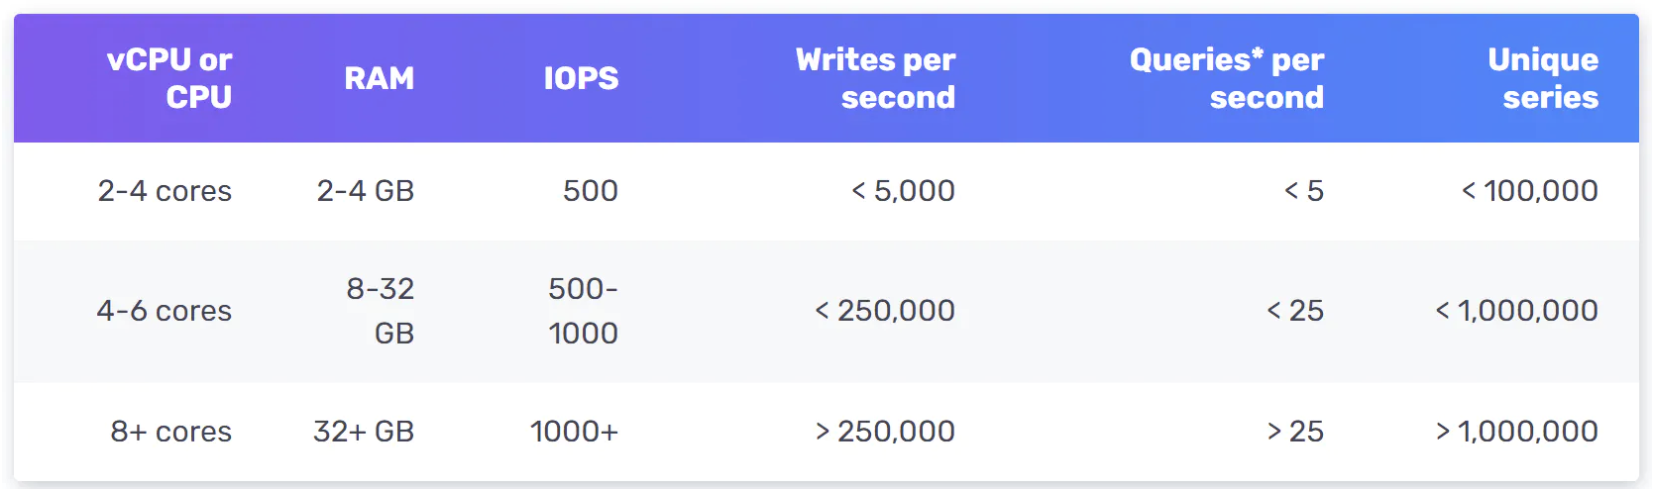
InfluxDB 的规模示例——配备 8 核和 32gb RAM 时每秒可写入超过 250k 次:
InfluxDB 规模参考 时序库的容量随规格变化:2–4 核 2–4 GB 可支撑每秒不到 5,000 次写入;4–6 核 8–32 GB 约 25 万次;8 核 32 GB 以上可超过每秒 25 万次写入、100 万条唯一序列。 2–4 核 / 2–4 GB 500 IOPS · <5,000 写入/秒 · <5 查询/秒 · <100,000 序列 4–6 核 / 8–32 GB 500–1,000 IOPS · <250,000 写入/秒 · <25 查询/秒 · <1,000,000 序列 8+ 核 / 32+ GB 1,000+ IOPS · >250,000 写入/秒 · >25 查询/秒 · >1,000,000 序列 不同规格下的写入 / 查询能力(InfluxDB 实测) 小规模 中等规模 8 核 32GB 可达 25 万次写入/秒 按 diagram-design 重绘 查看原图 并不要求你理解指标数据库的内部原理,因为这是细分领域知识。只有你在简历中提到过才可能被问到。
就面试而言,理解指标是时间序列数据并了解像 InfluxDB 这样的流行时序数据库就足够了。
时序数据库的一个优点是能够按标签高效聚合和分析大量时间序列数据。
例如,InfluxDB 会为每个标签构建索引。
然而,关键是要保持标签基数较低——即不要使用过多唯一标签。
高层设计
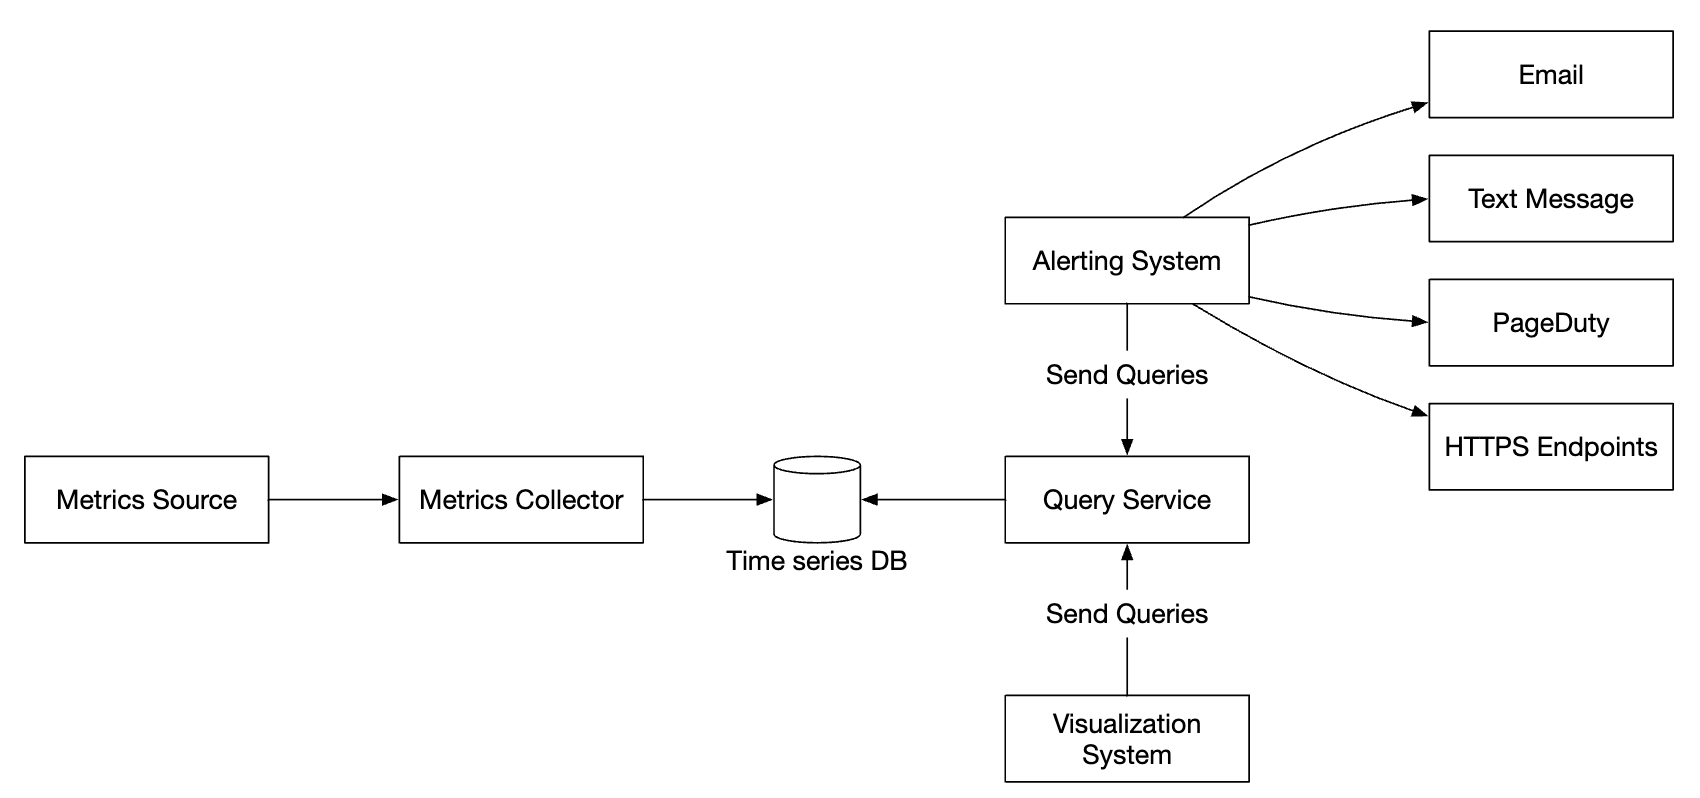
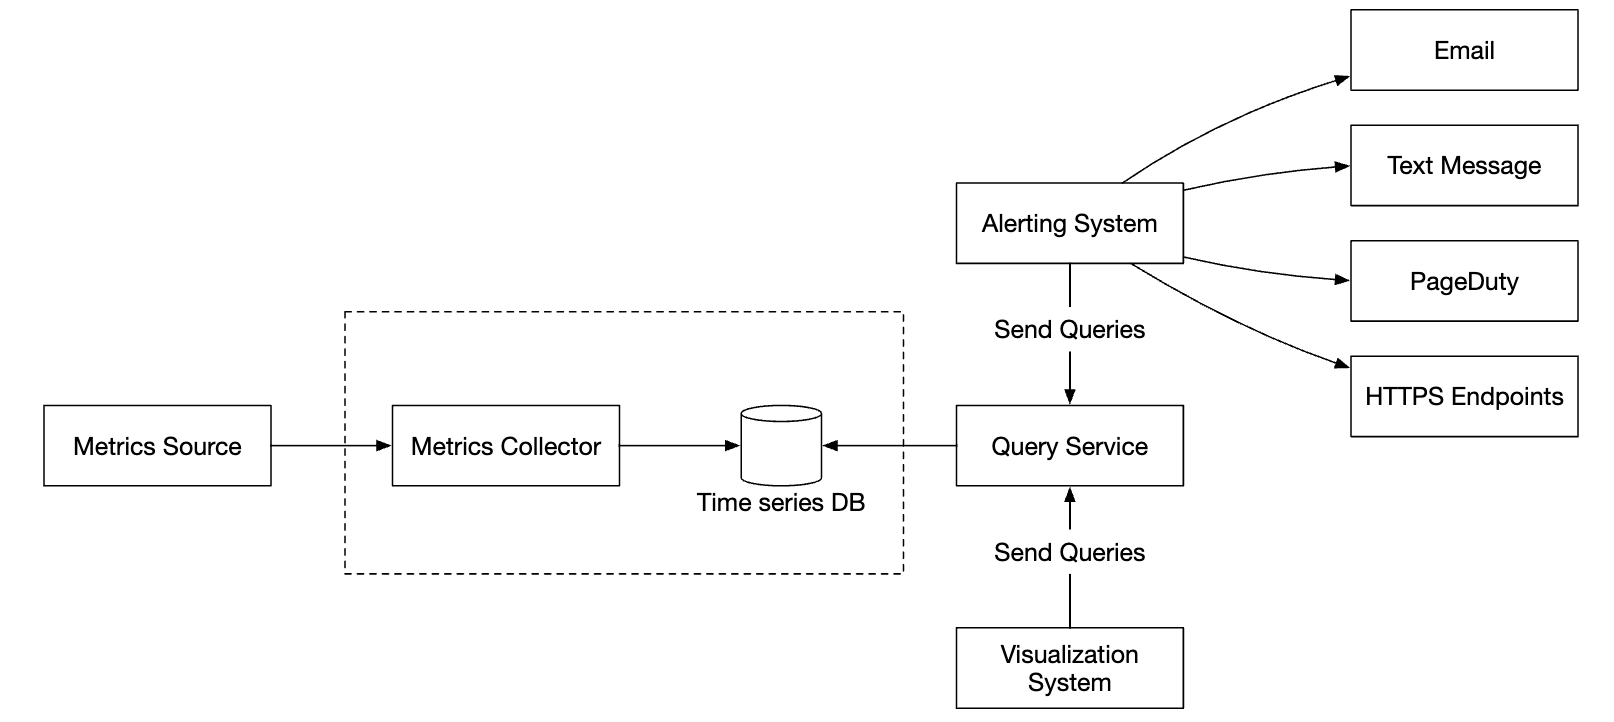
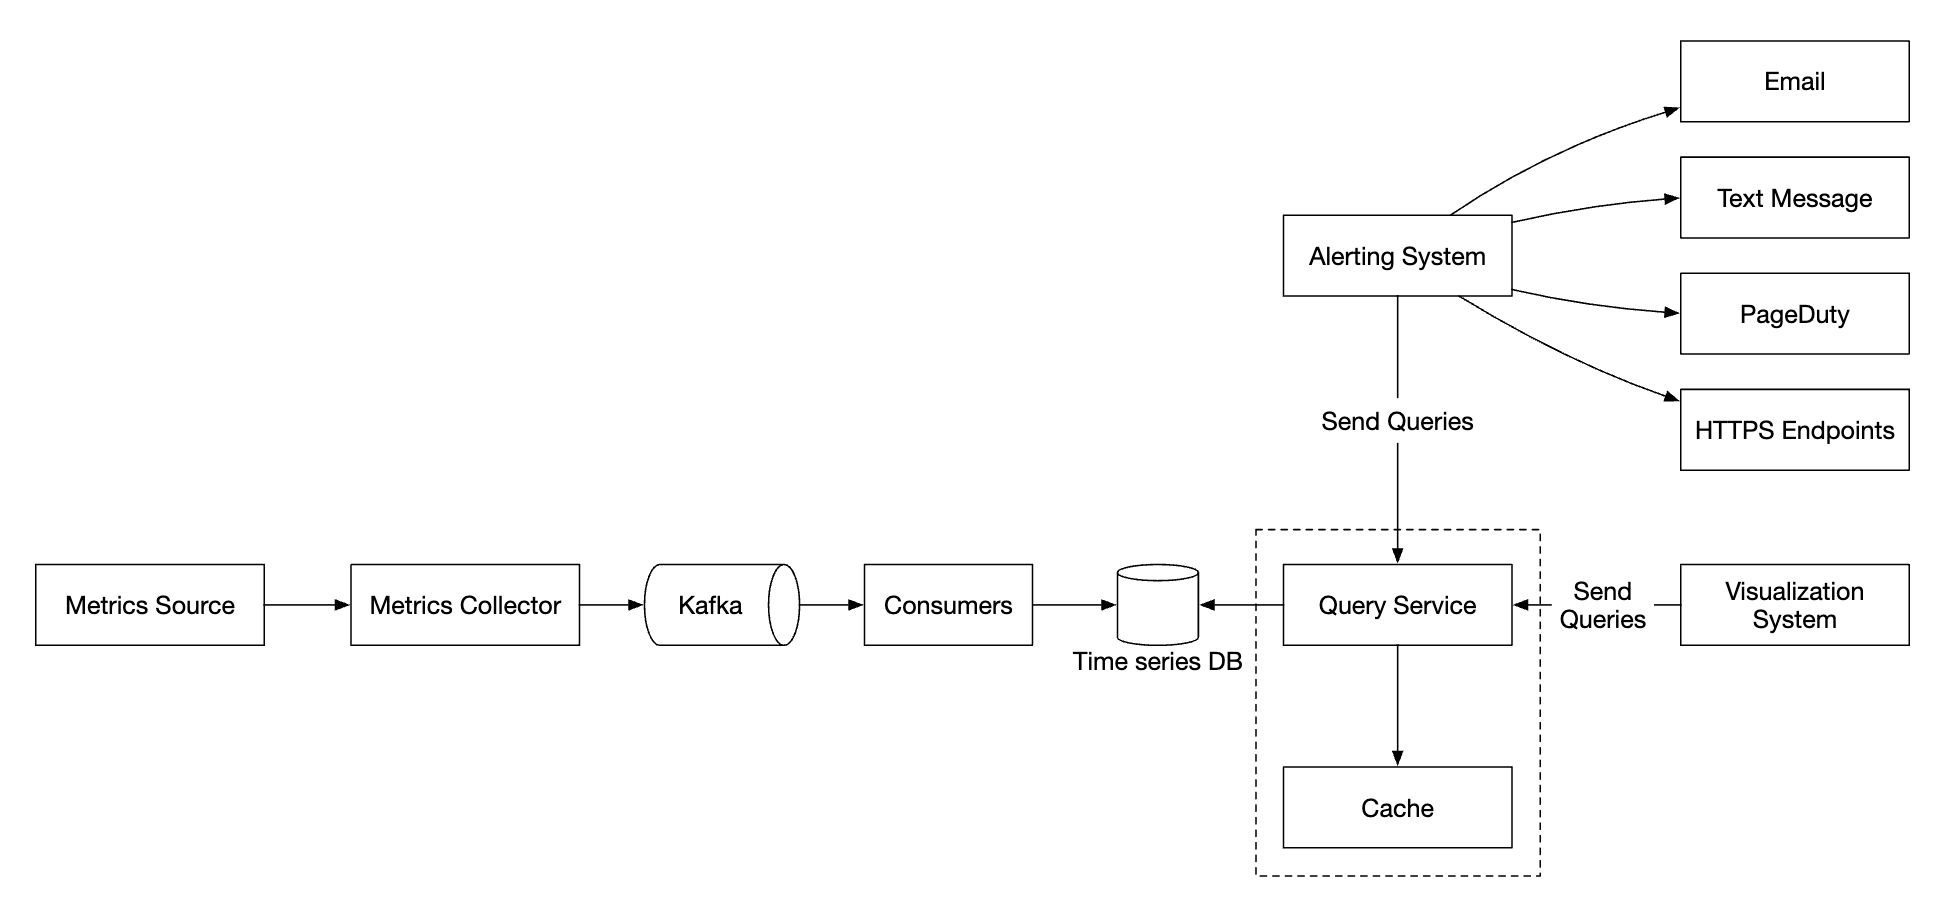
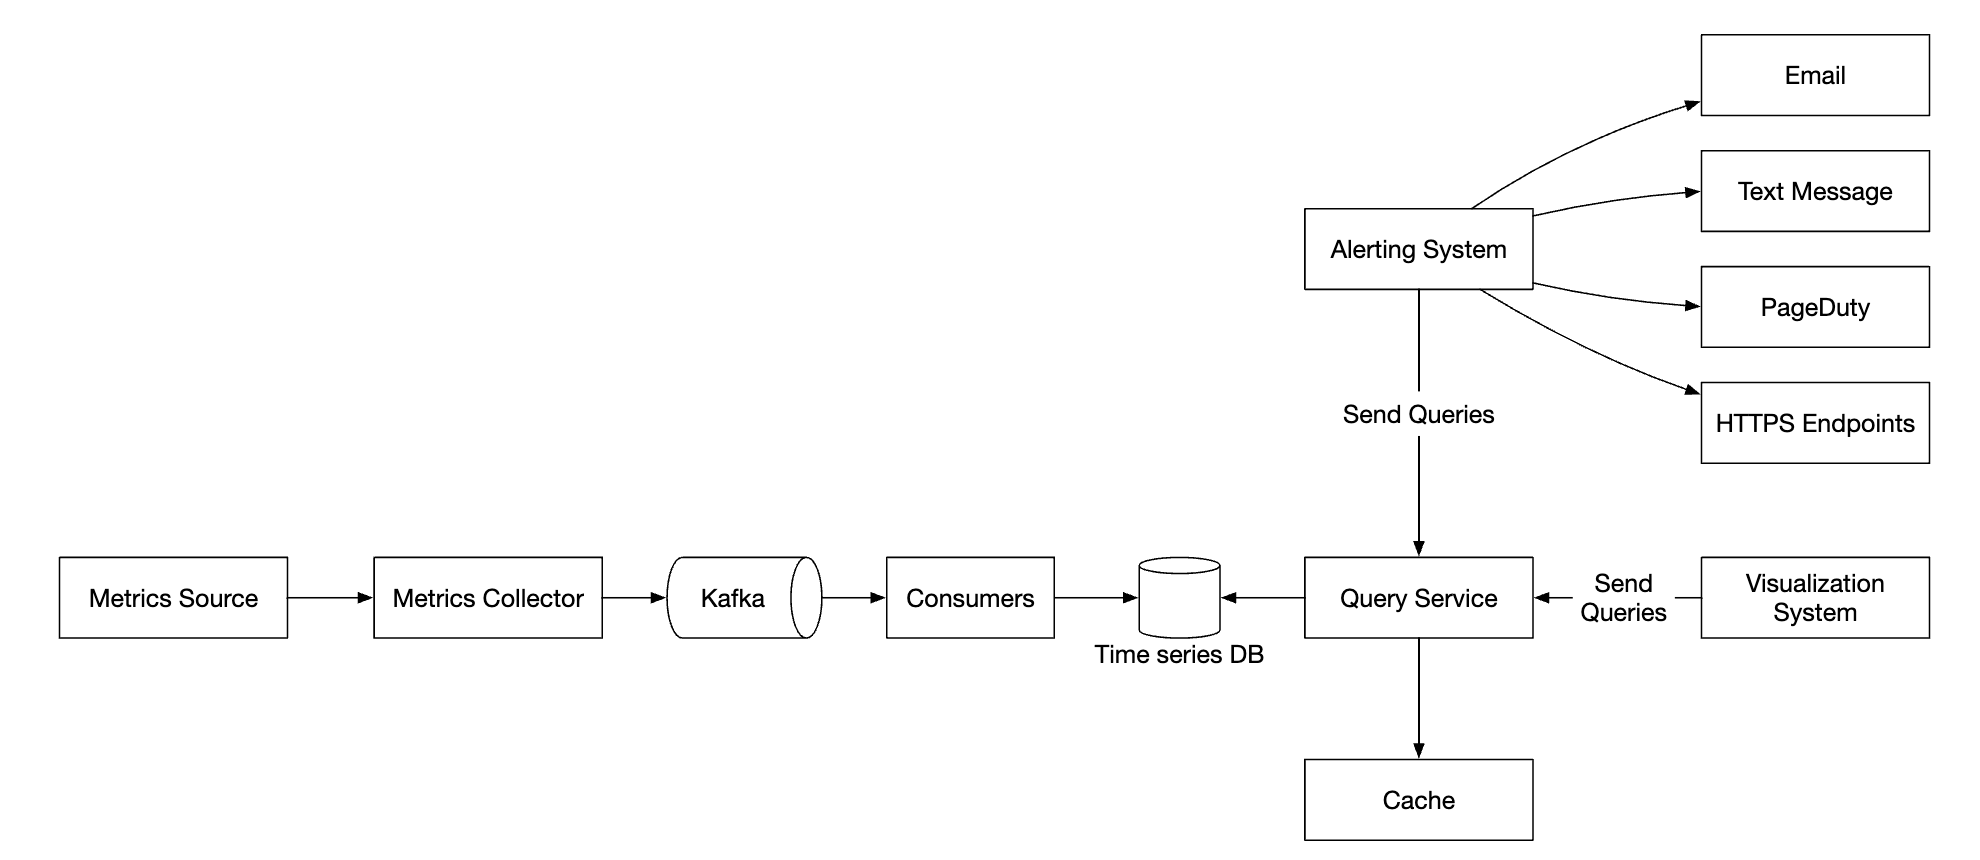
高层设计 指标源把数据交给采集器,采集器写入时序数据库;查询服务封装对数据库的读取,向上同时服务告警系统和可视化系统;告警系统按规则产生告警并投递到邮件、短信、PagerDuty、HTTPS 回调等通道。 指标源 服务器 / DB / 队列 指标采集器 采集并写入 时序数据库 按标签索引 查询服务 查询接口 告警系统 规则与去重 可视化系统 仪表盘 邮件 短信 PagerDuty HTTPS 回调 发送查询 发送查询 采集 → 存储 → 查询:告警与可视化都经查询服务读取数据 按 diagram-design 重绘 查看原图
指标来源 :可以是应用服务器、SQL 数据库、消息队列等。指标收集器 :收集指标数据并写入时序数据库时序数据库 :以时间序列形式存储指标。提供自定义查询接口用于分析大量指标。查询服务 :简化对时序数据库的查询和数据检索。如果数据库接口足够强大,可以完全被其替代。告警系统 :将告警通知发送到各种告警目的地。可视化系统 :以图形/图表形式展示指标。
第 3 步:深入设计
让我们深入探讨系统中几个更有趣的部分。
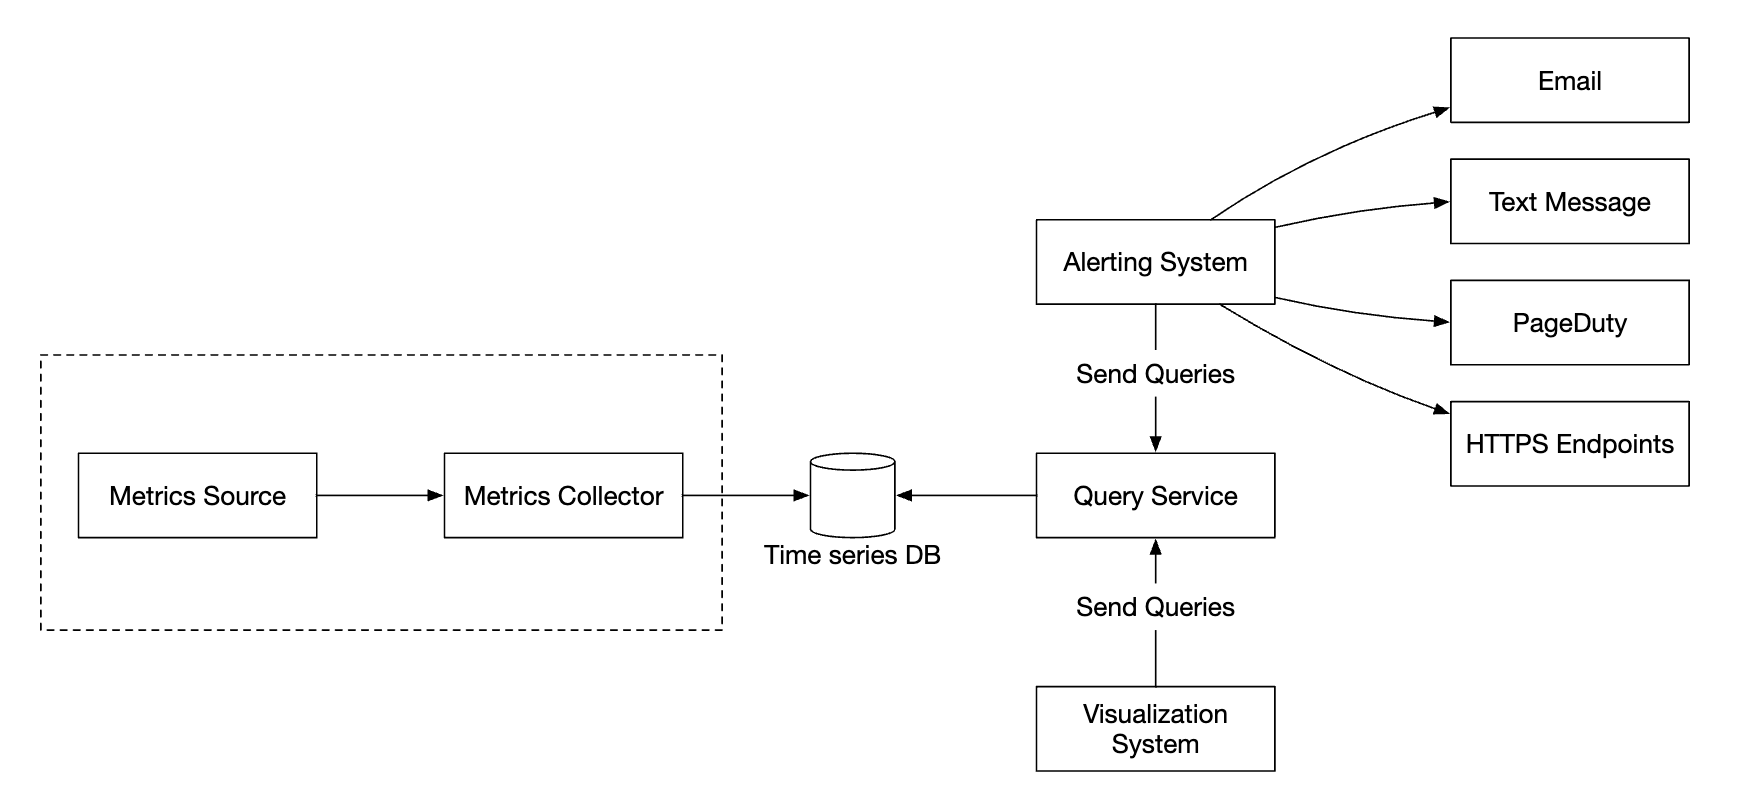
指标收集 对指标收集而言,偶尔的数据丢失并不致命。客户端可以发完即忘。
采集阶段:客户端发了就不管 采集阶段对偶发的数据丢失并不敏感,客户端可以「发了就不管」。图中虚线框标出的是采集范围:指标源到采集器这一段,采集器把数据写进时序库后交给查询服务。 采集范围 指标源 服务器 / DB / 队列 指标采集器 采集并写入 时序数据库 按标签索引 查询服务 查询接口 告警系统 规则与去重 可视化系统 仪表盘 邮件 短信 PagerDuty HTTPS 回调 发送查询 发送查询 采集容忍少量丢失:客户端可以「发了就不管」 按 diagram-design 重绘 查看原图 实现指标收集有两种方式——拉取或推送。
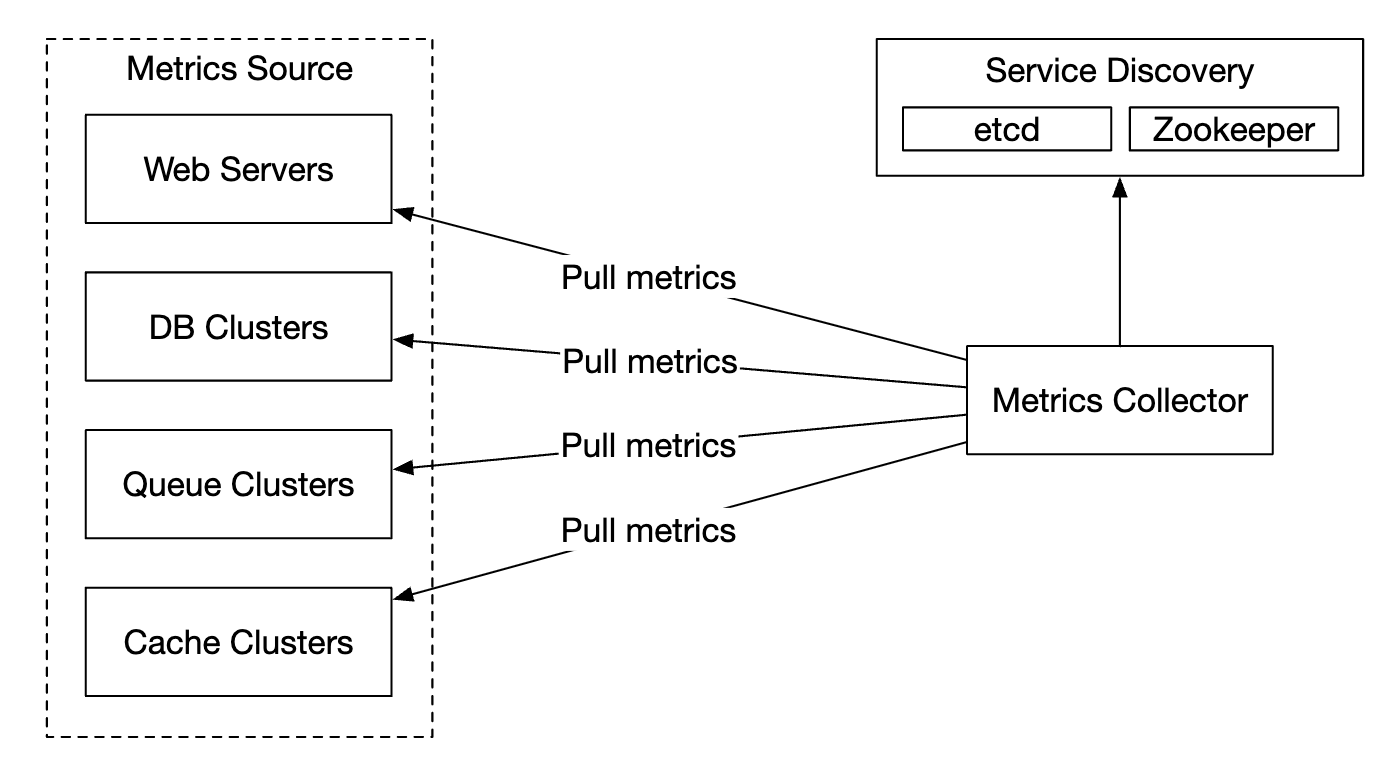
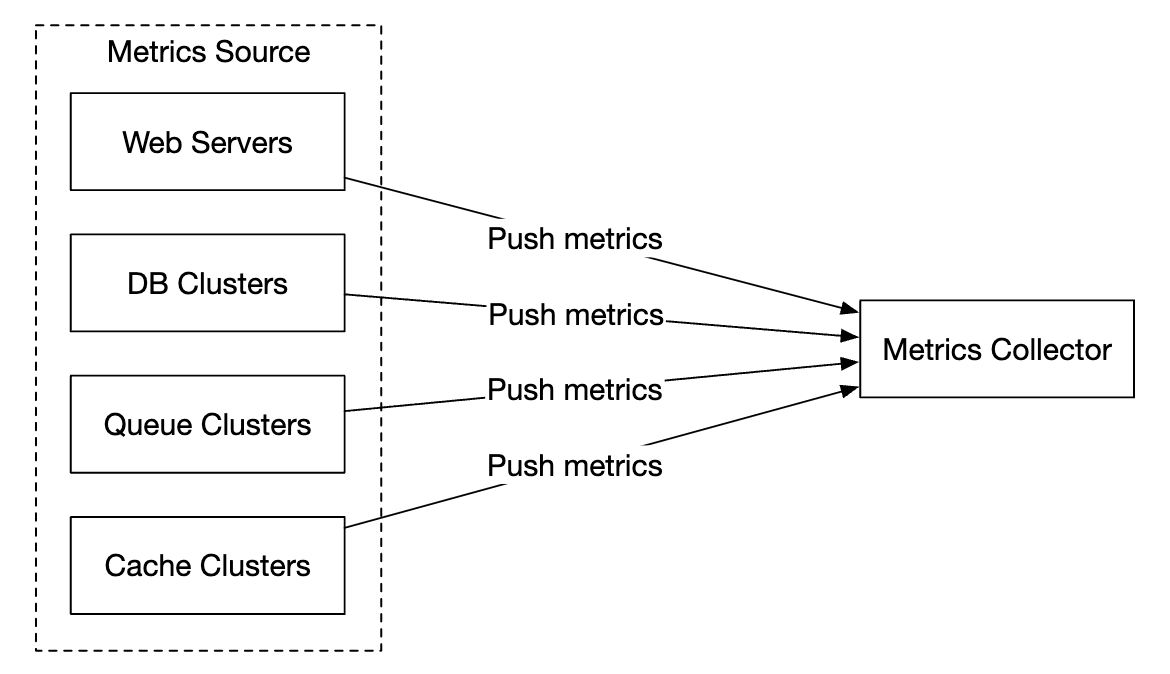
拉取模型的结构如下:
拉模型:采集器主动拉取 拉模型下,采集器按固定间隔主动向各类指标源(Web 服务器、DB 集群、队列集群、缓存集群)发起 HTTP 拉取;它需要一份随时更新的目标清单,因此要先从服务发现(etcd / Zookeeper)拿到地址与拉取参数。 指标源 服务发现 Web 服务器 DB 集群 队列集群 缓存集群 etcd Zookeeper 指标采集器 采集并写入 拉取指标 拉取指标 拉取指标 拉取指标 获取目标列表 先取目标清单,再按间隔逐个拉取 按 diagram-design 重绘 查看原图 对于此方案,指标收集器需要维护最新的服务列表和指标端点。
我们可以使用 Zookeeper 或 etcd 来实现——服务发现。
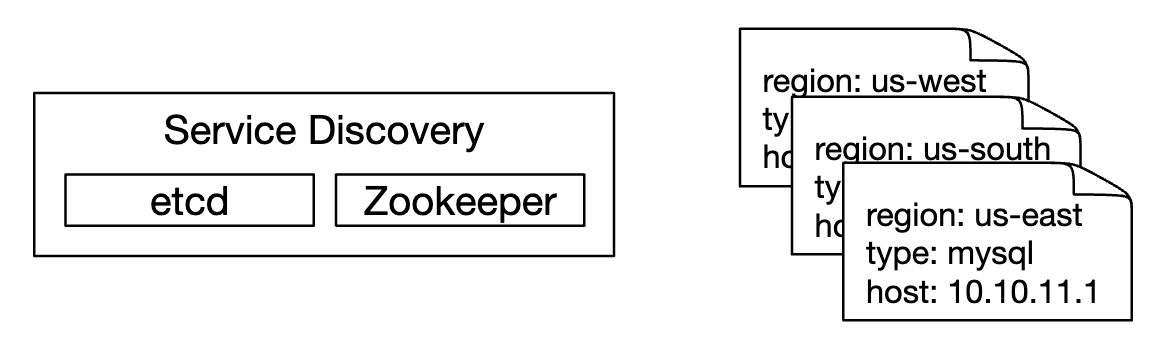
服务发现包含包含有关何时以及从何处收集指标的配置规则:
服务发现里的采集配置 服务发现(etcd / Zookeeper)保存着「从哪采、何时采」的规则。每条服务注册信息包含区域、类型与主机地址等字段,采集器据此决定拉取哪些端点、间隔多久、超时与重试怎么设。 服务发现 etcd Zookeeper region: us-west region: us-south region: us-east type: mysql · host: 10.10.11.1 配置规则 规则含拉取间隔、IP、超时与重试参数 每条注册信息:region / type / host 按 diagram-design 重绘 查看原图 下面对指标收集流程进行详细说明:
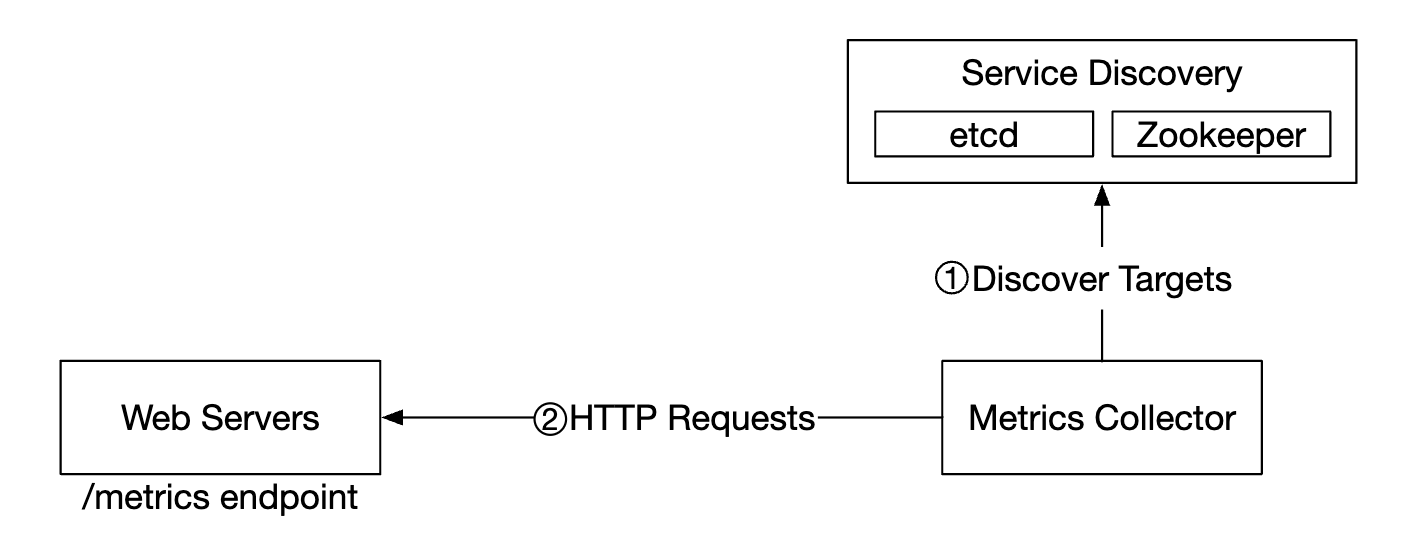
采集流程:发现目标 + HTTP 拉取 采集分两步:① 采集器从服务发现获取目标配置,拿到拉取间隔、IP、超时与重试参数;② 采集器按配置向应用服务器的 /metrics 端点发起 HTTP 请求,取回指标数据。端点变化时也可以注册变更通知或定期轮询。 服务发现 Web 服务器 /metrics 端点 指标采集器 etcd Zookeeper ① 发现目标 ② HTTP 请求 先拿配置,再按配置拉取 /metrics 端点 按 diagram-design 重绘 查看原图
指标收集器从服务发现获取配置元数据。这包括拉取间隔、IP 地址、超时和重试参数。
指标收集器通过预定义的 http 端点(例如 /metrics)拉取指标数据。这通常由客户端库完成。
或者,指标收集器可以向服务发现注册变更事件通知,以便在服务端点发生变化时得到通知。
另一种选择是指标收集器定期轮询指标端点配置变化。
在我们的规模下,单个指标收集器是不够的,必须有多个实例。
然而,它们之间还需要某种同步,以免两个收集器重复收集相同指标。
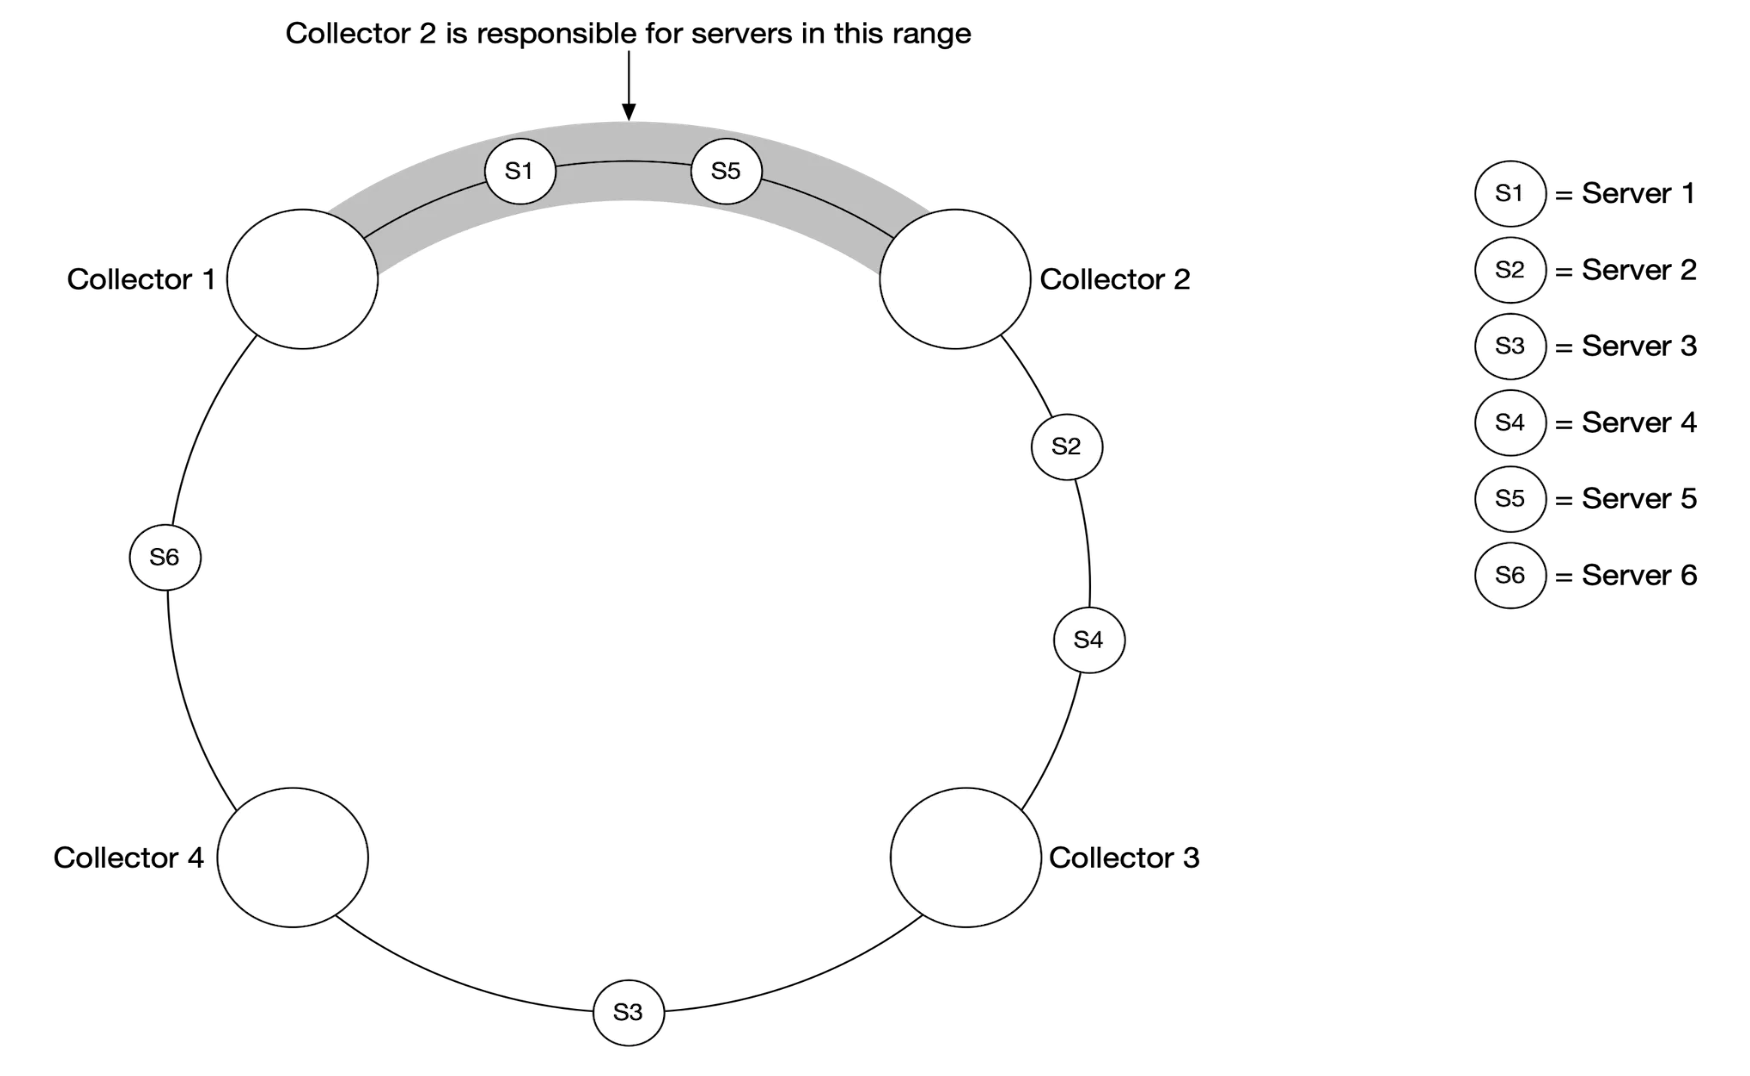
一种解决方案是将收集器和服务器放在一致性哈希环上,并仅将一组服务器关联到单个收集器:
采集器与服务器落在同一个哈希环上 单机采集器扛不住规模,需要多实例,但多个采集器不能重复采集同一台机器。把采集器和服务器放到同一个一致性哈希环上,每个采集器只负责环上一段连续区间内的服务器,从而天然完成分工。图中把环展开成直线,虚线表示顺时针相邻。 哈希环(展开,顺时针) Collector 1 Collector 2 Collector 3 Collector 4 S1 S2 S3 S4 S5 S6 高亮:Collector 2 负责 S3、S4 所在区间 每个采集器只负责环上一段连续区间,互不重叠 按 diagram-design 重绘 查看原图 而推送模型则相反,服务主动将指标推送给指标收集器:
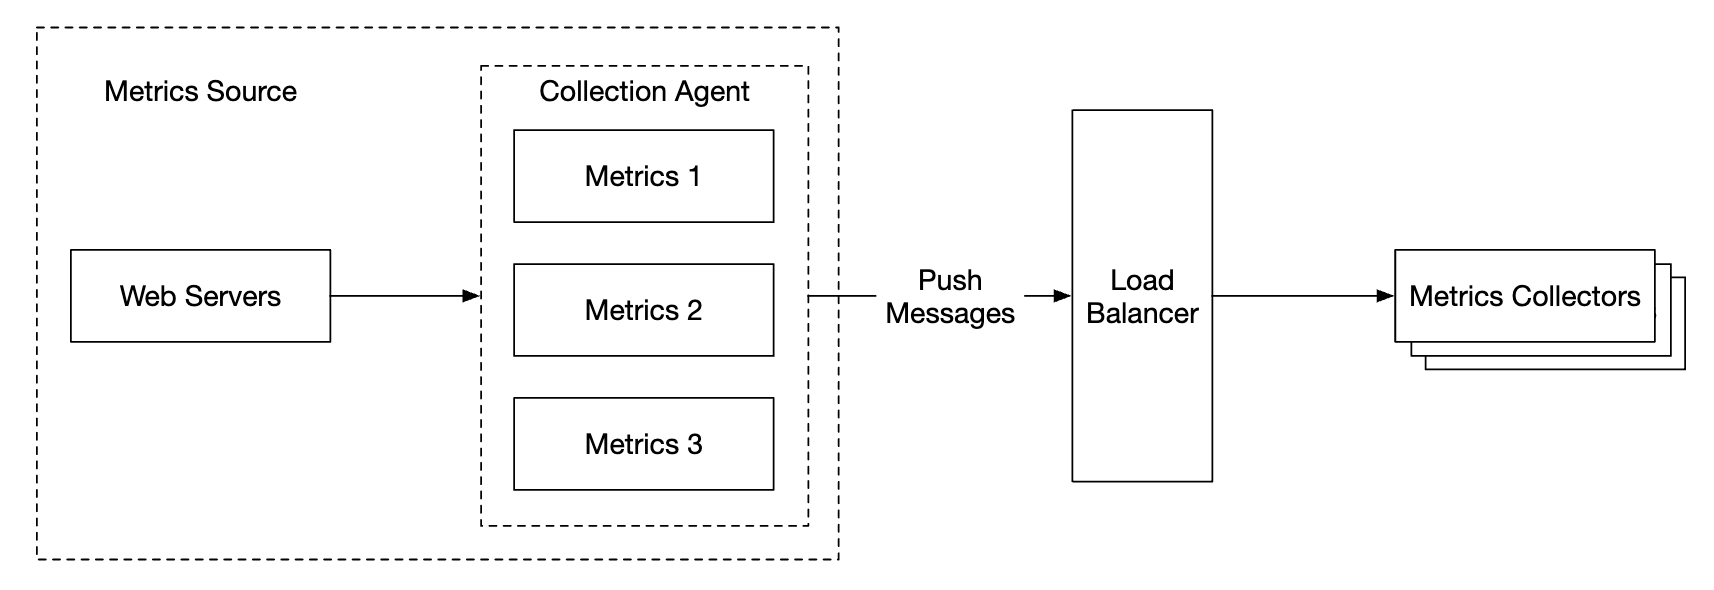
推模型:服务主动上报 推模型下由各类指标源主动把指标推给采集器;采集器同样从服务发现读取配置。因为推请求可能被采集器拒绝,采集器需要放到负载均衡器后面的自动扩缩容组里,才能扛住突发流量。 指标源 服务发现 Web 服务器 DB 集群 队列集群 缓存集群 etcd Zookeeper 指标采集器 采集并写入 推送指标 推送指标 推送指标 推送指标 获取目标列表 采集器需置于负载均衡后的自动扩缩容组 按 diagram-design 重绘 查看原图 在这种方法中,通常会在服务实例旁安装一个收集代理。
该代理从服务器收集指标并将其推送到指标收集器。
推模型:采集代理 + 负载均衡 推模型通常在服务实例旁装一个采集代理:代理从本机收集若干类指标,先做简单聚合再统一推送,从而减少采集器要处理的数据量。推送请求经负载均衡器分发到一组可自动扩缩容的采集器。 指标源 采集代理 Web 服务器 Metrics 1 Metrics 2 Metrics 3 负载均衡 指标采集器 自动扩缩容 推送消息 代理先做本地聚合,再统一推送 采集器置于负载均衡后的自动扩缩容组 按 diagram-design 重绘 查看原图 使用此模型,我们可以在将指标发送到收集器之前进行聚合,从而减少收集器处理的数据量。
另一方面,指标收集器可能因无法承受负载而拒绝推送请求。
因此,将收集器放在负载均衡器后的自动扩缩组中非常重要。
那么哪种更好?两种方法各有权衡,不同系统使用不同方法:
Prometheus 使用拉取架构
Amazon Cloud Watch 和 Graphite 使用推送架构
以下是拉取和推送之间的一些主要区别:
拉取
推送
易于调试
应用服务器上用于拉取指标的 /metrics 端点可随时查看指标,你甚至可以在自己的笔记本电脑上完成。拉取胜出。
如果指标收集器没有收到指标,问题可能由网络问题引起。
健康检查
如果应用服务器不响应拉取,你可以快速判断应用服务器是否宕机。拉取胜出。
如果指标收集器没有收到指标,问题可能由网络问题引起。
短生命周期任务
某些批处理作业可能是短生命周期的,持续时间太短而无法被拉取。推送胜出。可以通过为拉取模型引入推送网关来修复 [22]。
防火墙或复杂网络环境
让服务器拉取指标要求所有指标端点都可访问。这在多数据中心环境中可能有问题,可能需要更复杂的网络基础设施。
如果指标收集器配有负载均衡器和自动扩缩组,则可以从任何地方接收数据。推送胜出。
性能
拉取方法通常使用 TCP。
推送方法通常使用 UDP。这意味着推送方法提供更低延迟的指标传输。反驳观点是,建立 TCP 连接的开销与发送指标负载相比很小。
数据真实性
要收集指标的应用服务器在配置文件中预先定义,从这些服务器收集的指标可保证真实。
任何类型的客户端都可以向指标收集器推送指标。可以通过将接收指标的服务器加入白名单或要求认证来修复。
没有明显的赢家。大型组织可能需要同时支持两者。首先可能根本没有办法安装推送代理。
扩展指标传输管道
扩展指标传输管线 无论推模型还是拉模型,采集器都部署在自动扩缩容组里。图中虚线框标出的是传输段:采集器把指标写进时序库;若时序库故障则可能丢数据,因此后面还要引入排队机制兜底。 传输段(自动扩缩容) 指标源 服务器 / DB / 队列 指标采集器 采集并写入 时序数据库 按标签索引 查询服务 查询接口 告警系统 规则与去重 可视化系统 仪表盘 邮件 短信 PagerDuty HTTPS 回调 发送查询 发送查询 采集器放进自动扩缩容组;时序库故障时需要兜底 按 diagram-design 重绘 查看原图 无论我们使用推送还是拉取模型,指标收集器都部署在自动扩缩组中。
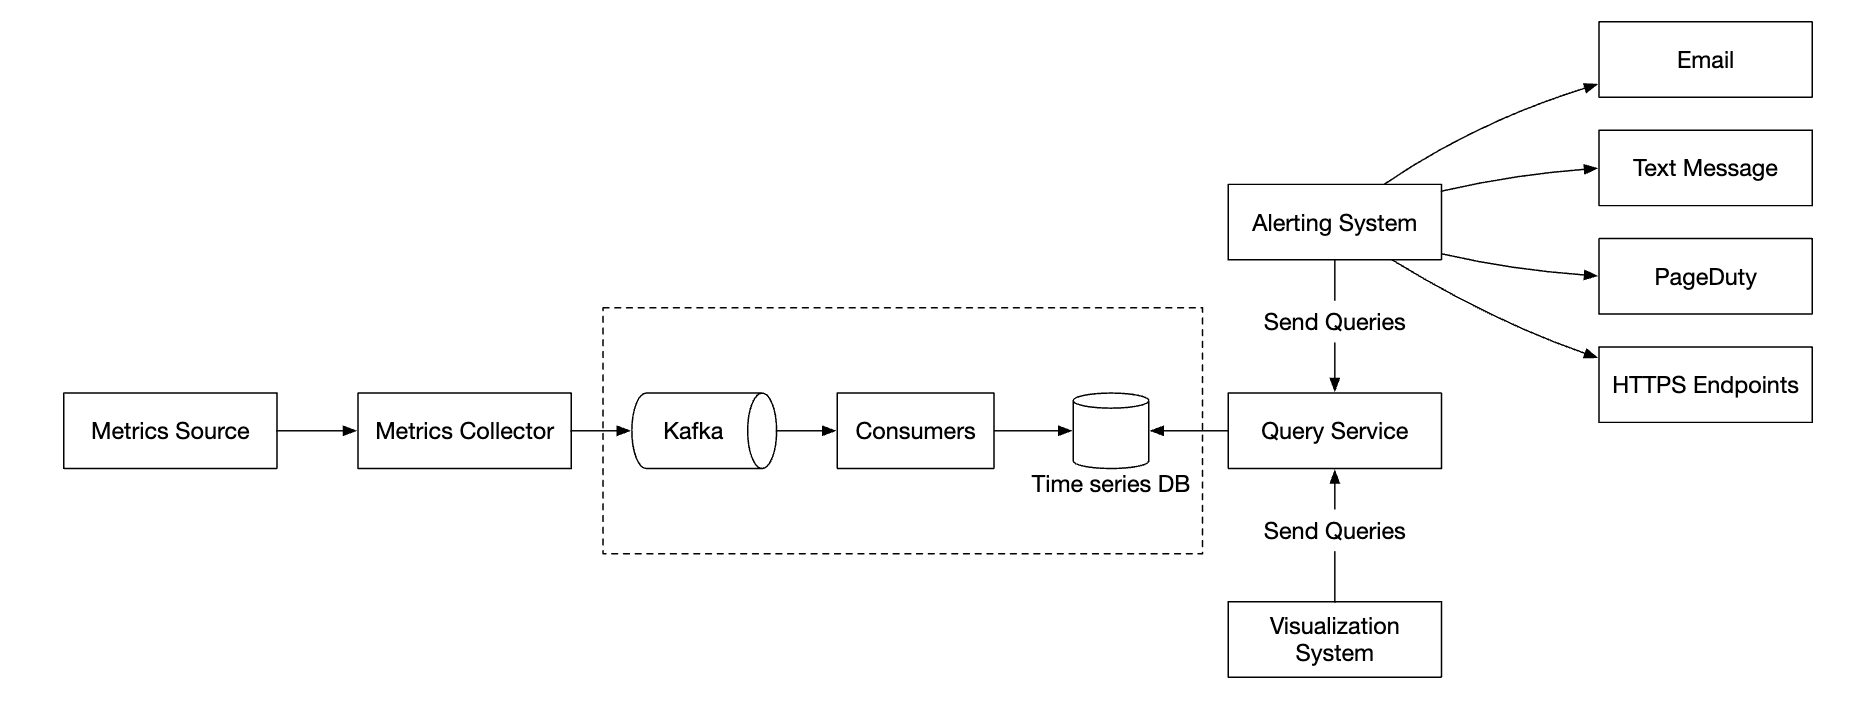
然而,如果时序数据库宕机,就有数据丢失的风险。为了缓解这一点,我们将引入排队机制:
排队机制:Kafka 削峰与解耦 为防时序库故障时丢数据,在采集器和数据库之间加一层队列:采集器把指标写进 Kafka,消费者(Storm / Flink / Spark)拉取、处理后再写库。Kafka 高可靠可扩展,把采集与处理解耦,并靠保留数据避免丢失。 排队缓冲与流处理 指标源 指标采集器 Kafka 排队缓冲 消费者 流处理 时序数据库 查询服务 告警系统 规则与去重 邮件 短信 PagerDuty HTTPS 回调 可视化系统 仪表盘 发送查询 发送查询 Kafka 按指标名分区,消费者可按指标聚合 按 diagram-design 重绘 查看原图
指标收集器将指标数据推送到 Kafka
消费者或流处理服务(如 Apache Storm、Flink 或 Spark)处理数据并将其推送到时序数据库
这种方法有几个优点:
Kafka 被用作高可靠且可扩展的分布式消息平台
将数据收集与数据处理解耦
通过在 Kafka 中保留数据来防止数据丢失
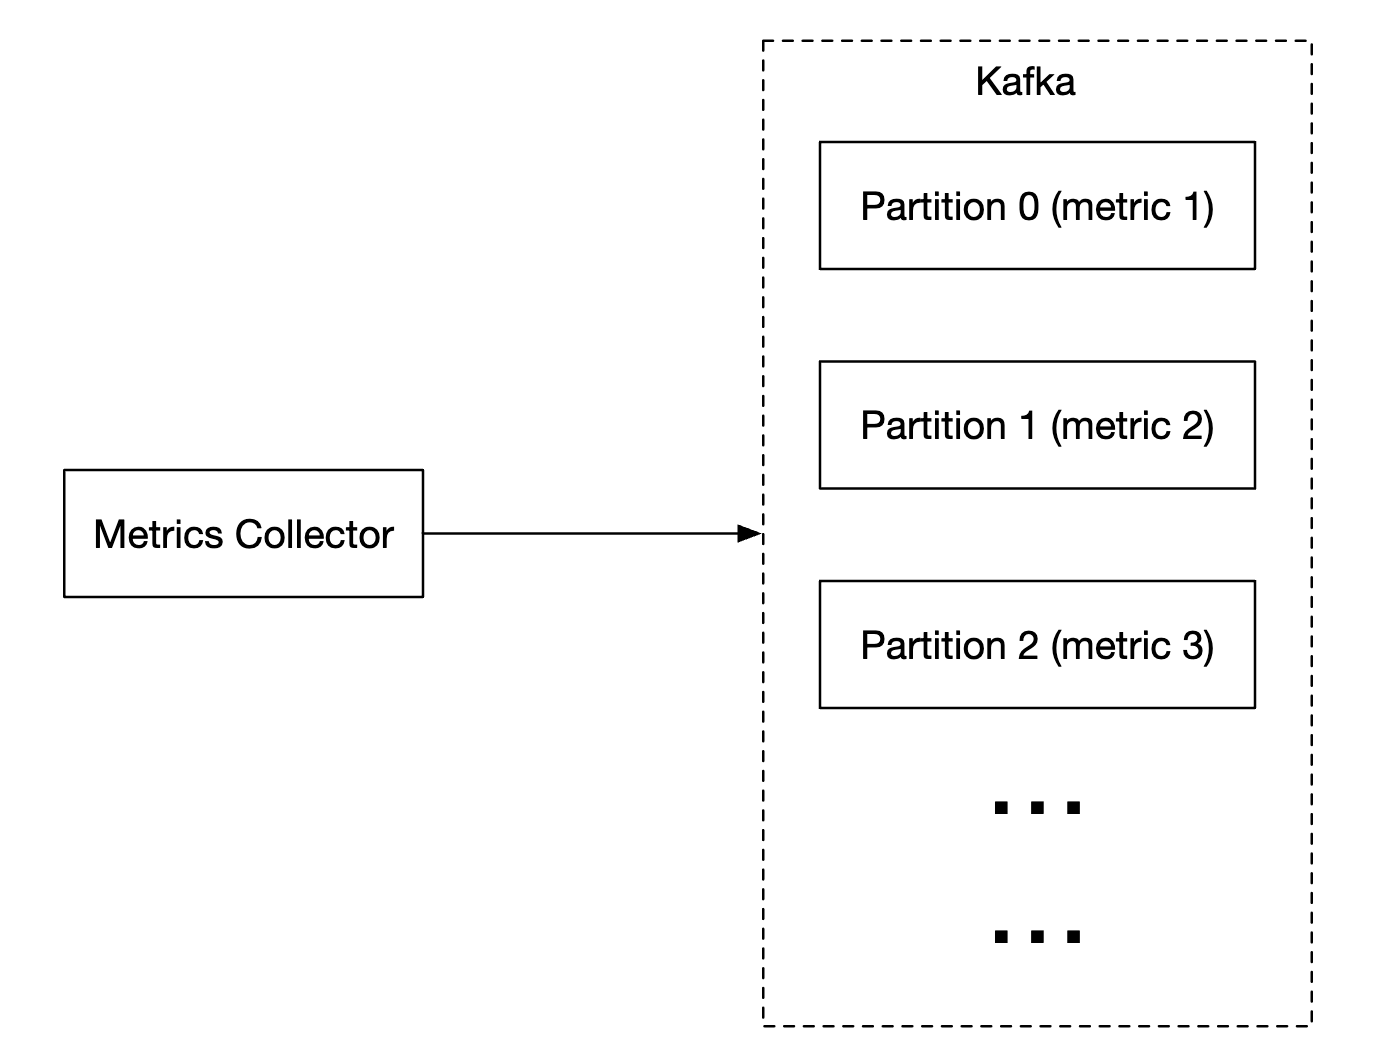
可以将 Kafka 配置为每个指标名称一个分区,以便消费者按指标名称聚合数据。
为了扩展,我们还可以按标签/标签进一步分区,并对要优先收集的指标进行分类/优先级排序。
Kafka 按指标名分区 Kafka 可以配置成「每个指标名一个分区」:metric 1 进 Partition 0,metric 2 进 Partition 1,metric 3 进 Partition 2,以此类推。这样消费者可以按指标名各自聚合;要再扩展,可以继续按标签分区,并给指标排优先级。 Kafka 指标采集器 Partition 0 metric 1 Partition 1 metric 2 Partition 2 metric 3 按指标名分区 一个指标名一个分区,消费者按指标聚合 再扩展:按标签分区并给指标排优先级 按 diagram-design 重绘 查看原图 对这个问题使用 Kafka 的主要缺点是维护/运营开销。
另一种方案是使用像 Gorilla 这样的大规模摄入系统。
可以说,使用它和用 Kafka 排队一样可扩展。
聚合可以发生在哪里 指标可以在几个地方进行聚合。不同选择之间各有权衡:
收集代理 :客户端收集代理仅支持简单的聚合逻辑。例如,收集 1m 的计数器并发送给指标收集器。摄入管道 :要在写入数据库前聚合数据,我们需要像 Flink 这样的流处理引擎。这降低了写入量,但由于不存储原始数据而丢失数据精度。查询侧 :我们可以在通过可视化系统运行查询时聚合数据。没有数据丢失,但查询可能因大量数据处理而变慢。
查询服务 将查询服务与时序数据库分离,可将可视化和告警系统与数据库解耦,使我们能够将数据库与客户端解耦并随意更换。
我们可以在此处添加缓存层以降低时序数据库的负载:
查询服务加缓存层 在时序库和可视化 / 告警之间加一层查询服务,能解耦客户端与数据库,让我们随时换库。再在查询服务下挂一层缓存,把热点查询结果存起来,显著降低时序库的读压力。 查询服务与缓存层 指标源 指标采集器 Kafka 排队缓冲 消费者 流处理 时序数据库 查询服务 查询接口 告警系统 规则与去重 缓存 缓存最近查询 可视化系统 仪表盘 邮件 短信 PagerDuty HTTPS 回调 发送查询 读写缓存 发送查询 查询服务解耦客户端与数据库,缓存降低读压力 按 diagram-design 重绘 查看原图 我们也可以完全避免添加查询服务,因为大多数可视化和告警系统都有强大的插件可与大多数时序数据库集成。
选择了合适的时序数据库后,我们甚至可能不需要引入自己的缓存层。
大多数时序数据库不支持 SQL,因为 SQL 对查询时间序列数据效率不高。下面是一个计算指数移动平均的 SQL 查询示例:
select id,
       temp,
       avg(temp) over (partition by group_nr order by time_read) as rolling_avg
from (
  select id,
         temp,
         time_read,
         interval_group,
         id - row_number() over (partition by interval_group order by time_read) as group_nr
  from (
    select id,
    time_read,
    "epoch"::timestamp + "900 seconds"::interval * (extract(epoch from time_read)::int4 / 900) as interval_group,
    temp
    from readings
  ) t1
) t2
order by time_read;
这是同一个查询在 Flux 中的写法——Flux 是 InfluxDB 中使用的查询语言:
from(db:"telegraf")
  |> range(start:-1h)
  |> filter(fn: (r) => r._measurement == "foo")
  |> exponentialMovingAverage(size:-10s)
存储层 谨慎选择时序数据库非常重要。
根据 Facebook 发布的研究,约 85% 对运营存储的查询都是针对过去 26h 的数据。
如果我们选择一个能利用这一特性的数据库,可能会对系统性能产生显著影响。InfluxDB 就是这样的一个选择。
无论我们选择哪种数据库,都有一些可以采用的优化手段。
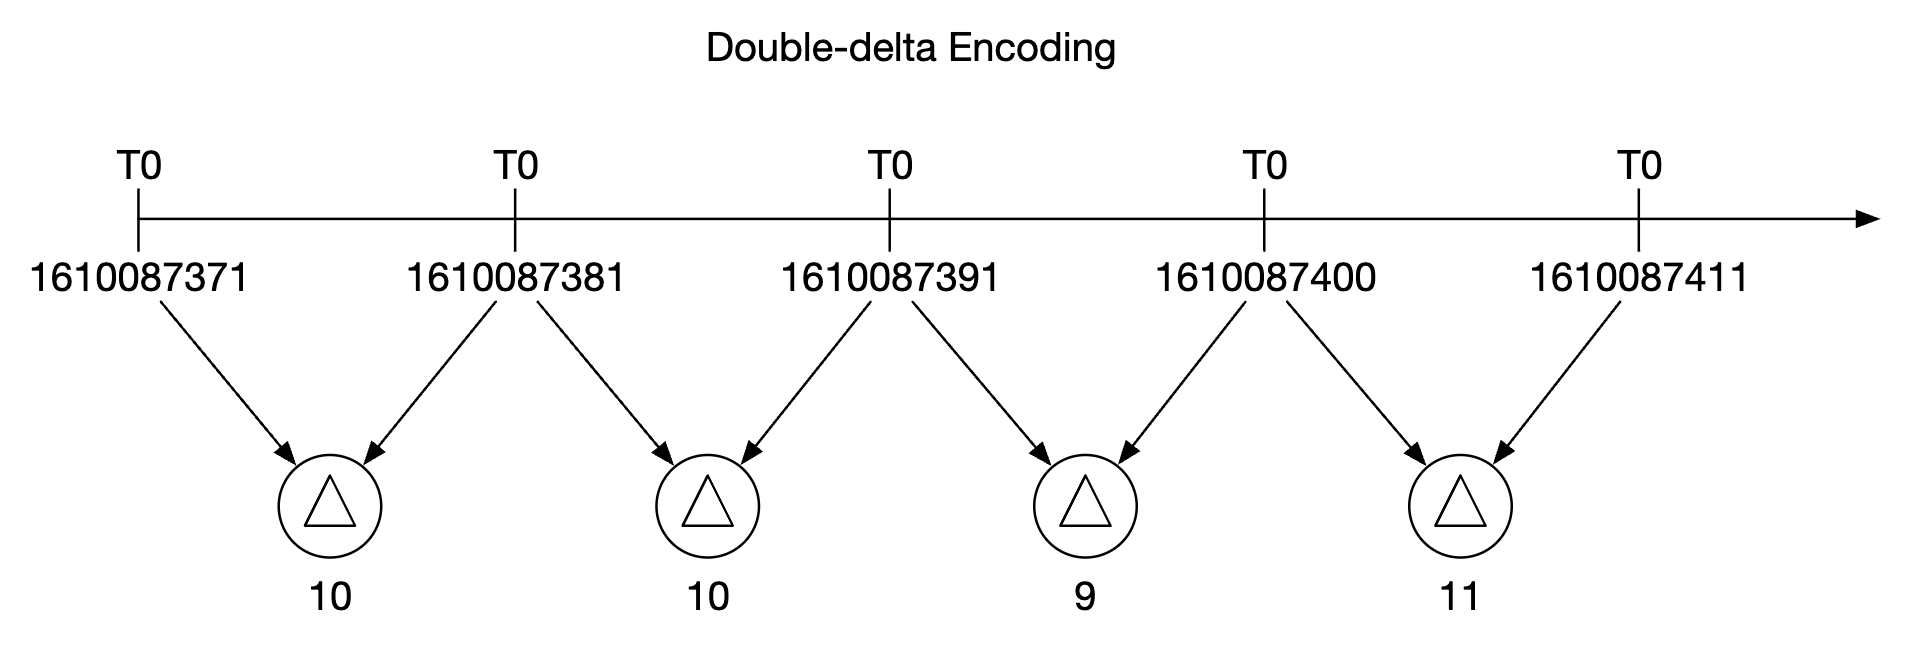
数据编码和压缩可以显著减小数据大小。这些功能通常已内置在优秀的时序数据库中。
双差分编码 时间戳序列 1610087371、1610087381、1610087391… 往往等间隔。与其存完整时间戳,不如存相邻两个时间戳的差值(delta),再对差值序列本身做一次编码——因为差值大多相同,只需记录少数变化点,压缩率很高。 1610087371 1610087381 1610087391 1610087400 1610087411 10 差值 10 差值 9 差值 11 差值 存时间戳差值,而不是完整时间戳 差值序列再编码:多数相同,只需记录变化点 按 diagram-design 重绘 查看原图 在上面的示例中,我们可以存储时间戳差值,而不是存储完整时间戳。
我们可以采用的另一种技术是降采样——将高分辨率数据转换为低分辨率,以减少磁盘使用量。
我们可以对旧数据使用这种方法,并让数据科学家可配置规则,例如:
7d——不降采样
30d——降采样到 1min
1y——降采样到 1h
例如,下面是一个 10 秒分辨率的指标表:
指标
时间戳
主机名
指标值
cpu
2021-10-24T19:00:00Z
host-a
10
cpu
2021-10-24T19:00:10Z
host-a
16
cpu
2021-10-24T19:00:20Z
host-a
20
cpu
2021-10-24T19:00:30Z
host-a
30
cpu
2021-10-24T19:00:40Z
host-a
20
cpu
2021-10-24T19:00:50Z
host-a
30
降采样到 30 秒分辨率:
指标
时间戳
主机名
指标值(平均)
cpu
2021-10-24T19:00:00Z
host-a
19
cpu
2021-10-24T19:00:30Z
host-a
25
最后,我们还可以使用冷存储来存放不再使用的旧数据。冷存储的财务成本要低得多。
告警系统
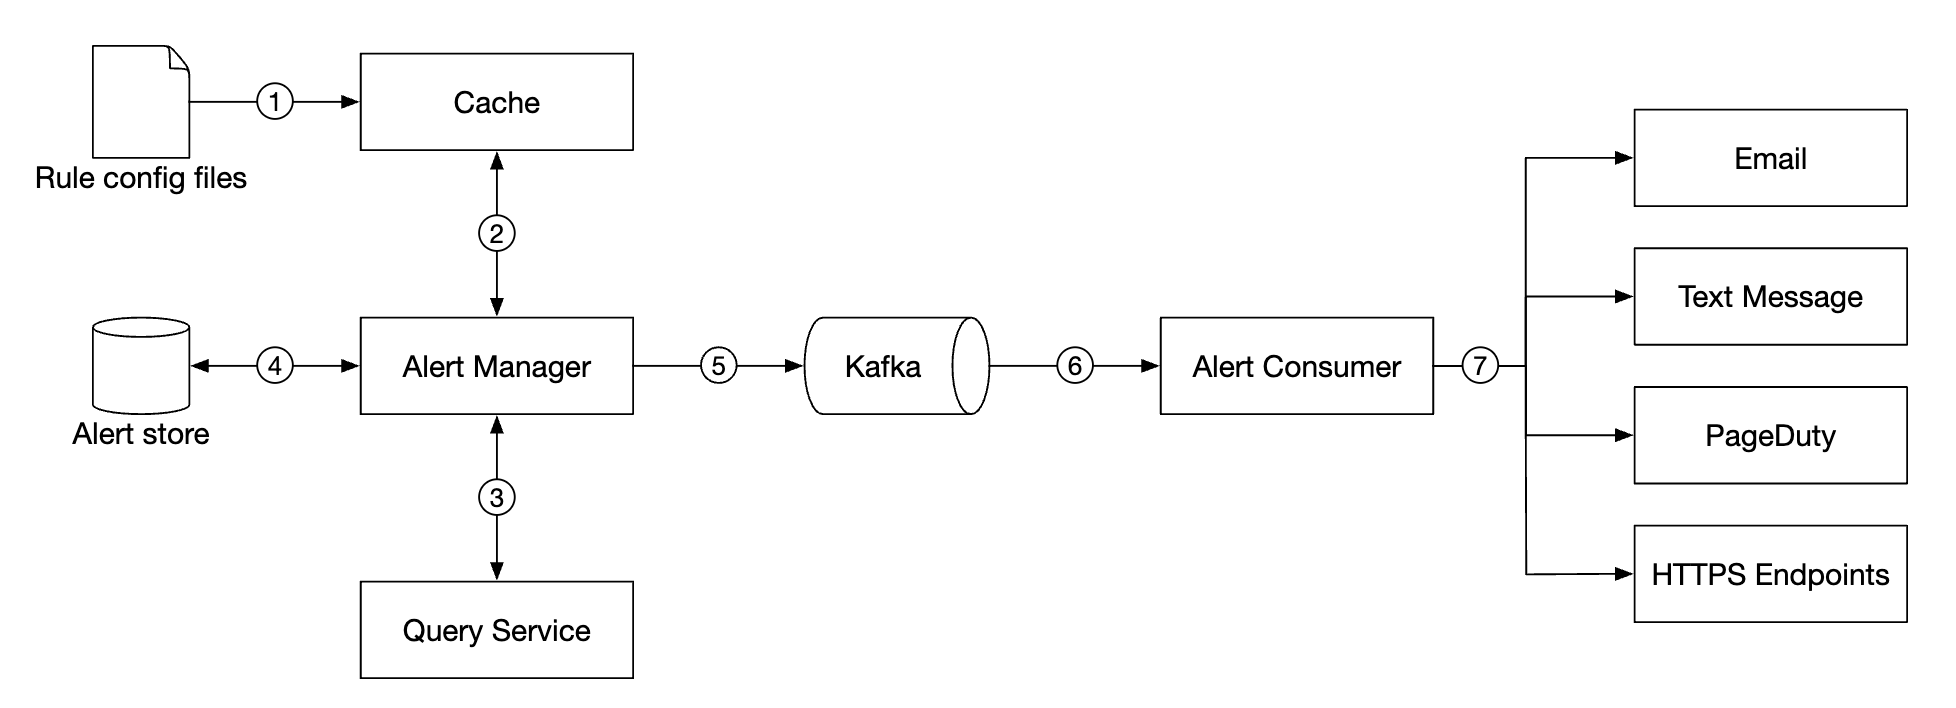
告警系统的七步链路 ① 规则配置(YAML)加载进缓存;② 告警管理器从缓存读取规则;③ 按固定间隔调用查询服务;④ 命中的告警写入 Alert store(KV 库,保证至少通知一次);⑤ 告警发布到 Kafka;⑥ 告警消费者从 Kafka 拉取;⑦ 按通道发出邮件、短信、PagerDuty、HTTPS 回调。 规则配置文件 YAML 规则 缓存 Alert store 告警状态 告警管理器 规则与去重 Kafka 告警消费者 查询服务 查询接口 邮件 短信 PagerDuty HTTPS 回调 ① 读取 ② 加载规则 ③ 调用查询 ④ 存状态 ⑤ 发布 ⑥ 拉取 ⑦ 通知 告警管理器负责过滤、合并、去重,并保证至少通知一次 按 diagram-design 重绘 查看原图 配置被加载到缓存服务器。规则通常以 YAML 格式定义。示例如下:
- name: instance_down
  rules:

  # Alert for any instance that is unreachable for >5 minutes.
  - alert: instance_down
    expr: up == 0
    for: 5m
    labels:
      severity: page
告警管理器从缓存中获取告警配置。根据配置规则,它还会按预定义间隔调用查询服务。
如果满足某条规则,就会创建告警事件。
告警管理器的其他职责包括:
过滤、合并和去重告警。例如,如果单个实例的告警被触发多次,只生成一个告警事件。
访问控制——必须将告警管理操作限制在特定人员范围内
重试——管理器确保告警至少被传播一次。
告警存储是一个键值数据库,如 Cassandra,用于保存所有告警的状态。它确保通知至少发送一次。
一旦告警被触发,就会发布到 Kafka。
最后,告警消费者从 Kafka 拉取告警数据,并通过不同渠道发送通知——邮件、短信、PagerDuty、webhooks。
现实世界中,有许多现成的告警系统解决方案。很难证明自己构建内部系统是合理的。
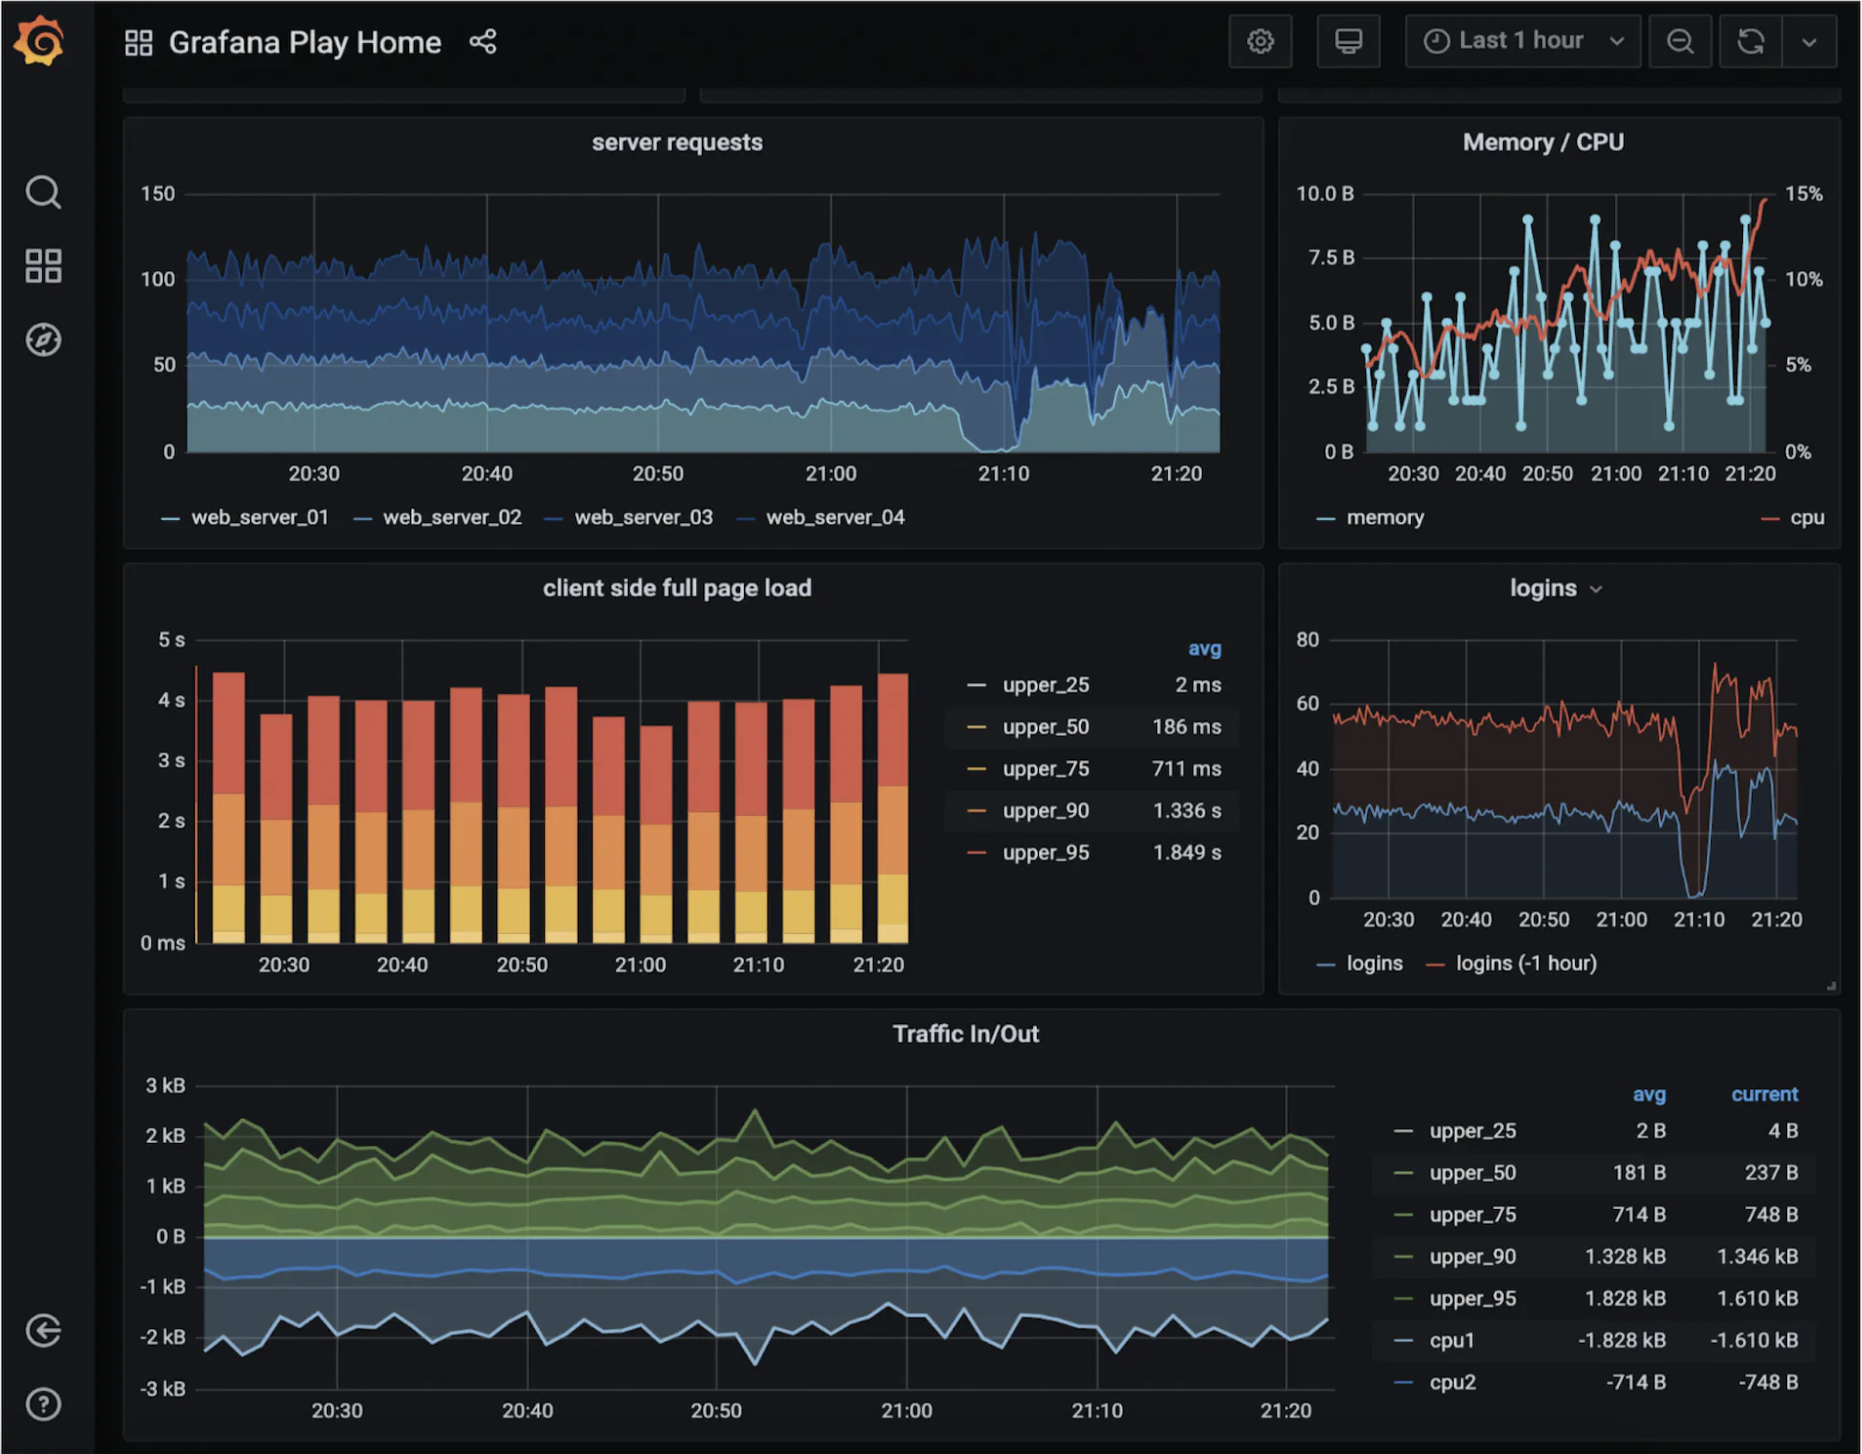
可视化系统 可视化系统展示一段时间内的指标和告警。下面是使用 Grafana 构建的仪表盘:
Grafana 仪表盘示例 可视化系统把一段时间内的指标画成图表。这是一个 Grafana 面板:左上折线看各 Web 服务器的请求量,右上双轴折线对比内存与 CPU,左中柱状图给出前端加载耗时的分位值,右中折线看登录数,底部折线看流量进出。 Grafana 仪表盘(示例) server requests 折线 · 请求量 Memory / CPU 双轴折线 client side full page load 柱状 · 分位耗时 logins 折线 · 登录数 Traffic In / Out 折线 · 流量 面板按时间轴展示指标与告警 按 diagram-design 重绘 查看原图 高质量的可视化系统很难构建。很难证明不使用像 Grafana 这样的现成解决方案是合理的。
第 4 步:总结
这是我们的最终设计:
最终设计 把前面的选择拼在一起:指标源 → 采集器 → Kafka → 消费者 → 时序库;查询服务封装读写并挂一层缓存,向上服务告警系统与可视化系统;告警管理器读规则、写状态、发布到 Kafka,由消费者投递到各通道。 查询服务与缓存 指标源 指标采集器 Kafka 排队缓冲 消费者 流处理 时序数据库 查询服务 查询接口 告警系统 规则与去重 缓存 缓存最近查询 可视化系统 仪表盘 邮件 短信 PagerDuty HTTPS 回调 发送查询 读写缓存 发送查询 采集与处理解耦;查询服务 + 缓存支撑告警与可视化 按 diagram-design 重绘 查看原图
第 21 章:广告点击事件聚合
引言
数字广告 是一个巨大的行业,随着 Facebook、YouTube、TikTok 等的兴起而发展。
因此,跟踪广告点击事件非常重要。在本章中,我们探讨如何在 Facebook/Google 规模下设计一个广告点击事件聚合 系统。
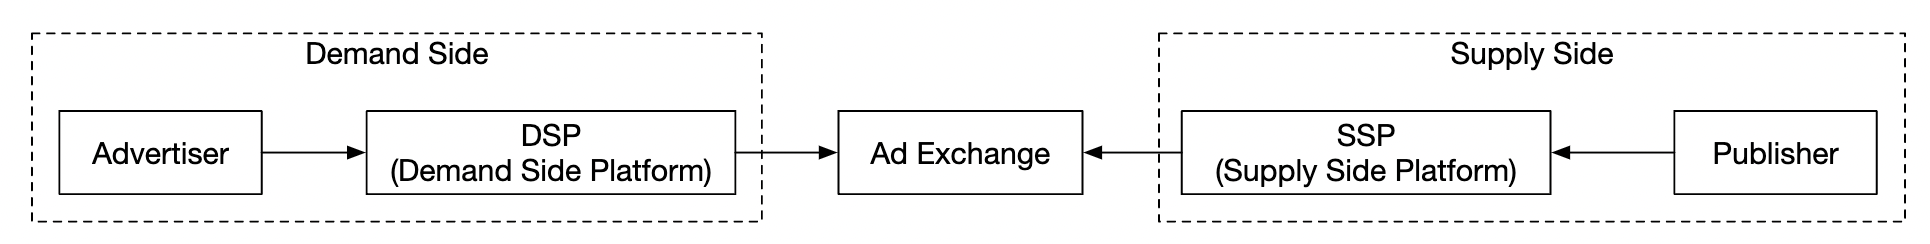
数字广告有一种称为**实时竞价(RTB)**的流程,数字广告库存通过它进行买卖:
实时竞价(RTB)生态 广告主经需求方平台(DSP)出价,发布商经供给方平台(SSP)提供广告位,双方在广告交易平台(Ad Exchange)上撮合。整条链路通常在一秒内完成,且计费依赖点击数据的准确性。 需求侧 供给侧 广告主 DSP 需求方平台 Ad Exchange SSP 供给方平台 发布商 竞价请求 广告位请求 RTB 在 1 秒内完成撮合 点击数据准确性直接影响计费 按 diagram-design 重绘 查看原图 RTB 的速度很重要,因为它通常在一秒内完成。
数据准确性也非常重要,因为它影响广告主支付多少钱。
基于广告点击事件聚合,广告主可以做出决策,例如调整目标受众和关键词。
第 1 步:理解问题并确定设计范围
C:输入数据的格式是什么?
I:每天 10 亿次广告点击,总共 200 万个广告。广告点击事件数量同比增长 30%。
C:我们的系统需要支持哪些最重要的查询?
I:需要考虑的主要查询:
返回广告 X 在过去 Y 分钟内的点击事件数量
返回过去 1 分钟点击次数最多的前 100 个广告。两个参数都应可配置。聚合每分钟进行一次。
支持对上述查询按 ip、user_id、country 进行数据过滤
C:我们需要担心边界情况吗?我能想到的一些:
可能有事件晚于预期到达
可能存在重复事件
系统的不同部分可能宕机,因此我们需要考虑系统恢复
I:这个清单很好,请考虑这些情况
C:延迟要求是什么?
I:广告点击聚合的端到端延迟为几分钟。RTB 则小于一秒。广告点击聚合可以接受这种延迟,因为它通常用于计费和报表。
功能需求
聚合 ad_id 在过去 Y 分钟内的点击次数
每分钟返回点击次数最多的前 100 个 ad_id
支持按不同属性进行聚合过滤
数据集规模达到 Facebook 或 Google 级别
非功能需求
聚合结果的正确性很重要,因为它用于 RTB 和广告计费
正确处理延迟或重复事件
健壮性——系统应能抵抗部分故障
延迟——端到端延迟最多几分钟
粗略估算
10 亿 DAU
假设每个用户每天点击 1 个广告 → 每天 10 亿次广告点击
广告点击 QPS = 10,000
峰值 QPS 为该数值的 5 倍 = 50,000
单次广告点击占用 0.1KB 存储。每日存储需求为 100gb
每月存储 = 3tb
第 2 步:提出高层设计并获得认可
在本节中,我们讨论查询 API 设计、数据模型和高层设计。
查询 API 设计 API 是客户端与服务器之间的契约。在我们的场景中,客户端是仪表盘用户——数据科学家/分析师、广告主等。
以下是我们的功能需求:
聚合 ad_id 在过去 Y 分钟内的点击次数
返回过去 M 分钟内点击次数最多的前 N 个 ad_id
支持按不同属性进行聚合过滤
我们需要两个端点来满足这些需求。过滤可以通过其中一个端点的查询参数完成。
聚合 ad_id 在过去 M 分钟内的点击次数 :
GET /v1/ads/{:ad_id}/aggregated_count
查询参数:
from - 开始分钟。默认为 now - 1 min
to - 结束分钟。默认为 now
filter - 不同过滤策略的标识符。例如 001 表示“非美国点击”。
响应:
ad_id - 广告标识符
count - 开始分钟和结束分钟之间的聚合计数
返回过去 M 分钟内点击次数最多的前 N 个 ad_id
GET /v1/ads/popular_ads
查询参数:
count - 点击次数最多的前 N 个广告
window - 聚合窗口大小(以分钟为单位)
filter - 不同过滤策略的标识符
响应:
数据模型 在我们的系统中,有原始数据和聚合数据。
原始数据如下所示:
[AdClickEvent] ad001, 2021-01-01 00:00:01, user 1, 207.148.22.22, USA
以下是结构化格式的示例:
广告ID
点击时间戳
用户
IP
国家
ad001
2021-01-01 00:00:01
user1
207.148.22.22
USA
ad001
2021-01-01 00:00:02
user1
207.148.22.22
USA
ad002
2021-01-01 00:00:02
user2
209.153.56.11
USA
以下是聚合版本:
广告ID
点击分钟
过滤ID
计数
ad001
202101010000
0012
2
ad001
202101010000
0023
3
ad001
202101010001
0012
1
ad001
202101010001
0023
6
filter_id 帮助我们实现过滤需求。
过滤ID
地区
IP
用户ID
0012
US
*
*
0013
*
123.1.2.3
*
为支持快速返回过去 M 分钟内点击次数最多的前 N 个广告,我们还会维护以下结构:
most_clicked_ads
window_size
integer
聚合窗口大小(M,以分钟为单位)
update_time_minute
timestamp
最后更新的时间戳(1 分钟粒度)
most_clicked_ads
array
JSON 格式的广告 ID 列表。
存储原始数据和存储聚合数据各有什么优缺点?
原始数据允许使用完整数据集,并支持数据过滤和重新计算
另一方面,聚合数据使数据集更小、查询更快
原始数据意味着更大的数据存储和更慢的查询
然而,聚合数据是派生数据,因此会有一些数据损失。
在我们的设计中,我们会结合使用这两种方法:
保留原始数据用于调试是个好主意。如果聚合中有错误,我们可以发现错误并回填。
聚合数据也应存储,以获得更快的查询性能。
原始数据可以存储在冷存储中,以避免额外的存储成本。
在数据库方面,需要考虑几个因素:
数据是什么样子?是关系型、文档型还是 blob?
工作负载是读密集、写密集还是两者兼有?
需要事务吗?
查询是否依赖 SUM、COUNT 等 OLAP 函数?
对于原始数据,我们可以看到平均 QPS 为 10k,峰值 QPS 为 50k,因此系统是写密集的。
另一方面,读流量很低,因为原始数据主要用作故障时的备份。
关系型数据库可以完成这项工作,但扩展写入可能具有挑战性。
或者,我们可以使用 Cassandra 或 InfluxDB,它们对重度写入负载有更好的原生支持。
另一种选择是使用 Amazon S3 配合 ORC、Parquet 或 AVRO 等列式数据格式。由于这种方案不太熟悉,我们将继续使用 Cassandra。
对于聚合数据,工作负载既读密集又写密集,因为仪表盘和告警会不断查询聚合数据。
它也是写密集的,因为聚合服务每分钟都会聚合并写入数据。
因此,这里我们也会使用相同的数据库(Cassandra)。
高层设计 我们的系统如下所示:
高层设计:同步链路 日志采集器把点击事件推给数据聚合服务,服务每分钟算出「ad 点击计数」和「Top 100 广告」写入数据库;查询服务(仪表盘)再从数据库读聚合结果。数据在输入和输出两端都是无界流。 日志采集器 数据聚合服务 数据库 查询服务 推送数据 点击计数 Top 100 广告 查询 输入 处理 输出 展示 按 diagram-design 重绘 查看原图 数据在输入和输出端都以无界数据流的形式流动。
为了避免同步接收端导致消费者崩溃时整个系统停滞,我们将利用消息队列(Kafka)进行异步处理,以解耦消费者和生产者。
高层设计:异步解耦 为避开同步 sink(消费者崩溃会拖垮全链路),用两条 Kafka 队列解耦:第一条存原始点击事件,分发给聚合服务和数据库写入器落原始库;第二条存每分钟的聚合结果,由数据库写入器落聚合库,供查询服务读取。 日志采集器 消息队列 数据聚合服务 消息队列 数据库写入器 原始数据库 数据库写入器 聚合数据库 查询服务 点击计数 Top 100 广告 拉取结果 查询结果 按 diagram-design 重绘 查看原图 第一条消息队列存储广告点击事件数据:
第二条消息队列包含按分钟聚合的广告点击计数:
以及按分钟聚合的点击次数最多的前 N 个广告:
update_time_minute
most_clicked_ads
第二条消息队列用于实现端到端的 exactly-once 原子提交语义:
第二条队列与原子提交 第二条消息队列存在的意义,是把「写聚合结果」和「提交消费 offset」放进同一个原子提交里:要么两者都成功,要么都回滚,从而达成端到端的 exactly-once 语义。 原子提交范围 日志采集器 消息队列 数据聚合服务 消息队列 数据库写入器 原始数据库 数据库写入器 聚合数据库 查询服务 点击计数 Top 100 广告 拉取结果 查询结果 按 diagram-design 重绘 查看原图 对于聚合服务,使用 MapReduce 框架是一个不错的选择:
MapReduce:点击计数 聚合服务按 MapReduce 组织:Map 节点读入数据后分流给多个 Aggregate 节点,每个节点每分钟独立汇总自己那份 ad 的点击次数,各自输出一份点击计数。 聚合服务 数据输入 Map Aggregate Aggregate 点击计数 每分钟 点击计数 每分钟 数据输入 点击计数 点击计数 每分钟聚合一次 按 diagram-design 重绘 查看原图
MapReduce:Top 100 算 Top 100 时链路更长:Map 分流给多个 Aggregate,各节点汇总后把结果交给 Reduce,Reduce 归并所有分片算出全局 Top 100 广告。 聚合服务 数据输入 Map Aggregate Aggregate Reduce Top 100 广告 数据输入 Top 100 广告 Top 100 聚合 按 diagram-design 重绘 查看原图 每个节点负责一个单一任务,并将处理结果发送给下游节点。
Map 节点负责从数据源读取数据,然后过滤和转换数据。
例如,map 节点可以根据 ad_id 在不同聚合节点之间分配数据:
Map 节点按 ad_id 分流 Map 节点读入数据后按 ad_id 取模决定去向:ad_id % 2 = 0 的事件交给聚合节点 1,ad_id % 2 = 1 的交给聚合节点 2。这样同一广告的事件一定落到同一节点。 数据输入 Map 聚合节点 1 聚合节点 2 数据输入 ad_id % 2 = 0 ad_id % 2 = 1 按 diagram-design 重绘 查看原图 或者,我们可以将广告分布到 Kafka 分区,并让聚合节点在消费者组中直接订阅。
但是,映射节点使我们能够在后续处理之前清理或转换数据。
另一个原因可能是我们无法控制数据的产生方式,因此与同一个 ad_id 相关的事件可能进入不同的分区。
聚合节点每分钟在内存中按 ad_id 统计广告点击事件。
Reduce 节点收集聚合节点的聚合结果并产生最终结果:
Reduce 节点归并 Top 3 三个 Aggregate 节点各自维护一份 ad → 点击数的局部 Top 3,Reduce 节点把它们归并成全局结果。示例中最近一分钟点击最多的三支广告是 ad1、ad7 和 ad13。 ad1: 12 ad3: 5 · ad2: 3 ad7: 9 ad10: 4 · ad8: 3 ad13: 8 ad11: 4 · ad15: 3 Reduce 取 Top 3 Top 3 广告 ad1 · ad7 · ad13 合并 任务:取 Top 3 按 diagram-design 重绘 查看原图 这个 DAG 模型使用 MapReduce 范式。它获取大数据,并利用并行分布式计算将其转换为常规规模的数据。
在 DAG 模型中,中间数据存储在内存中,不同节点之间通过 TCP 或共享内存进行通信。
现在我们来探讨这个模型如何帮助我们实现各种用例。
用例 1 - 聚合点击次数 :
用例 1:按 ad_id 聚合点击 全部事件先经 Map 按 ad_id 分组,同一广告的事件落到同一聚合节点;各节点在内存里按分钟累计,输出该广告在过去一分钟内的点击次数。 全部事件 Map 按 ad_id 分组 聚合 ad3 点击 4 次 聚合 ad1 点击 3 次 聚合 ad2 点击 5 次 事件流 同一 ad_id 的事件分到同一聚合节点 按 diagram-design 重绘 查看原图
用例 2 - 返回点击次数最多的前 N 个广告 :
用例 2:Top N 点击广告 Top N 的链路多一层 Reduce:Map 把事件分成若干组交给 Aggregate,每个节点维护一个堆以快速取出局部 Top 3,Reduce 再归并出全局 Top 3;把 3 换成 N 即可扩展到 Top N。 全部事件 Map 按 ad_id 分组 聚合组 1 ad3 · ad6 · ad9 聚合组 2 ad1 · ad4 · ad7 聚合组 3 ad2 · ad5 · ad8 Reduce 取 Top 3 Top 3 广告 ad3 · ad1 · ad2 事件流 Top 3 广告 按 diagram-design 重绘 查看原图
在这个例子中,我们聚合的是前 3 个广告,但这可以轻松扩展到前 N 个广告
每个节点维护一个堆数据结构,以便快速检索前 N 个广告
用例 3 - 数据过滤 :
为支持快速数据过滤,我们可以预定义过滤条件并基于它们进行预聚合:
广告ID
点击分钟
国家
计数
ad001
202101010001
USA
100
ad001
202101010001
GPB
200
ad001
202101010001
其他
3000
ad002
202101010001
USA
10
ad002
202101010001
GPB
25
ad002
202101010001
其他
12
这种技术称为星型模式 ,在数据仓库中被广泛使用。
过滤字段称为维度 。
这种方法有以下优点:
简单易懂且易于构建
可以复用当前聚合服务在星型模式中创建更多维度
基于过滤条件访问数据很快,因为结果已预先计算
这种方法的一个限制是,它会产生更多的桶和记录,尤其是在过滤条件很多时。
第 3 步:设计深入探讨
让我们深入探讨一些更有趣的话题。
流处理 vs. 批处理 我们提出的高层架构是一种流处理系统。
以下是三种系统类型的比较:
服务(在线系统)
批处理系统(离线系统)
流处理系统(近实时系统)
响应性
快速响应客户端
不需要响应客户端
不需要响应客户端
输入
用户请求
有限大小的有界输入。数据量大
输入无边界(无限流)
输出
对客户端的响应
物化视图、聚合指标等。
物化视图、聚合指标等。
性能度量
可用性、延迟
吞吐量
吞吐量、延迟
示例
网上购物
MapReduce
Flink [13]
在我们的设计中,我们混合使用了批处理和流处理。
我们使用流处理来在数据到达时进行处理,并近实时地生成聚合结果。
另一方面,我们使用批处理进行历史数据备份。
同时包含批处理和流处理两条处理路径的系统,这种架构称为 Lambda。
缺点是,你有两条处理路径和两套需要维护的代码库。
Kappa 是另一种架构,它将批处理和流处理合并到一条处理路径中。
其核心思想是使用单一的流处理引擎。
Lambda 架构:
Lambda 架构 Lambda 同时保留两条处理路径:事件既进批处理层由批处理引擎离线计算,也进流处理层由实时引擎近实时计算,两者结果汇总到服务后端供查询;代价是两套代码库要各自维护。 批处理层 流处理层 服务层 数据存储 事件源 消息队列 批处理引擎 流处理引擎 服务后端 查询 原始数据 结果数据 事件 查询 按 diagram-design 重绘 查看原图 Kappa 架构:
Kappa 架构 Kappa 把批与流合并成单一路径:事件只经流处理引擎近实时计算,结果直接进服务后端。历史数据重算也走同一个流处理引擎,因此只需维护一套代码——本章的高层设计即采用 Kappa。 流处理层 服务层 数据存储 事件源 消息队列 流处理引擎 服务后端 查询 原始数据 结果数据 事件 分区 查询 按 diagram-design 重绘 查看原图 我们的高层设计使用 Kappa 架构,因为历史数据的重新处理也会经过聚合服务。
当由于例如聚合逻辑中的重大错误而必须重新计算聚合数据时,我们可以从存储的原始数据中重新计算聚合。
重新计算服务从原始存储中检索数据。这是一个批处理作业。
检索到的数据被发送到专用的聚合服务,以免影响实时处理聚合服务。
聚合结果被发送到第二个消息队列,之后我们更新聚合数据库中的结果。
历史数据重算 当聚合逻辑出现重大 bug 需要重算时:重算服务①从原始库读出全量事件(批作业),②交给一个只做重算的聚合服务,③把结果写回第二条消息队列,再落聚合库。专用服务隔离了重算,避免影响实时链路。 日志采集器 消息队列 数据聚合服务 每分钟 消息队列 数据库写入器 数据库写入器 原始数据库 数据聚合服务 仅重算 重算服务 聚合数据库 查询服务 ③ 写入 ① 读取 ② 重算 查询 批作业:从原始库重算聚合结果 按 diagram-design 重绘 查看原图 时间 我们需要一个时间戳来执行聚合。它可以在两个地方生成:
事件时间——广告点击发生的时间
处理时间——服务器处理事件时的系统时间
由于使用异步处理(消息队列)和网络延迟,事件时间和处理时间之间可能存在显著差异。
如果使用处理时间,聚合结果可能不准确
如果使用事件时间,我们必须处理延迟事件
没有完美的解决方案,我们需要考虑权衡:
优点
缺点
事件时间
聚合结果更准确
客户端时间可能错误,或者时间戳可能由恶意用户生成
处理时间
服务器时间戳更可靠
如果事件延迟,时间戳就不准确
由于数据准确性很重要,我们将使用事件时间进行聚合。
为了缓解延迟事件的问题,可以利用一种称为“水印”的技术。
在下面的例子中,事件 2 错过了它需要被聚合的窗口:
延迟事件漏出窗口 用事件时间做聚合时,事件时间与处理时间因异步和网络延迟而错位。事件 2 的事件时间落在窗口 1 内,但处理时间 85 秒已晚于窗口 1 关闭的 60 秒,于是被漏掉。 1 2 3 4 5 1 2 3 4 5 窗口 1 含事件 1 窗口 2 含事件 3 窗口 3 含事件 4 事件时间 处理时间 0 30 60 90 120 150 180 秒 事件 2 处理时间 85 秒 > 窗口 1 关闭的 60 秒 → 漏聚合 按 diagram-design 重绘 查看原图 然而,如果我们有意识地扩展聚合窗口,就可以减少事件被遗漏的可能性。
窗口的扩展部分称为“水印”:
扩展窗口:水位线 把窗口故意延长一段,这段延长就是「水位线」。窗口 1 加上水位线后覆盖到事件 2 的处理时间,漏聚合被补回。水位线越短漏事件越多但延迟越低,越长越不容易漏但延迟越高。 1 2 3 4 5 1 2 3 4 5 窗口 1 含事件 1 水位线 窗口 2 含事件 3 水位线 窗口 3 含事件 4 水位线 事件时间 处理时间 0 30 60 90 120 150 180 秒 延长部分即水位线;越短漏事件越多但延迟越低 按 diagram-design 重绘 查看原图
较短的水印会增加遗漏事件的可能性,但会降低延迟
较长的水印会减少遗漏事件的可能性,但会增加延迟
无论水印大小如何,总有遗漏事件的可能性。但是为这种低概率事件进行优化没有意义。
我们可以改为通过日终对账来解决这种不一致。
聚合窗口 窗口函数有四种类型:
在我们的设计中,我们使用滚动窗口进行广告点击聚合:
翻滚窗口(1 分钟) 翻滚窗口把时间切成固定长度、互不重叠的段,本章用它做点击计数:每 1 分钟一段,段内累加点击次数,段结束时输出该分钟的计数。 聚合点击 第 1 分钟 聚合点击 第 2 分钟 聚合点击 第 3 分钟 聚合点击 第 4 分钟 翻滚窗口(1 分钟窗口) 1 2 3 4 5 分钟 按 diagram-design 重绘 查看原图 同时使用滑动窗口进行过去 M 分钟内点击次数最多的前 N 个广告的聚合:
滑动窗口(3 分钟) 滑动窗口长度固定但相邻窗口重叠,本章用它算「最近 M 分钟 Top N 广告」:窗口长 3 分钟、每分钟滑动一次,于是每 1 分钟就产出一份覆盖过去 3 分钟的 Top 广告。 最近 3 分钟 Top 广告 每分钟运行 最近 3 分钟 Top 广告 每分钟运行 滑动窗口(3 分钟) 1 2 3 4 5 分钟 按 diagram-design 重绘 查看原图 投递保证 由于我们聚合的数据将用于计费,数据准确性是首要任务。
因此,我们需要讨论:
我们可以使用三种投递保证:at-most-once、at-least-once 和 exactly once。
在大多数情况下,当少量重复可接受时,at-least-once 就足够了。
但我们的系统不是这种情况,因为哪怕很小的百分比差异都可能导致数百万美元的偏差。
因此,我们需要使用 exactly-once 投递语义。
数据去重 最常见的数据质量问题之一是重复数据。
它可能来自多种来源:
客户端——客户端可能多次重新发送同一事件。带有恶意意图的重复事件最好由风险引擎处理。
服务器宕机——聚合服务节点在聚合过程中宕机,上游服务未收到确认,因此事件被重新发送。
以下是由于最后一跳未能确认事件而导致数据重复的示例:
数据重复:确认前失败 上游 Kafka 消费到 offset 100 的事件交给聚合器,聚合器算完把结果发给下游,等下游确认后再回执上游。若在最后一步回执前崩溃,上游没收到确认就会从 offset 100 重新消费,同一批数据被重复处理。 上游 Kafka offset 100 聚合器 下游 Kafka 聚合状态 offset 110 ① 消费 ② 聚合 ③ 发送 步骤 6 回执前失败 → offset 100 被重复消费 按 diagram-design 重绘 查看原图 在这个例子中,偏移量 100 将被多次处理并发送到下游。
尝试缓解此问题的一种方法是将最后看到的偏移量存储在 HDFS/S3 中,但这可能导致结果永远无法到达下游:
存 offset 到 HDFS/S3 一种缓解做法是把已消费的 offset 存到 HDFS/S3:聚合器先校验并保存 offset,再聚合、再发送结果。但「保存 offset」与「发送结果」不是原子的,若保存后崩溃,消息就可能永远到不了下游。 上游 Kafka offset 100 聚合器 HDFS / S3 存 offset 下游 Kafka ① 消费 ③ 校验 保存 offset ④ 发送结果 先存 offset 再发送 → 崩溃则丢消息 按 diagram-design 重绘 查看原图 最后,我们可以在与下游交互时原子地存储偏移量。为了实现这一点,我们需要实现分布式事务:
分布式事务保证原子性 彻底的做法是「存 offset」与「发送结果」放进同一个分布式事务:校验 offset、聚合、发送结果、保存 offset、下游回执要么整体成功要么整体失败,从而避免重复与丢失。 分布式事务 上游 Kafka offset 100 聚合器 HDFS / S3 存 offset 下游 Kafka ① 消费 ③ 校验 保存 offset ④ 发送结果 存 offset 与发送结果同一事务 按 diagram-design 重绘 查看原图 个人旁注 :或者,如果下游系统幂等地处理聚合结果,就不需要分布式事务。
扩展系统 让我们讨论系统增长时如何扩展。
我们有三个独立组件——消息队列、聚合服务和数据库。
由于它们是解耦的,我们可以独立扩展它们。
如何扩展消息队列:
我们对生产者数量不设限制,因此它们可以轻松扩展
可以通过将消费者分配到消费者组并增加消费者数量来扩展消费者
为了实现这一点,我们还需要确保预先创建了足够的分区
此外,当有数千个消费者时,消费者再平衡可能需要一段时间,因此建议在非高峰时段进行
我们还可以考虑按地理位置对主题进行分区,例如 topic_na、topic_eu 等
消费者组扩容 消息队列靠消费者组水平扩展:把消费者加进同一个组,Kafka 会重平衡把分区重新分配。扩容前 4 个分区由 2 个消费者分担,扩容后每个消费者各拿一个分区;前提是提前建好足够的分区。 扩展前:2 个消费者 扩展后:4 个消费者 分区 0 分区 1 分区 2 分区 3 消费者 0 消费者 1 分区 0 分区 1 分区 2 分区 3 消费者 0 消费者 1 消费者 2 消费者 3 重平衡 按 diagram-design 重绘 查看原图 如何扩展聚合服务:
聚合服务水平扩展 聚合服务由多个服务节点组成,每个节点各跑一个 Map 进程和一个 Reduce 进程。加节点即可提升吞吐;Map 输出按 ad_id 重分区(shuffle)后交叉送到各 Reduce 节点,再汇成最终聚合结果。 聚合服务(水平扩展) Kafka Map 进程 Map 进程 Map 进程 Reduce 进程 Reduce 进程 Reduce 进程 聚合结果 Map 输出按 ad_id 重分区 shuffle 到各 Reduce 节点 按 diagram-design 重绘 查看原图
通过添加更多节点,可以轻松扩展 MapReduce 节点
聚合服务的吞吐量可以通过利用多线程来扩展
或者,我们可以利用 Apache YARN 等资源提供者来实现多进程
方案 1 更简单,但方案 2 在实践中使用更广泛,因为其可扩展性更好
以下是多线程示例:
聚合服务多线程 提升单节点吞吐的另一种办法是多线程:Kafka 的事件按 ad_id 区间拆给不同服务节点,节点内再把各 ad_id 分给不同线程并行聚合,线程之间互不干扰。 聚合服务节点 1 聚合服务节点 2 Kafka 事件分组 ad_id 1–3 事件 事件分组 ad_id 4–6 事件 线程 1 ad_id = 1 线程 2 ad_id = 2 线程 3 ad_id = 3 线程 1 ad_id = 4 线程 2 ad_id = 5 线程 3 ad_id = 6 分区 按 diagram-design 重绘 查看原图 如何扩展数据库:
如果我们使用 Cassandra,它原生支持使用一致性哈希进行水平扩展
如果向集群添加新节点,数据会自动在所有(虚拟)节点间重新平衡
使用这种方法,不需要手动(重新)分片
Cassandra 一致性哈希扩展 Cassandra 用一致性哈希水平扩展:节点加入或离开时,数据只在相邻节点间自动重平衡,无需手工分片。只用单 token 时负载容易不均;引入虚拟节点(每个物理节点持有多个 token)后,负载被摊得更平。 哈希环(无虚拟节点) 哈希环(有虚拟节点) 节点 A 节点 B 节点 C 节点 D 节点 E 节点 F 节点 1 节点 2 节点 3 节点 4 节点 5 节点 6 新增节点自动重平衡,无需手工分片 按 diagram-design 重绘 查看原图 另一个需要考虑的可扩展性问题是热点问题——如果某个广告比其他广告更受欢迎、获得更多关注怎么办?
热点广告与资源申请 若某支广告点击远超其他(热点),对应聚合节点会过载。它可向资源管理器申请额外资源,拿到资源后把 300 个事件拆成 3 组各处理 100 个,再把结果写回原节点,避免单点被压垮。 数据输入 Map 热点聚合节点 ad1 300 事件 Reduce 聚合输出 资源管理器 热点事件 输出 ① 申请资源 ② 分配资源 热点:单支广告点击远超其他 申请资源后拆成 3 组,各处理 100 个事件 按 diagram-design 重绘 查看原图
在上面的例子中,聚合服务节点可以通过资源管理器申请额外资源
资源管理器分配更多资源,以免原始节点过载
原始节点将事件分成 3 组,每个聚合节点处理 100 个事件
结果写回原始聚合节点
处理热点问题的其他更复杂的方法:
容错 在聚合节点内,我们在内存中处理数据。如果某个节点宕机,已处理的数据就会丢失。
我们可以利用 Kafka 中的消费者偏移量,在另一个节点接替工作后从上次离开的位置继续。
然而,由于我们要聚合过去 M 分钟内点击次数最多的前 N 个广告,我们还需要维护额外的中间状态。
我们可以为正在进行的聚合在特定分钟制作快照:
容错:周期性快照 聚合在内存中完成,节点崩溃会丢数据。除了 Kafka offset,还需为「最近 M 分钟 Top N」这类中间状态定期打快照:按分钟记录每支广告在各分钟的点击数,恢复时据此重建。 快照:最近 5 分钟 Top 3 消息队列 数据聚合服务 ad1: 12 1 3 2 3 3 ad3: 5 1 1 3 0 0 ad2: 3 0 2 0 1 0 每分钟为进行中的聚合打快照 横轴:分钟 1 2 3 4 5 按 diagram-design 重绘 查看原图 如果节点宕机,新节点可以读取最新提交的消费者偏移量以及最新快照来继续工作:
故障恢复:接棒继续 主聚合节点故障后,新节点接手:它读取最新提交的消费 offset,再从快照存储拉取最近一次增量快照,据此重建中间状态并继续聚合,无需从头重算。 外部节点 主聚合节点 快照存储 新聚合节点 增量快照 拉取快照 ✗ 主节点故障 节点停止服务 按 diagram-design 重绘 查看原图 数据监控与正确性 由于我们聚合的数据对计费至关重要,因此必须有严格的监控来确保正确性。
我们可能需要监控的一些指标:
延迟 :可以跟踪不同事件的时间戳,以了解系统的端到端延迟消息队列大小 :如果队列大小突然增加,我们需要添加更多聚合节点。由于 Kafka 是通过分布式提交日志实现的,我们需要改为跟踪 records-lag 指标。聚合节点的系统资源 :CPU、磁盘、JVM 等。
我们还需要实现一个对账流程,它是一个批处理作业,在每天结束时运行。
它从原始数据计算聚合结果,并将其与聚合数据库中存储的实际数据进行比较:
每日对账流程 水位线再长也仍可能漏掉极少数事件,可用日终对账兜底:批作业从原始库重算聚合结果,与线上聚合库比对,差异写进差异报告交人工复核,必要时回补。 消息队列 数据聚合服务 聚合数据库 线上结果 原始数据库 全量事件 对账任务 每日批处理 差异报告 事件 聚合结果 存原始 读原始 比对 差异 按 diagram-design 重绘 查看原图 替代设计 在通用系统设计面试中,不期望你了解大数据处理中使用的专用软件的内部细节。
解释思考过程并讨论权衡比了解具体工具更重要,这就是本章介绍通用解决方案的原因。
另一种利用现成工具的替代设计是,将广告点击数据存储在 Hive 中,并在其上构建 ElasticSearch 层以加快查询。
聚合通常在 ClickHouse 或 Druid 等 OLAP 数据库中进行。
替代设计:现成大数据组件 若不想自建,可用现成组件:点击数据经风控引擎后写入 Hive 做冷存,再建 ElasticSearch 层供数据科学家快速查询;聚合则交给 ClickHouse 等 OLAP 库,供商家侧分析。 日志采集器 消息队列 风控引擎 Hive ClickHouse ElasticSearch 商家分析 数据科学家 聚合查询 查询 按 diagram-design 重绘 查看原图 第 4 步:总结
我们涵盖的内容:
数据模型和 API 设计
使用 MapReduce 聚合广告点击事件
扩展消息队列、聚合服务和数据库
缓解热点问题
持续监控系统
使用对账确保正确性
容错
广告点击事件聚合是典型的大数据处理系统。
如果你事先了解相关技术,将更容易理解和设计它:
Apache Kafka
Apache Spark
Apache Flink
第 22 章:酒店预订系统
引言
在本章中,我们将设计一个酒店预订系统 ,类似于万豪国际。
同样适用于其他类型的系统——Airbnb、机票预订、电影票预订。
第 1 步:理解问题并确定设计范围
在深入设计之前,我们应该向面试官提出一些问题来明确范围:
C:系统规模有多大?
I:我们正在为一个拥有 5000 家酒店和 1mil 间客房的连锁酒店构建网站。
C:顾客是在预订时付款,还是到店时付款?
I:他们在预订时全额付款。
C:顾客只能通过网站预订酒店房间吗?我们是否需要支持电话等其他预订方式?
I:他们只通过网站或应用预订。
C:顾客可以取消预订吗?
I:可以。
C:还有其他需要考虑的方面吗?
I:是的,我们允许 10% 的超售。酒店会卖出比实际房间数更多的房间。酒店这样做是因为预期会有客户取消预订。
C:由于时间不多,我们将重点放在:展示酒店相关页面、酒店房间详情页、预订房间、管理后台、支持超售。
I:听起来不错。
I:还有一点——酒店价格一直在变动。假设酒店房间的价格每天都在变化。
C:好的。
非功能性需求
支持高并发——旺季可能有很多客户尝试预订同一家酒店。
中等延迟——理想情况下用户预订时应有低延迟,但如果系统需要几秒钟处理,也是可以接受的。
粗略估算
总共 5000 家酒店,1mil 间客房
假设 70% 的房间被占用,平均入住时长为 3 天
预计每日预订数:1mil * 0.7 / 3 = 约 240k 单/天
每秒预订数:240k / 一天 10^5 秒 = 约 3。平均预订 TPS 很低。
我们来估算 QPS。如果我们假设到达预订页需要三步,并且每页转化率为 10%,那么可以估算:如果有 3 次预订,则预订页必须有 30 次浏览,酒店房间详情页有 300 次浏览。
QPS 估算:三步漏斗 预订要经过三步,每步约 10% 的转化率。若每天约 3 笔预订,反推上去:预订页 QPS≈30,酒店 / 房型详情页 QPS≈300。读多写少,且真正的写只有最后一步。 浏览酒店 / 房型详情 QPS = 300 进入预订页 QPS = 30 完成预订 QPS = 3 转化 10% 转化 10% 每步约 10% 转化率,逐层收窄 按 diagram-design 重绘 查看原图 第 2 步:提出高层次设计并获得认可
我们将探讨:API 设计、数据模型和高层次设计。
API 设计 本 API 设计重点介绍支撑酒店预订系统所需的核心端点(遵循 RESTful 实践)。
一个完整的系统需要更广泛的 API,以支持按多种条件搜索房间,但本节不会关注这些。原因是它们在技术上没有太大挑战,因此不在范围内。
酒店相关 API
GET /v1/hotels/{id} - 获取酒店的详细信息。POST /v1/hotels - 新增酒店。仅限运营人员使用。PUT /v1/hotels/{id} - 更新酒店信息。仅限运营人员使用。DELETE /v1/hotels/{id} - 删除酒店。该 API 仅限运营人员使用。
房间相关 API
GET /v1/hotels/{id}/rooms/{id} - 获取房间的详细信息。POST /v1/hotels/{id}/rooms - 新增房间。仅限运营人员使用。PUT /v1/hotels/{id}/rooms/{id} - 更新房间信息。仅限运营人员使用。DELETE /v1/hotels/{id}/rooms/{id} - 删除房间。仅限运营人员使用。
预订相关 API
GET /v1/reservations - 获取当前用户的预订历史。GET /v1/reservations/{id} - 获取预订的详细信息。POST /v1/reservations - 创建新预订。DELETE /v1/reservations/{id} - 取消预订。
以下是一个创建预订的请求示例:
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomID":"U12354673389",
  "reservationID":"13422445"
}
请注意,reservationID 是避免重复预订的幂等键。详细说明见并发问题 。
数据模型 在选择数据库之前,我们先考虑访问模式。
我们需要支持以下查询:
查看酒店详细信息
在给定日期范围内查找可用的房型
记录预订
查找预订或历史预订记录
从估算中我们知道系统规模不大,但需要为流量高峰做好准备。
鉴于这一点,我们选择关系型数据库,原因如下:
关系型数据库适用于读多写少的系统。
NoSQL 数据库通常针对写入进行优化,但我们知道写入并不多,因为只有一小部分访问网站的用户会进行预订。
关系型数据库提供 ACID 保证。这对这类系统很重要,因为没有这些保证,我们无法防止负余额、重复扣款等问题。
关系型数据库可以轻松建模数据,因为结构非常清晰。
以下是我们的模式设计:
初始表结构(按具体房间预订) 按服务切分关系库:酒店服务管 hotel / room,费率服务管 room_type_rate,客人服务管 guest,预订服务管 reservation。reservation 里带 room_id,说明这条模型假设「预订一个具体房间」,适合 Airbnb 却不太贴合酒店「订房型、入住时才分房」的业务。 酒店服务 费率服务 客人服务 预订服务 hotel room room_type_rate guest reservation hotel_id PK name address location room_id PK room_type_id floor number hotel_id name is_available hotel_id PK date PK rate guest_id PK first_name last_name email reservation_id PK hotel_id room_id start_date end_date status guest_id 按 diagram-design 重绘 查看原图 大多数字段不言自明。唯一值得一提的是 status 字段,它表示给定房间的状态机:
订单状态机 status 字段是一台状态机:订单从「待支付」出发,支付成功进入「已支付」,超时未付或主动取消进入「已取消」,支付被拒进入「已拒绝」;只有「已支付」能再走到「已退款」。已取消 / 已拒绝 / 已退款都是终态。 待支付 已取消 已支付 已拒绝 已退款 取消 支付成功 拒付 退款 已取消 / 已拒绝 / 已退款为终态 按 diagram-design 重绘 查看原图 这种数据模型适用于像 Airbnb 这样的系统,但不适用于酒店;在酒店中,用户预订的不是特定房间,而是房型。他们预订一种房型,房间号在预订时选定。
这个不足将在改进的数据模型 一节中解决。
高层次设计 本设计选择微服务架构。近年来它已经非常流行:
高层设计:微服务架构 用户经 CDN 拿静态资源,预订请求走公有 API 网关(限流、鉴权),网关再分发到酒店、费率、预订、支付四个服务,各自带缓存或数据库;酒店数据静态、可激进缓存。运维人员走私有内网 API 到酒店管理服务。服务间用 gRPC 之类的 RPC 通信。 用户 预订 / 取消 CDN 运维 公有 API 网关 限流 / 鉴权 内网 API 酒店管理服务 酒店服务 费率服务 预订服务 支付服务 酒店缓存 静态缓存 酒店库 费率库 预订库 支付库 静态资源 预订 管理 调用 公有区走网关,私有区走内网 API 按 diagram-design 重绘 查看原图
用户 :通过手机或电脑预订酒店房间。管理员 :执行退款/取消支付等管理功能。CDN 内容分发网络 :缓存 JS bundle、图片、视频等静态资源。公共 API 网关 :支持限流、身份认证等的全托管服务。内部 API :仅对授权人员可见。通常受 VPN 保护。酒店服务 :提供酒店和房间的详细信息。酒店和房间数据是静态的,因此可以激进地缓存。房价服务 :提供未来不同日期的房价。该领域一个有意思的点是,价格取决于酒店在特定日期的入住情况。预订服务 :接收预订请求并预订酒店房间。同时跟踪房间库存。支付服务 :处理支付,并在成功后更新预订状态。酒店管理服务 :仅授权人员可用。允许对预订、酒店等进行管理和查看的某些管理功能。
服务间通信可以通过 RPC 框架(如 gRPC)进行。
第 3 步:设计深入探讨
让我们深入探讨:
改进的数据模型
并发问题
可扩展性
解决微服务中的数据不一致
改进的数据模型 如上一节所述,我们需要修改 API 和模式,以支持预订房型而不是特定房间。
对于预订 API,我们不再使用 roomID,而是使用 roomTypeID:
POST /v1/reservations
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomTypeID":"12354673389",
  "roomCount":"3",
  "reservationID":"13422445"
}
以下是更新后的模式:
改进后的表结构(按房型预订) 预订改为订「房型」而非具体房间:新增 room_type_inventory 表,按 (hotel_id, room_type_id, date) 一行一格记录 total_inventory 与 total_reserved,行由每日 CRON 预生成;reservation 的 hotel_id / room_type_id 变为外键。这样库存与预订同库,能借关系库的事务保证一致性。 酒店服务 费率服务 客人服务 预订服务 hotel room room_type_rate guest room_type_inventory reservation hotel_id PK name address location room_id PK room_type_id floor number hotel_id name is_available hotel_id PK date PK rate guest_id PK first_name last_name email hotel_id PK room_type_id PK date PK total_inventory total_reserved reservation_id PK hotel_id FK room_type_id FK start_date end_date status guest_id 按 diagram-design 重绘 查看原图
room :包含房间信息。room_type_rate :包含给定房型的价格信息。reservation :记录客人预订数据。room_type_inventory :存储酒店房间的库存数据。
让我们看看 room_type_inventory 表的列,因为这张表更有意思:
hotel_id :酒店 ID。room_type_id :房型 ID。date :单个日期。total_inventory :总库存——房间总数减去临时下架的库存。total_reserved :指定 (hotel_id, room_type_id, date) 的已预订房间总数。
设计这个表还有其他方法,但按 (hotel_id, room_type_id, date) 每天一行可以方便预订管理和查询。
表中的数据通过每日 CRON 作业预填充。
示例数据:
hotel_id
room_type_id
date
total_inventory
total_reserved
211
1001
2021-06-01
100
80
211
1001
2021-06-02
100
82
211
1001
2021-06-03
100
86
211
1001
...
...
211
1001
2023-05-31
100
0
211
1002
2021-06-01
200
16
2210
101
2021-06-01
30
23
2210
101
2021-06-02
30
25
以下是检查某房型可用性的 SQL 查询示例:
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}
如何使用该数据检查指定房间数的可用性(注意我们支持超售):
if (total_reserved + ${numberOfRoomsToReserve}) <= 110% * total_inventory
现在我们来估算一下存储量。
我们有 5000 家酒店。
每家酒店有 20 种房型。
5000 * 20 * 2(年)* 365(天)= 73mil 行
7300 万行数据并不算多,单台数据库服务器可以处理。但设置读复制(可能跨不同区域)以实现高可用性是有意义的。
后续问题——如果预订数据对单个数据库来说太大,该怎么办?
只存储当前和未来的预订数据。历史预订数据可以移到冷存储。
数据库分片——我们可以按 hash(hotel_id) % servers_cnt 对数据分片,因为查询中总是包含 hotel_id 条件。
并发问题 另一个需要解决的重要问题是重复预订。
需要解决两个问题:
同一用户点击“预订”两次
多个用户同时尝试预订同一房间
以下是第一个问题的可视化:
重复提交:同一用户点两次 用户手抖点了两次「预订」,前端发出两条一模一样的 INSERT,用的还是同一个 reservation_id,结果数据库里落下两行重复记录——这就是需要解决的第一个并发问题。 用户 INSERT 121 第 1 次 INSERT 121 第 2 次 两条重复记录 第 1 行 · 第 2 行 点击 点击 两次点击共用同一 reservation_id → 落下两行 按 diagram-design 重绘 查看原图 解决这个问题有两种方法:
客户端处理:前端可以在点击后禁用“预订”按钮。但如果用户禁用 JavaScript,就看不到按钮变灰。
幂等 API:在 API 中添加幂等键,使用户无论调用端点多少次,都只能执行一次操作:
幂等 API:同一 reservation_id 只生效一次 进入预订流程时先生成一个全局唯一的 reservation_id,之后每次提交都带上它。第一次提交正常落库;第二次提交时后端发现是重复的 reservation_id,直接拦下,动作只执行一次。 用户 ① 生成订单 生成全局唯一 ID ② 返回预订页 返回预订页 ③a 提交预订 提交预订 ③b 再次提交 再次提交 → 被拦下 预订服务 reservation_id reservation_id 全局唯一 → 重复提交被识别并拦下 按 diagram-design 重绘 查看原图 这个流程的工作方式如下:
当用户在填写信息并预订的过程中,会生成一个预订订单。该预订订单使用全局唯一标识符生成。
使用上一步生成的 reservation_id 提交预订 1。
如果再次点击“完成预订”,会发送相同的 reservation_id,后端会检测到这是重复预订。
通过给 reservation_id 列添加唯一约束来避免重复,防止多条具有该 id 的记录存储在数据库中。
唯一约束拦下重复写入 把 reservation_id 设成唯一约束:第一次 INSERT 成功落下一行;第二次带着同一个 id 再来时触发唯一约束冲突,写入被拒绝,库里仍只有一行。 用户 INSERT 121 第 1 次 INSERT 121 第 2 次 写入成功 写入成功 唯一约束冲突 唯一约束冲突 点击 点击 通过 冲突 同一 ID reservation_id 唯一 → 只留一行 按 diagram-design 重绘 查看原图 如果有多个用户进行相同的预订,该怎么办?
多用户并发:都读到有房 → 超卖 库存 100 / 已订 99,只剩 1 间。事务隔离级别非串行时,User 1 和 User 2 同时查库存,都看到「还有 1 间」,各自把 total_reserved 加 1 并提交,最终变成 101 / 100——超卖。 库存 100 / 99 · 剩 1 间 User 1 查库存 有房 User 2 查库存 有房 User 1 下单 已订 +1 User 2 下单 已订 +1 超卖 101 / 100 both commit 查库存 查库存 预订 预订 两个事务都读到 99 → 都提交 → 超卖 按 diagram-design 重绘 查看原图
假设事务隔离级别不是可串行化
用户 1 和用户 2 同时尝试预订同一房间。
事务 1 检查是否有足够房间——有。
事务 2 检查是否有足够房间——有。
事务 2 预订房间并更新库存。
事务 1 也预订了房间,因为它仍看到 100 间房中有 99 间 total_reserved。
两个事务都成功提交了更改。
这个问题可以通过某种锁机制解决:
以下是我们用于预订房间的 SQL:
# step 1: check room inventory
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}

# For every entry returned from step 1
if((total_reserved + ${numberOfRoomsToReserve}) > 110% * total_inventory) {
  Rollback
}

# step 2: reserve rooms
UPDATE room_type_inventory
SET total_reserved = total_reserved + ${numberOfRoomsToReserve}
WHERE room_type_id = ${roomTypeId}
AND date between ${startDate} and ${endDate}

Commit
方案 1:悲观锁
悲观锁通过在更新记录时对其加锁来防止同时更新。
在 MySQL 中可以通过 SELECT... FOR UPDATE 查询实现,它会锁定查询所选的行,直到事务提交。
方案一:悲观锁 悲观锁在更新期间直接锁住记录:事务 1 用 SELECT … FOR UPDATE 拿到行锁,直到提交才释放;事务 2 想查同一行只能排队等待,等事务 1 提交后它看到的已订数是 100、无房可订,只能回滚。串行化更新避免了冲突,但锁持有时长直接影响其他事务,伸缩性差。 事务 1 事务 2 BEGIN SELECT … FOR UPDATE 加锁 UPDATE 库存 COMMIT BEGIN SELECT … FOR UPDATE 等待锁 UPDATE 库存 已满 → 失败 ROLLBACK 等待 T1 事务 1 持锁到提交,事务 2 只能排队等待 按 diagram-design 重绘 查看原图 优点:
防止应用更新正在被其他事务修改的数据。
易于实现,通过串行化更新避免冲突。在数据争用严重时很有用。
缺点:
当锁定多个资源时可能出现死锁。
这种方法不可扩展——如果事务锁定时间过长,会影响所有尝试访问该资源的其他事务。
当查询选择大量资源且事务持续时间很长时,影响会非常严重。
由于其可扩展性问题,作者不推荐这种方法。
方案 2:乐观锁
乐观锁允许多个用户同时尝试更新同一条记录。
有两种常见实现方式:版本号和时间戳。推荐使用版本号,因为服务器时钟可能不准确。
方案二:乐观锁(版本号) 表里加一列 version:读记录时带上版本号,写回时把版本号 +1。左图顺序更新:User 1 读 v1 写 v2,User 2 再读 v2 写 v3,链条一致、无冲突。右图并发更新:User 1 和 User 2 都读到 v1,各自写回 v2,第二次写入发现版本没推进,判定冲突并回滚。 无冲突 冲突 v1 v2 v3 User 1 User 2 v1 v2 v2 写 v2 读 v2 写 v2 写 v2 ✓ 顺序更新:版本单调递增,无冲突 ✗ 并发写回同一版本 → 冲突回滚 按 diagram-design 重绘 查看原图
在数据库表中新增一个 version 列。
在用户修改数据库行之前,先读取版本号。
当用户更新该行时,版本号加 1 并写回数据库。
如果新版本号没有大于之前的版本号,数据库校验会阻止插入。
乐观锁通常比悲观锁快,因为我们不锁定数据库。然而,当并发很高时,它的性能往往会下降,因为会导致大量回滚。
优点:
防止应用编辑过期数据。
不需要在数据库中获取锁。
当数据争用较低,即更新冲突很少时,这是首选方案。
缺点:
乐观锁对我们系统是一个不错的选择,因为预订 QPS 不是特别高。
方案 3:数据库约束
这种方法与乐观锁非常相似,但通过数据库约束实现保护:
CONSTRAINT `check_room_count` CHECK((`total_inventory - total_reserved` >= 0))
方案三:数据库约束 思路和乐观锁相近,但把兜底交给数据库:加一条 CHECK 约束「total_inventory - total_reserved ≥ 0」。User 1 先提交、库存变 100 / 100;User 2 再想加 1 就会越界,约束直接拒绝这次写入。实现最简单,但数据竞争激烈时性能同样会下降。 库存 100 / 99 · 剩 1 间 User 1 查库存 有房 User 2 查库存 有房 User 1 下单 成功 User 2 下单 被拒 CHECK 约束 总量 - 已订 ≥ 0 查库存 查库存 预订 预订 越界写入被 CHECK 约束直接拒绝 按 diagram-design 重绘 查看原图 优点:
缺点:
与乐观锁类似,数据争用高时性能差。
数据库约束不能像应用代码那样方便地进行版本控制。
并非所有数据库都支持约束。
由于其易于实现,这是酒店预订系统的另一个不错选择。
可扩展性 通常,酒店预订系统的负载并不高。
然而,面试官可能会问,如果系统被更大、更热门的旅行网站(如 booking.com)采用,该如何处理。此时 QPS 可能高出 1000 倍。
在这种情况下,重要的是了解瓶颈在哪里。所有服务都是无状态的,因此可以通过复制轻松扩展。
然而,数据库是有状态的,如何扩展并不直观。
扩展数据库的一种方法是实现数据库分片——我们可以把数据拆分到多个数据库中,每个数据库只包含一部分数据。
我们可以基于 hotel_id 分片,因为所有查询都按它过滤。假设 QPS 为 30,000,将数据库分成 16 个分片后,每个分片处理 1875 QPS,这在一个 MySQL 集群的负载能力范围内。
数据库分片:按 hotel_id 路由 所有查询都带 hotel_id,所以用 hash(hotel_id) % 16 把数据切成 16 个分片,每个分片各持一部分数据。QPS 三万时分到 16 片,每片约 1875 QPS,落在单台 MySQL 集群的承受范围内。 预订服务 hotel_id % 16 分片路由 Shard 0 Shard 1 Shard 2 Shard 3 Shard 4 Shard 5 Shard 6 Shard 7 按 hotel_id 取模,共 16 个分片(图中示意 8 个) 按 diagram-design 重绘 查看原图 我们还可以通过 Redis 对房间库存和预订进行缓存。可以设置 TTL,让过期日期的旧数据自动失效。
库存缓存:查询走缓存,更新走库 用 Redis 缓存房态,key 为 hotelID_roomTypeID_date,value 是该日可用房数,并设 TTL 让过期日期自动淘汰。查询走缓存降低库压力;更新仍然落库,再由 CDC(如 Debezium)异步同步到缓存。缓存与库短时间不一致是可以接受的,因为越界预订最终会被数据库挡住。 预订服务 库存缓存 Redis · TTL 库存库 分片 15 查询库存 更新库存 异步同步 缓存与库异步一致(CDC),短暂不一致可接受 按 diagram-design 重绘 查看原图 库存的存储方式基于 hotel_id、room_type_id 和 date:
key: hotelID_roomTypeID_{date}
value: the number of available rooms for the given hotel ID, room type ID and date.
数据一致性是异步完成的,并通过 CDC 流式机制进行管理——读取数据库变更并应用到另一个系统。Debezium 是一种将数据库变更同步到 Redis 的流行方案。
使用这种机制,缓存和数据库有可能在一段时间内不一致。对我们来说这是可接受的,因为数据库会阻止我们生成无效预订。
这会在 UI 上造成一些问题:用户需要刷新页面才能看到“没有剩余房间”。但即便没有这个问题,例如用户在预订前犹豫了很久,也可能发生这种情况。
缓存的优点:
降低数据库负载。
高性能,因为 Redis 在内存中管理数据。
缓存的缺点:
维护缓存和数据库之间的数据一致性很难。我们需要考虑这种不一致如何影响用户体验。
服务间数据一致性 单体应用可以让我们使用共享关系数据库来确保数据一致性。
在我们的微服务设计中,我们选择了一种混合方法:一些服务是独立的,但预订 API 和库存 API 由同一个服务处理。
这样做是因为我们希望利用关系数据库的 ACID 保证来确保一致性。
然而,面试官可能会质疑这种方法,因为它不是纯微服务架构;在纯微服务架构中,每个服务都有自己的数据库:
单体架构 vs 微服务架构 单体架构里预订、库存、支付三个服务共享同一个酒店库,可以直接用关系库的事务保证一致性;纯微服务架构里每个服务各有一个专属数据库,服务之间没有共享事务,一致性要靠分布式手段解决。本章采用混合方案:把预订与库存放进同一个服务、共用一个库。 单体架构 微服务架构 预订服务 库存服务 支付服务 酒店库 预订服务 库存服务 支付服务 预订库 库存库 支付库 专属 专属 专属 共享一个库 → 事务保证一致性 各库各管 → 无共享事务 按 diagram-design 重绘 查看原图 这可能导致一致性问题。在单体服务器中,我们可以利用关系数据库的事务能力来实现原子操作:
单体:一个事务内的原子操作 单体里「管理房态」与「预订房间」两步写操作落在同一个关系库里,可以放进一个事务:要么全部提交,要么全部回滚,不会出现房态改了但订单没落库的中间状态。 单一事务 用户 下单 管理房态 预订房间 数据库 请求 请求 写入 写入 同一事务提交,要么全成功要么全回滚 按 diagram-design 重绘 查看原图 然而,当操作跨越多个服务时,要保证这种原子性更具挑战性:
微服务:跨服务没有共享事务 拆成微服务后,「管理房态」在库存服务、「预订房间」在预订服务,各自只在自己的单服务事务里保证原子性。两个事务彼此独立,一步失败无法回滚另一步,只能靠 2PC 或 Saga 之类的分布式手段补偿。 事务 1 事务 2 用户 下单 库存服务 预订服务 步骤失败 无回滚 管理房态 预订房间 失败 跨服务无共享事务,一步失败无法回滚另一步 按 diagram-design 重绘 查看原图 有一些众所周知的技术可以处理这些数据不一致:
两阶段提交 :一种数据库协议,保证跨多个节点的原子事务提交。但它性能不佳,因为单个节点滞后会导致所有节点阻塞操作。Saga :一系列本地事务;如果工作流中任何步骤失败,会触发补偿事务。这是一种最终一致性方法。
值得注意的是,解决跨微服务的数据不一致问题是一个具有挑战性的问题,会提高系统复杂性。考虑到我们更务实的做法——将相互依赖的操作封装在同一个关系数据库中——最好考虑这种代价是否值得。
第 4 步:总结
我们提出了一个酒店预订系统设计。
我们经历的步骤如下:
收集需求并进行粗略估算,以了解系统规模
在高层次设计中介绍了 API 设计、数据模型和系统架构
在深入探讨中,随着需求变化,探索了备选数据库模式设计
讨论了竞态条件并提出了解决方案——悲观锁/乐观锁、数据库约束
通过数据库分片和缓存扩展系统的方法
最后,我们讨论了如何处理多个微服务之间的数据一致性问题
第 23 章:分布式邮件服务
引言
在本章中,我们将设计一个分布式邮件服务 ,类似于 Gmail 。
2020 年,Gmail 拥有 1.8bil 活跃用户,而 Outlook 在全球拥有 400mil 用户。
第 1 步:理解问题并确定设计范围
C:系统有多少用户?
I:1bil 用户
C:我认为以下功能很重要:认证、发送/接收邮件、获取邮件、过滤邮件、搜索邮件、防垃圾邮件保护。
I:很好的列表。目前不用担心认证。
C:用户如何连接邮件服务器?
I:通常,电子邮件客户端通过 SMTP、POP、IMAP 连接,但在本问题中我们将使用 HTTP。
C:电子邮件可以有附件吗?
I:可以
非功能性需求
可靠性 —— 我们不应丢失数据可用性 —— 我们应使用复制来防止单点故障。我们还应该容忍部分系统故障。可扩展性 —— 随着用户群的增长,我们的系统应能应对他们。灵活性和可扩展性 —— 系统应该灵活且易于扩展新功能。这是我们选择 HTTP 而不是 SMTP/其他邮件协议的原因之一。
粗略估算
1bil 用户 假设每人每天发送 10 封电子邮件 -> 每秒 100k 封电子邮件 。
假设每人每天接收 40 封电子邮件,每封邮件平均有 50kb 元数据 -> 每年 730pb 存储 。
假设 20% 的电子邮件有存储附件,平均大小为 500kb -> 每年 1,460pb 。
第 2 步:提出高层设计并获得认可
电子邮件基础知识 有多种用于发送和接收电子邮件的协议:
SMTP —— 用于从一台服务器向另一台服务器发送电子邮件的标准协议。POP —— 用于从远程邮件服务器接收和下载电子邮件到本地客户端的标准协议。一旦检索,电子邮件就会从远程服务器中删除。IMAP —— 与 POP 类似,用于从远程服务器接收和下载电子邮件,但它将电子邮件保留在服务器端。HTTPS —— 严格来说不是电子邮件协议,但可用于基于 Web 的电子邮件客户端。
除了邮件协议之外,我们还需要为电子邮件服务器配置一些 DNS 记录——MX 记录:
MX 记录查询 发件服务器要投递到 gmail.com,先向 DNS 解析器查询该域的 MX 记录。解析器返回一串带优先级的邮件交换主机,数值越小优先级越高,发件服务器按序尝试投递。 发件服务器 发出邮件 DNS 解析器 查询 MX MX 记录 按优先级 查询 MX 返回列表 MX 记录带优先级,数值越小越优先 20 alt2.gmail-smtp-in.l.google.com 30 alt3.gmail-smtp-in.l.google.com 40 alt4.gmail-smtp-in.l.google.com 5 gmail-smtp-in.l.google.com 10 alt1.gmail-smtp-in.l.google.com 按 diagram-design 重绘 查看原图 电子邮件附件以 base64 编码发送,大多数邮件服务通常有 25mb 的大小限制。
这是可配置的,并且因个人帐户和企业帐户而异。
传统邮件服务器 传统邮件服务器在用户数量有限且连接到单台服务器时运行良好。
传统邮件服务器 Alice 用 Outlook 发信:邮件经 SMTP 送到 outlook.com 服务器并落盘;服务器查 DNS 找到 gmail.com 的 MX 记录后经 SMTP 转发到 gmail 服务器;Bob 再用 IMAP/POP 从 gmail 服务器拉取。收发与存储都绑定在单台服务器上。 outlook.com 邮件服务器 gmail.com 邮件服务器 Alice IMAP/POP SMTP 服务器 本地存储 Bob SMTP 服务器 IMAP/POP 本地存储 1 发送 2 转发 存储 拉取 4 获取 存储 拉取 单机架构:SMTP + IMAP/POP + 本地磁盘 按 diagram-design 重绘 查看原图
Alice 登录她的 Outlook 邮箱并点击“发送”。电子邮件被发送到 Outlook 邮件服务器。通信通过 SMTP 进行。
Outlook 服务器查询 DNS 以查找 gmail.com 的 MX 记录,并将电子邮件传输到他们的服务器。通信通过 SMTP 进行。
Bob 通过 IMAP/POP 从他的 gmail 服务器获取电子邮件。
在传统邮件服务器中,电子邮件存储在本地文件系统上。每封电子邮件都是一个单独的文件。
本地目录存储 传统邮件服务器把邮件存成本地文件:每个用户一个 Maildir 目录,目录下再按状态分成 cur(已读)、new(新到)、tmp(投递中)三个子目录。每封邮件是一个独立文件,磁盘 I/O 很快成为瓶颈。 home user1 user2 Maildir Maildir cur new tmp cur new tmp 每个用户一个 Maildir,邮件按状态分目录 cur 已读 · new 新到 · tmp 投递中 按 diagram-design 重绘 查看原图 随着规模的增长,磁盘 I/O 成为瓶颈。此外,它不满足我们的高可用性和可靠性要求。
磁盘可能损坏,服务器可能宕机。
分布式邮件服务器 分布式邮件服务器旨在支持现代用例并解决现代可扩展性问题。
这些服务器仍然可以为原生电子邮件客户端支持 IMAP/POP,并为跨服务器邮件交换支持 SMTP。
但对于丰富的基于 Web 的邮件客户端,通常使用基于 HTTP 的 RESTful API。
示例 API:
POST /v1/messages —— 将消息发送给 To、Cc、Bcc 标头中的收件人。GET /v1/folders —— 返回电子邮件帐户的所有文件夹。
示例响应:
[{id: string        Unique folder identifier.
  name: string      Name of the folder.
                    According to RFC6154 [9], the default folders can be one of
                    the following: All, Archive, Drafts, Flagged, Junk, Sent,
                    and Trash.
  user_id: string   Reference to the account owner
}]
GET /v1/folders/{:folder_id}/messages —— 返回文件夹下的所有消息,并带有分页GET /v1/messages/{:message_id} —— 获取特定消息的所有信息。
示例响应:
{
  user_id: string                      // Reference to the account owner.
  from: {name: string, email: string}  // <name, email> pair of the sender.
  to: [{name: string, email: string}]  // A list of <name, email> paris
  subject: string                      // Subject of an email
  body: string                         //  Message body
  is_read: boolean                     //  Indicate if a message is read or not.
}
以下是分布式邮件服务器的高层设计:
分布式邮件高层架构 Webmail 通过 https 访问 Web 服务器(登录、资料等请求/响应),通过 WebSocket 连接实时服务器接收新邮件推送;两者都读写底层的存储层——元数据 DB、附件存储、分布式缓存与搜索库。 存储层 Webmail Web 服务器 实时服务器 元数据库 附件存储 分布式缓存 搜索库 https WebSocket 读写 推送 https 走请求/响应,WebSocket 走实时推送 按 diagram-design 重绘 查看原图
Webmail —— 用户使用 Web 浏览器发送/接收电子邮件Web 服务器 —— 面向公众的请求/响应服务,用于管理登录、注册、用户资料等。实时服务器 —— 用于实时向客户端推送新电子邮件更新。我们使用 WebSocket 进行实时通信,但对于不支持的旧浏览器则回退到长轮询。元数据数据库 —— 存储主题、正文、发件人、收件人等信息。附件存储 —— 对象存储(例如 Amazon S3),适合存储大文件。分布式缓存 —— 我们可以在 Redis 中缓存最近的电子邮件以改善用户体验。搜索存储 —— 分布式文档存储,用于支持全文搜索。
以下是电子邮件发送流程:
发信流程 Webmail 经 HTTPS 到负载均衡器,再分给 Web 服务器做基本校验:通过则入待发队列,失败则入错误队列。SMTP 出站线程从待发队列拉取、做垃圾/病毒检查与重试后投递到 Internet;发件同时把元数据、附件与缓存写进存储层,并在 Sent 文件夹留一份。 出站检查 存储层 Webmail 负载均衡 Web 服务器 校验 错误队列 待发队列 SMTP 出站 Internet 垃圾检查 病毒检查 重试 元数据库 搜索库 附件存储 缓存 1 HTTPS 2 分发 4.b 失败 4.a 通过 5 拉取 7 投递 3 存储 6 存 Sent 校验失败走错误队列,可指数退避重试 按 diagram-design 重绘 查看原图
用户撰写电子邮件并点击“发送”。电子邮件被发送到负载均衡器。
负载均衡器对过多的邮件发送进行限流,并路由到其中一个 Web 服务器。
Web 服务器进行基本电子邮件验证(例如电子邮件大小),如果域与发件人相同则短路外发流程。但会先进行垃圾邮件检查。
如果基本验证通过,电子邮件将被发送到消息队列(附件从对象存储中引用)
如果基本验证失败,电子邮件将被发送到错误队列
SMTP 外发工作线程从外发队列拉取消息,执行垃圾邮件/病毒检查并路由到目标邮件服务器。
电子邮件存储在“已发送邮件”文件夹中
我们还需要监控外发消息队列的大小。增长过大可能表明存在问题:
收件人的邮件服务器不可用。我们可以使用指数退避在稍后重试发送电子邮件。
消费者不足以处理负载,我们可能必须扩展消费者。
以下是电子邮件接收流程:
收信流程 来信先到 SMTP 负载均衡器,分发到 SMTP 服务器执行接收策略(无效邮件直接丢弃);过大的附件转存对象存储。邮件处理线程做初步垃圾/病毒检查后,写入存储层、缓存与实时服务器;在线用户经 WebSocket 立即收到,离线用户回线后走 HTTPS 从 Web 服务器拉取。 来信检查 存储层 来信 负载均衡 SMTP 服务器 接收策略 来信队列 邮件处理 垃圾检查 病毒检查 实时服务器 Webmail Web 服务器 附件存储 元数据库 搜索库 缓存 1 来信 2 分发 4 入队 5 处理 7 推送 8 WS 9 HTTPS 3 存附件 6 存储 10 拉取 在线走 WebSocket 推送,离线回线后 HTTPS 拉取 按 diagram-design 重绘 查看原图
传入的电子邮件到达 SMTP 负载均衡器。邮件被分发到 SMTP 服务器,在那里执行邮件接受策略(例如无效电子邮件被直接丢弃)。
如果电子邮件的附件太大,我们可以将其放入对象存储(S3)。
邮件处理工作进程进行初步检查,之后邮件被转发到存储、缓存、对象存储和实时服务器。
离线用户重新上线后通过 HTTP API 获取新电子邮件。
第 3 步:设计深入探讨
现在让我们更深入地探讨一些组件。
元数据数据库 以下是电子邮件元数据的一些特征:
标头通常较小且频繁访问
正文大小从小到大不等,但通常只读取一次
大多数邮件操作都隔离到单个用户——例如获取电子邮件、标记为已读、搜索。
数据新旧影响数据使用。用户通常只阅读最近的电子邮件
数据具有高可靠性要求。数据丢失是不可接受的。
在 gmail/outlook 的规模下,数据库通常是定制的,以减少每秒输入/输出操作数(IOPS)。
让我们考虑一下我们有哪些数据库选项:
关系数据库 —— 我们可以为标头和正文构建索引,但这些数据库通常针对小块数据进行了优化。分布式对象存储 —— 这可以是备份存储的一个不错选择,但无法有效地支持搜索/标记为已读等操作。NoSQL —— Gmail 使用 Google BigTable,但它不是开源的。
基于以上分析,很少有现成的解决方案似乎能完美契合我们的需求。
在面试环境中,设计新的分布式数据库解决方案是不可行的,但提及以下特征很重要:
单列可以是个位数的 MB
强数据一致性
旨在减少磁盘 I/O
高可用且容错
应易于创建增量备份
为了对数据进行分区,我们可以使用 user_id 作为分区键,这样一个用户的数据存储在单个分片上。
这阻止了我们与多个用户共享电子邮件,但这并不是本次面试的要求。
让我们定义表:
主键由分区键(数据分布)和聚簇键(排序数据)组成
我们需要支持的查询:获取用户的所有文件夹、显示文件夹中的所有电子邮件、创建/获取/删除电子邮件、获取已读/未读电子邮件、获取对话线程(附加)
后续表的图例:
表结构图例 三张表都用同一套键标记:K 表示分区键(Partition Key),决定数据分布到哪个分片;C↑ 表示升序聚类键,C↓ 表示降序聚类键,决定同一分区内的排序。 K Partition Key C↑ Clustering Key ↑ C↓ Clustering Key ↓ 分区键定分布,聚类键定排序 ↑ 升序 · ↓ 降序 按 diagram-design 重绘 查看原图 以下是文件夹表:
folders_by_user 表 folders_by_user 以 user_id 为分区键,folder_id 为 UUID,folder_name 为 TEXT。用 user_id 作分区键,可让同一用户的所有文件夹落在同一分片,从而一条查询取回该用户的全部文件夹。 folders_by_user 字段 类型 键 user_id UUID K folder_id UUID — folder_name TEXT — 分区键 user_id 让同一用户的文件夹聚在一起 按 diagram-design 重绘 查看原图 邮件表:
emails_by_folder 表 emails_by_folder 以 (user_id, folder_id) 为分区键、email_id 为降序聚类键。email_id 是 timeuuid,天然按创建时间排序,于是「取某文件夹下最新邮件」就是一次顺序读。 emails_by_folder 字段 类型 键 user_id UUID K folder_id UUID K email_id TIMEUUID C↓ from TEXT — subject TEXT — preview TEXT — is_read BOOLEAN — email_id 是 timeuuid,天然按时间倒序 按 diagram-design 重绘 查看原图
email_id 是 timeuuid,它允许根据电子邮件创建的时间戳进行排序
附件存储在单独的表中,通过文件名标识:
邮件与附件表 emails_by_user 以 user_id 为分区键、email_id 为降序聚类键,存发件人、收件人、主题、正文与附件清单;附件实体拆到独立的 attachments 表,用 (email_id, filename) 定位,url 指向对象存储中的文件。 emails_by_user attachments 字段 类型 键 user_id UUID K email_id TIMEUUID C↓ from TEXT — to LIST<TEXT> — subject TEXT — body TEXT — attachments LIST<filename|size> — 字段 类型 键 email_id TIMEUUID C filename TEXT K url TEXT — 附件清单只存文件名与大小,实体放对象存储 按 diagram-design 重绘 查看原图 在传统关系数据库中支持获取已读/未读电子邮件很容易,但在 Cassandra 中却不容易,因为禁止对非分区/聚簇键进行过滤。
一种变通方法是获取文件夹中的所有电子邮件并在内存中过滤,但这对足够大的应用程序不太适用。
我们可以做的是将电子邮件表反规范化为已读/未读电子邮件表:
已读 / 未读表拆分 Cassandra 禁止按非主键列过滤,无法直接查「未读邮件」。于是把 emails 表反范式化成 read_emails 与 unread_emails 两张表:标记已读时在两张表间搬一行,查询未读就只需扫 unread_emails。 read_emails unread_emails 字段 类型 键 user_id UUID K folder_id UUID K email_id TIMEUUID C↓ from TEXT — subject TEXT — preview TEXT — 字段 类型 键 user_id UUID K folder_id UUID K email_id TIMEUUID C↓ from TEXT — subject TEXT — preview TEXT — 反范式化:标记已读时在两张表间搬行 按 diagram-design 重绘 查看原图 为了支持对话线程,我们可以包含一些邮件客户端解释并用来重建对话线程的标头:
{
  "headers" {
     "Message-Id": "<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>",
     "In-Reply-To": "<CAEWTXuPfN=LzECjDJtgY9Vu03kgFvJnJUSHTt6TW@gmail.com>",
     "References": ["<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>"]
  }
}
最后,对于我们的分布式数据库,我们将用可用性来换取一致性,因为这是本问题的硬性要求。
因此,在发生故障转移或网络分区时,受影响用户的同步/更新操作将短暂不可用。
电子邮件送达率 设置服务器发送电子邮件很容易,但由于垃圾邮件防护算法,让电子邮件进入收件人的收件箱却很难。
如果我们只是设置一个新的邮件服务器并开始通过它发送邮件,我们的电子邮件很可能最终进入垃圾邮件文件夹。
以下是我们为防止这种情况可以做的事情:
专用 IP —— 使用专用 IP 发送电子邮件,否则收件方服务器不会信任我们。分类电子邮件 —— 避免从同一服务器发送营销电子邮件,以防止更重要的电子邮件被归类为垃圾邮件预热我们的 IP 地址 ,慢慢地与大型电子邮件提供商建立良好声誉。预热一个新 IP 需要 2 到 6 周快速封禁垃圾邮件发送者 ,以免损害我们的声誉反馈处理 —— 与 ISP 建立反馈循环,以跟踪投诉率并快速封禁垃圾邮件帐户。电子邮件认证 —— 使用常见技术来打击网络钓鱼,例如 Sender Policy Framework、DomainKeys Identified Mail 等。
我们不需要记住所有这些。只需知道构建一个好的邮件服务器需要大量领域知识。
搜索 搜索包括基于电子邮件内容进行全文搜索,或基于发件人、收件人、主题、未读等过滤条件进行更高级的查询。
电子邮件搜索的一个特点是它仅限用户本地,并且写入多于读取,因为我们需要在每次操作时重新索引,但用户很少使用搜索选项卡。
让我们比较一下 Google 搜索与电子邮件搜索:
Scope
Sorting
Accuracy
Google 搜索
整个互联网
按相关性排序
索引需要一些时间,因此结果不是即时的。
电子邮件搜索
用户自己的邮箱
按属性排序,例如时间、日期等
索引应该很快,结果准确。
为了实现这种搜索功能,一种选择是使用 Elasticsearch 集群。我们可以使用 user_id 作为分区键,将数据分组到同一节点下:
Elasticsearch 搜索 搜索请求同步走 RESTful API 直接查 Elasticsearch;发信、收信、删信这类会改动数据的操作则异步投进 Kafka,由消费者解耦后调用 RESTful API 重建索引。写入远多于读取,因此索引要专为写密集优化。 Elasticsearch 集群 搜索请求 同步 发邮件 收邮件 删邮件 Kafka 异步解耦 Kafka 消费者 RESTful API 分片 1 分片 2 分片 3 同步 发 / 收 / 删邮件经 Kafka 异步解耦 按 user_id 分区,分片落在不同节点 按 diagram-design 重绘 查看原图 变更操作通过 Kafka 异步进行,以使服务与重新索引流程解耦。
实际的数据搜索是同步进行的。
Elasticsearch 是最流行的搜索引擎数据库之一,并且能很好地支持电子邮件全文搜索。
或者,我们可以尝试开发自己的定制搜索解决方案来满足我们的特定需求。
设计这样的系统超出了范围。构建它时的核心挑战之一是为写入密集型工作负载进行优化。
为了实现这一点,我们可以使用日志结构合并树(LSM)来在磁盘上组织索引数据。写入路径仅针对顺序写入进行了优化。
这种技术在 Cassandra、BigTable 和 RocksDB 中使用。
它的核心思想是将数据存储在内存中,直到达到预定义的阈值,然后合并到下一层(磁盘):
LSM-tree 分层 LSM-tree 把写优化为纯顺序写:新数据先进内存的 Level 0(memtable),达到阈值后整体刷到磁盘的 Level 1;各层再按序合并,越往下层数据越多、单个 SSTable 越大、数量越少。 Level 4 磁盘 Level 3 磁盘 Level 2 磁盘 Level 1 磁盘 Level 0 内存 写入先进内存,达阈值后合并到下层磁盘 每个小方块是一个 SSTable,越往下越大越少 时间 → 按 diagram-design 重绘 查看原图 两种方法之间的主要权衡:
Elasticsearch 在一定程度上可以扩展,而定制搜索引擎可以针对电子邮件用例进行微调,从而可以进一步扩展。
Elasticsearch 是我们需要维护的独立服务,与元数据存储并存。定制解决方案可以是数据存储本身。
Elasticsearch 是一个现成的解决方案,而定制搜索引擎需要大量的工程工作来构建。
可扩展性和可用性 由于单个用户操作不会与其他用户冲突,大多数组件可以独立扩展。
为了确保高可用性,我们还可以使用多数据中心设置,并在发生故障时进行主从故障转移:
多数据中心与故障切换 上:美国用户就近接入美国数据中心,数据经复制同步到欧洲数据中心做备份。下:美国数据中心故障时,用户请求切换到欧洲数据中心,由副本继续提供服务——这就是用多副本换取高可用。 正常:跨数据中心复制 故障:切换到备数据中心 美国数据中心 欧洲数据中心 美国数据中心 欧洲数据中心 美国用户 服务器 数据库 服务器 数据库 美国用户 服务器 数据库 服务器 数据库 复制 连接失败 切换 复制 用户就近接入,副本异地复制 主中心不可用 → 切到副本中心 按 diagram-design 重绘 查看原图 第 4 步:总结
额外的讨论要点:
容错 —— 系统的许多部分都可能发生故障。值得考虑如何处理节点故障。合规性 —— 鉴于欧洲的 GDPR 法律,PII 需要以合理的方式存储。安全性 —— 电子邮件加密、网络钓鱼防护、安全浏览等。优化 —— 例如防止不同用户多次发送相同附件的重复。
第 24 章:类 S3 对象存储
引言
在本章中,我们将设计一个类似于 Amazon S3 的对象存储 服务。
存储系统大致分为三类:
块存储 是 20 世纪 60 年代出现的设备。HDD 和 SSD 就是此类例子。
这些设备通常物理连接到服务器,尽管也可以通过高速网络协议进行网络附加。
服务器可以格式化原始块并将其用作文件系统,也可以将原始块的控制权直接交给服务器。
文件存储 构建在块存储之上。它提供了更高层次的抽象,使管理文件夹和文件更加容易。
对象存储 牺牲性能以换取高持久性、大规模和低成本。
它面向“冷”数据,主要用于归档和备份。
没有分层目录结构,所有数据都以对象形式存储在扁平结构中。
与其他存储类型相比,它相对较慢。大多数云提供商都提供对象存储服务——Amazon S3、Google GCS 等。
存储三分类 存储分三类:块存储是裸块设备(HDD/SSD),性能高、成本高;文件存储建在块存储之上,提供目录层级,便于通用文件访问;对象存储牺牲性能换取高持久、海量规模与低成本,数据以扁平结构存为对象,每个对象由数据与元数据组成,通过 RESTful API 访问。 块存储 文件存储 对象存储 块 块 块 块 目录 文件 文件 对象 元数据 载荷 存储三分类:块 / 文件 / 对象 可变 · 成本高 · 性能中高 可变 · 通用文件访问 不可变 · 低成本 · 海量扩展 按 diagram-design 重绘 查看原图
块存储
文件存储
对象存储
可变内容
Y
Y
N(支持对象版本控制)
成本
高
中到高
低
性能
中到高,非常高
中到高
低到中
一致性
强一致性
强一致性
强一致性 [5]
数据访问
SAS/iSCSI/FC
标准文件访问、CIFS/SMB 和 NFS
RESTful API
可扩展性
中等可扩展性
高可扩展性
大规模可扩展性
适用场景
虚拟机(VM)、数据库
通用文件系统访问
二进制数据、非结构化数据
与对象存储相关的一些术语:
Bucket(桶) - 对象的逻辑容器。名称全局唯一。Object(对象) - 存储在桶中的单个数据。包含对象数据和元数据。Versioning(版本控制) - 在同一个桶中保留对象的多个变体的功能。统一资源标识符(URI) - 每个资源都由 URI 唯一标识。服务等级协议(SLA) - 服务提供商与客户端之间的合同。
Amazon S3 Standard-Infrequent Access 存储类别 SLA:
跨多个可用区持久性为 99.999999999%
即使整个可用区被摧毁,数据仍具有韧性
设计可用性为 99.9%
第 1 步:理解问题并确立设计范围
C:应该包含哪些功能?
I:创建桶、对象上传/下载、版本控制、列出桶中的对象
C:典型数据大小是多少?
I:我们需要高效存储大对象和小对象
C:我们每年存储多少数据?
I:100 petabytes
C:我们能否假设数据持久性为 6 个 9(99.9999%),服务可用性为 4 个 9(99.99%)?
I:可以,听起来合理
非功能性需求
100 PB 数据 数据持久性 6 个 9 服务可用性 4 个 9 存储效率。在保持高可靠性和性能的同时降低存储成本。
粗略估算 对象存储的瓶颈很可能在磁盘容量或每秒 IO(IOPS)上。
假设:
我们有 20% 的小对象(小于 1mb),60% 的中型对象(1-64mb)和 20% 的大对象(大于 64mb),
一块硬盘(SATA,7200rpm)每秒能进行 100-150 次随机寻道(100-150 IOPS)
根据这些假设,我们可以估算系统可以持久化的对象总数。
为了简化计算,我们使用每种对象类型的中位大小——小对象 0.5mb,中型对象 32mb,大对象 200mb。
给定 100PB 存储(10^11 MB)和 40% 的存储使用率,结果是 0.68bil 个对象
如果假设元数据为 1kb,那么我们需要 0.68tb 空间来存储元数据信息
第 2 步:提出高层设计并获得认可
在深入设计之前,让我们先探讨对象存储的一些有趣特性:
对象不可变性 - 对象存储中的对象是不可变的(其他存储系统并非如此)。我们可以删除或替换它们,但不能更新。键值存储 - 对象 URI 是它的键,我们可以通过 HTTP 调用获取其内容。一次写入,多次读取 - 数据访问模式是一次写入、多次读取。根据 LinkedIn 的一些研究,95% 的操作是读取。同时支持小对象和大对象
对象存储的设计哲学与 UNIX 类似——当我们保存文件时,它会在一个称为 inode 的数据结构中创建文件名,文件数据存储在磁盘的不同位置。
inode 包含文件块指针列表,这些指针指向磁盘上的不同位置。
访问文件时,在获取文件内容之前,我们先从 inode 获取文件的元数据。
对象存储的工作方式类似——元数据存储用于保存文件信息,但内容存储在磁盘上:
对象存储与 Unix 文件系统 两者设计哲学一致:保存文件时先在一个数据结构里记录文件名,真正的数据放在别处。Unix 用 inode 保存文件名与块指针,通过本地磁盘访问读取块;对象存储用元数据服务保存「对象名 → 对象 ID」,再经网络请求从数据服务按 ID 取回对象内容。 Unix 文件系统 对象存储系统 inode 文件名 / 块指针 硬盘 本地磁盘 MetaStore 对象名 → 对象 ID DataStore Object + ID 磁盘访问 网络请求 设计哲学一致:元数据与内容分离 先查元数据,再读本地磁盘块 先查元数据,再经网络取对象 按 diagram-design 重绘 查看原图 通过将元数据与文件内容分离,我们可以独立扩展不同的存储:
桶与对象 桶是对象的逻辑容器,名称全局唯一,自身带一份元数据(ID、名称、策略、生命周期等)。对象是桶里的一份数据,由数据(对象内容)和对象元数据(ID、名称、版本、过期时间、访问控制等)组成;元数据与数据分开存储,可各自独立扩展。 桶元数据 ID / 名称 / 策略 / 生命周期 桶 全局唯一名称 对象 数据 对象内容 对象元数据 ID / 名称 / 版本 / 过期 描述 桶是逻辑容器;对象 = 数据 + 元数据 元数据与数据分开存储,可各自扩展 按 UUID 定位对象数据 按 diagram-design 重绘 查看原图 高层设计
对象存储高层设计 客户端请求先过负载均衡器,分给无状态的 API 服务;API 服务统一编排:向左调用 IAM 做鉴权与授权,向下写元数据存储,向右把对象读写到数据存储。数据存储内部由主节点与两个从节点组成,主节点把数据复制到从节点以保证持久性。 数据存储 客户端 负载均衡 API 服务 IAM 服务 鉴权 / 授权 元数据存储 主存储节点 从存储节点 从存储节点 HTTP 转发 鉴权 / 授权 元数据 读写对象 复制 复制 无状态 API 服务统一编排 IAM 集中鉴权与访问控制 按 diagram-design 重绘 查看原图
负载均衡器 - 将 API 请求分发到各个服务副本API 服务 - 无状态服务器,编排对元数据存储和对象存储以及 IAM 服务的调用。身份与访问管理(IAM) - 认证、授权和访问控制的集中场所。数据存储 - 存储和检索实际数据。操作基于对象 ID(UUID)。元数据存储 - 存储对象元数据
上传对象
上传对象 上传分七步:① 客户端 PUT 建桶;②⑤ API 服务调 IAM 校验身份与写权限;③ 校验通过后向元数据存储写入桶记录;④ 再 PUT 上传对象 script.txt;⑥ 对象载荷经数据存储落盘并返回 UUID;⑦ API 服务用 object_id、bucket_id、bucket_name 等新建对象元数据。 数据存储 客户端 负载均衡 API 服务 IAM 服务 鉴权 / 授权 元数据存储 主存储节点 从存储节点 从存储节点 ① PUT ① 转发 ②⑤ 鉴权 ③⑦ 元数据 ⑥ 上传对象 复制 复制 ① 建桶 → ②⑤ 鉴权 → ③ 桶元数据 ④ 上传 → ⑥ 落盘 → ⑦ 对象元数据 按 diagram-design 重绘 查看原图
通过 HTTP PUT 请求创建名为 "bucket-to-share" 的桶
API 服务调用 IAM,确保用户已获得授权并具有写权限
API 服务调用元数据存储创建桶条目。创建后返回成功响应。
桶创建后,发送 HTTP PUT 创建名为 "script.txt" 的对象
API 服务验证用户身份并确保用户具有写权限
验证通过后,对象负载通过 HTTP PUT 发送到数据存储。数据存储持久化它并返回 UUID。
API 服务调用元数据存储创建新条目,包括 object_id、bucket_id 和 bucket_name 以及其他元数据。
对象上传请求示例:
PUT /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 17:51:00 GMT
Authorization: authorization string
Content-Type: text/plain
Content-Length: 4567
x-amz-meta-author: Alex

[4567 bytes of object data]
下载对象 桶没有目录层级,但我们可以通过将桶名和对象名拼接起来模拟文件夹结构,从而创建逻辑层级。
获取对象的 GET 请求示例:
GET /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 18:30:01 GMT
Authorization: authorization string
下载对象 下载分五步:① 客户端发送 HTTP GET,如 GET /bucket-to-share/script.txt;② API 服务调 IAM 校验读权限;③ 校验通过后从元数据存储取回对象 UUID;④ 用 UUID 从数据存储取回对象载荷;⑤ 数据沿原路返回客户端。 数据存储 客户端 负载均衡 API 服务 IAM 服务 鉴权 / 授权 元数据存储 主存储节点 从存储节点 从存储节点 ① GET ① 转发 ② 鉴权 ③ 取 UUID ④ 取对象 复制 复制 ① GET → ② 鉴权 → ③ 取 UUID → ④ 取对象 ⑤ 对象数据沿原路返回客户端 按 diagram-design 重绘 查看原图
客户端向负载均衡器发送 HTTP GET 请求,即 GET /bucket-to-share/script.txt
API 服务查询 IAM,验证用户是否具有读取该桶的正确权限
验证通过后,从元数据存储中检索对象的 UUID
根据 UUID 从数据存储中检索对象负载并返回给客户端
// sprint 1
第 3 步:设计深入探讨
数据存储 以下是 API 服务与数据存储的交互方式:
API 服务与数据存储的交互 上传:API 服务向数据存储发请求,携带 file_content 载荷,数据存储落盘后返回 ObjectID。下载:API 服务带上 ObjectID 请求,数据存储按 ID 取回对象数据返回。请求与响应是同一对盒子之间的往返,图中各画单向,响应由注释说明。 上传对象 下载对象 API 服务 数据存储 API 服务 数据存储 请求:上传 响应:对象数据 请求携带 file_content,响应返回 ObjectID 按 ObjectID 取回对象数据 按 diagram-design 重绘 查看原图 数据存储的主要组件:
数据存储的主要组件 数据路由服务提供 RESTful / gRPC 接口访问数据节点集群,本身无状态,靠加机器扩展;它向放置服务查询最佳数据节点,并负责读写数据。放置服务维护虚拟集群映射(物理拓扑),接收所有数据节点的心跳,用 5 或 7 个副本经 Paxos / Raft 同步。数据节点存实际数据,靠复制到多个节点保证持久性。 数据路由服务 放置服务 主节点 从节点 从节点 查询 数据流量 心跳 心跳 心跳 复制 复制 放置服务维护虚拟集群映射 5 或 7 副本,经 Paxos / Raft 同步 数据节点守护进程上报心跳 按 diagram-design 重绘 查看原图 数据路由服务提供 RESTful 或 gRPC API 来访问数据节点集群。
它是一个无状态服务,通过添加更多服务器来扩展。
它的主要职责是:
查询放置服务以获取存储数据的最佳数据节点
从数据节点读取数据并返回给 API 服务
将数据写入数据节点
放置服务确定哪些数据节点应存储对象。
它维护一个虚拟集群映射,用于确定集群的物理拓扑。
虚拟集群映射 虚拟集群映射描述集群的物理拓扑:根节点下按数据中心(DC)划分,每个 DC 下按主机(Host)划分,每台主机再划分出若干分区(Partition)。放置服务据此决定对象应该落到哪些数据节点上。 默认 DC-1 DC-2 Host-1 Host-2 Host-3 Host-4 分区 1 分区 2 分区 3 分区 4 分区 5 分区 6 分区 7 分区 8 根 数据中心 主机 分区 按 diagram-design 重绘 查看原图 该服务还向所有数据节点发送心跳,以确定是否应将它们从虚拟集群中移除。
由于这是一个关键服务,建议维护一个由 5 或 7 个副本组成的集群,并通过 Paxos 或 Raft 共识算法保持同步。
例如,一个 7 节点集群可以容忍 3 个节点故障。
数据节点存储实际的对象数据。
通过将数据复制到多个数据节点来确保可靠性和持久性。
每个数据节点都有一个守护进程在运行,它向放置服务发送心跳。
心跳包括:
数据节点管理多少块磁盘(HDD 或 SSD)?
每块磁盘上存储了多少数据?
数据持久化流程
数据持久化流程 写路径:① API 服务把对象数据转给数据路由服务;② 数据路由服务向放置服务查询,按一致性哈希确定复制组;③ 把数据发给主节点;④ 主节点本地落盘并复制到两个从节点,复制成功后才返回;⑤ 数据路由服务把对象 UUID 返回 API 服务。主节点等待复制完成,偏向强一致而非低延迟。 数据存储 API 服务 数据路由服务 放置服务 主节点 从节点 从节点 ① 写入 ② 选主 ③ 发送数据 ④ 复制 ④ 复制 ⑤ 返回对象 ID 放置服务按一致性哈希确定复制组 主节点复制成功后才返回,偏向强一致 按 diagram-design 重绘 查看原图
API 服务将对象数据转发到数据存储
数据路由服务将数据发送到主数据节点
主数据节点在本地保存数据,并将其复制到两个从数据节点。成功复制后发送响应。
对象的 UUID 返回给 API 服务。
注意事项:
给定对象 UUID,其复制组通过一致性哈希确定性地选择
在第 4 步中,主数据节点在返回响应之前复制对象数据。这优先保证强一致性,而非更低的延迟。
一致性 vs 延迟 主节点复制时机的三种选择:方案一等两个从节点都复制成功才返回,一致性最强、延迟最高;方案二只等一个从节点,一致性与延迟都居中;方案三主节点写完立即返回,一致性最弱、延迟最低。等待的副本越少,写延迟越低,但一致性越弱。 方案一 方案二 方案三 数据路由服务 主节点 从节点 ×2 数据路由服务 主节点 从节点 ×2 数据路由服务 主节点 从节点 ×2 同步等待 复制两副本 同步等待 复制一副本 立即返回 最强一致 · 最高延迟:等待两个从节点确认 中等一致 · 中等延迟:只等一个从节点确认 最弱一致 · 最低延迟:主节点写完即返回 按 diagram-design 重绘 查看原图 数据如何组织
管理数据的一种简单方法是将每个对象存储在单独的文件中。
这种方法可行,但在文件系统中存在许多小文件时性能不佳:
HDD 上的数据块被浪费,因为每个文件都使用整个块大小。典型块大小为 4kb。
许多文件意味着许多 inode。操作系统不能很好地处理过多的 inode,而且还有最大 inode 限制。
这些问题可以通过预写日志(WAL)将许多小文件合并为更大的文件来解决。一旦文件达到其容量(通常为几 GB),就会创建一个新文件:
WAL 合并小对象 每个对象单独存一个文件会浪费磁盘块、并撑爆 inode 数量。用预写日志(WAL)把多个小对象顺序追加合并进一个大文件:当前读写文件(如 /data/c)持续追加 object 1..4,写满后转为只读文件,再新建一个读写文件。代价是同一文件的写入需串行化,可把文件绑定到特定核心以避免锁竞争。 本地文件系统 只读文件 只读文件 读写文件 object 1..4 API 服务 对象 4 写入 追加到末尾 已写满的只读文件 当前读写文件 小对象顺序追加合并;写满后转只读并新建 文件绑定核心以避免锁竞争 按 diagram-design 重绘 查看原图 这种方法的缺点是文件的写访问需要串行化。访问同一个文件的多个核心必须相互等待。
为了解决这个问题,我们可以将文件限制在特定核心上,以避免锁竞争。
对象查找
为了支持在同一文件中存储多个对象,我们需要维护一张表,告诉数据节点:
object_id对象存储所在的 filename
对象起始位置的 file_offset
object_size
我们可以将这张表部署在基于文件的数据库(如 RocksDB)或传统关系数据库中。
由于访问模式是低写入、高读取,关系数据库效果更好。
我们该如何部署它?
我们可以将数据库部署在一个集群中并单独扩展,供所有数据节点访问。
缺点:
我们需要大幅扩展集群以处理所有请求
数据节点与数据库集群之间存在额外的网络延迟
另一种方法是利用数据节点只关心与自己相关的数据这一事实,因此我们可以将关系数据库部署在数据节点内部。
SQLite 是一个不错的选择,因为它是一种轻量级的基于文件的关系数据库。
更新后的数据持久化流程
更新后的数据持久化流程 ① API 服务发来保存新对象的请求;② 数据节点服务把对象追加到当前读写文件(如 /data/c)末尾;③ 同时在本地对象映射表里插入一条记录,记录 obj_id、文件名、偏移与大小。映射表随数据节点本地部署,用 SQLite 这类轻量文件型关系库,避免跨网络访问与额外扩展。 本地机器 只读文件 /data/a 只读文件 /data/b 读写文件 /data/c object_mapping 表 obj_id / 文件 / 偏移 / 大小 API 服务 数据节点服务 ① 保存 ② 追加 ③ 插入记录 映射表随数据节点本地部署 SQLite:轻量文件型关系库 按 diagram-design 重绘 查看原图
API 服务发送保存新对象的请求
数据节点服务将新对象追加到名为 "/data/c" 的文件末尾
在对象映射表中插入该对象的新记录
持久性
数据持久性是我们设计中的重要需求。为了实现 6 个 9 的持久性,需要仔细检查每一种故障情况。
首先要解决的问题是硬件故障。我们可以通过复制数据节点来最大程度降低故障概率。
但除此之外,我们还应该跨不同的故障域进行复制(跨机架、跨数据中心、独立网络等)。
严重事件可能导致同一域内的多个硬件发生故障:
故障域隔离 仅在同一域内复制还不够:一次关键事件(断电、网络故障)可能同时击垮同域的多台机器。因此要把副本跨故障域分布——跨机架、跨数据中心、跨独立网络。图中同一 AZ 内的机架相互独立,副本再跨 AZ 复制,从而在整座 AZ 被摧毁时数据仍然可用。 AZ 1(独立供电与网络) AZ 2(独立供电与网络) AZ 3(独立供电与网络) 机架 1 机架 2 机架 1 机架 2 机架 1 机架 2 节点 1 节点 2 节点 1 节点 2 节点 1 节点 2 跨 AZ 复制 跨 AZ 复制 跨 AZ 复制 跨 AZ 复制 故障域:机架 / 数据中心 / 独立网络 关键事件可能同时击垮同域多台机器 跨域复制把副本分散到独立供电与网络 按 diagram-design 重绘 查看原图 假设典型 HDD 的年故障率为 0.81%,制作三份副本可以为我们提供 6 个 9 的持久性。
像这样复制数据节点可以满足我们想要的持久性,但我们也可以利用纠删码来降低存储成本。
纠删码使我们能够使用奇偶校验位,在发生故障时重建丢失的位:
纠删码原理 纠删码把原始数据切成等长的数据块,再算出若干校验块。把每块看作一个数据节点:只要丢失的块数不超过校验块数,就能用剩下的块重建丢失的数据。这里 4 份数据 + 2 份校验,可容忍任意 2 块丢失。 数据块 校验块 原始数据 d1 d2 d3 d4 计算校验 p1 p2 ① 切成等长数据块 ② 计算校验块 ③ 任意 2 块丢失可重建 4 份数据 + 2 份校验,可容忍 2 块丢失 按 diagram-design 重绘 查看原图 想象这些位是数据节点。如果其中两个宕机,可以使用剩余的四个进行恢复。
存在不同的纠删码方案。在我们的场景中,我们可以使用 8+4 纠删码,并将其分布在不同故障域中以最大化可靠性:
跨故障域的纠删码 采用 8+4 纠删码:原始对象切成 8 个数据块,再算出 4 个校验块,共 12 块。把这 12 块分散到多个故障域,每个域只放其中几块,从而在某个域整体失效时仍能重建对象,最大化可靠性。 故障域 1 故障域 2 故障域 3 故障域 4 原始对象 数学计算 d1 d2 d3 d4 d5 d6 d7 d8 p1 p2 p3 p4 8+4 纠删码:8 个数据块 + 4 个校验块 跨故障域分布,最大化可靠性 按 diagram-design 重绘 查看原图 纠删码使我们能够实现低得多的存储成本(降低 50%),代价是访问速度降低,因为数据路由服务必须从多个位置收集数据:
纠删码 vs 三副本 存 1GB 数据:三副本把整份数据复制到 3 个节点,占用 3GB,存储开销 200%,读快、实现简单,但成本高;纠删码 4+2 把数据切成 6 片各 0.25GB 分散到 6 个节点,占用 1.5GB,开销仅 50%,任意 2 片丢失可重建,代价是计算更多、读取要跨多个位置。 三副本复制(200% 开销) 纠删码 4+2(50% 开销) 1 GB 1 GB 1 GB 0.25 GB 0.25 GB 0.25 GB 0.25 GB 0.25 GB 0.25 GB 副本:整份复制,读快、成本高 纠删码:6 片,任意 2 片丢失可重建 按 diagram-design 重绘 查看原图 其他注意事项:
复制需要 200% 的存储开销(在 3 个副本的情况下),而纠删码为 50%
纠删码 为我们提供 11 个 9 的持久性 ,而复制为 6 个 9
纠删码需要更多计算来校验和存储奇偶校验
总之,复制对延迟敏感的应用更有用,而纠删码在存储成本效率和持久性方面更具吸引力。
纠删码的实现也困难得多。
正确性验证
如果磁盘完全故障,那么故障很容易检测。但如果磁盘部分内存损坏,检测就不那么直接了。
为了检测这种情况,我们可以使用校验和——文件内容的哈希,可用于验证文件的完整性。
在我们的场景中,我们将为每个文件和每个对象存储校验和:
校验和保证正确性 整盘损坏容易发现,局部数据被悄悄改坏却很难察觉。为此为每个文件与每个对象都存一份校验和——文件内容的哈希,读取时重新计算并比对即可发现损坏。采用 8+4 纠删码时,要分别取回 8 个数据片并逐一校验各自的校验和。 本地文件系统 只读文件 文件级校验和 只读文件 文件级校验和 读写文件 对象级校验和 读取时校验哈希,检测静默损坏 损坏则用副本或纠删码重建 8+4 时分别取 8 片逐一校验 按 diagram-design 重绘 查看原图 对于纠删码(8+4)的情况,我们需要分别获取 8 个数据片段,并验证每个片段的校验和。
// sprint 2
元数据数据模型 表结构:
元数据数据模型 元数据主要两张表:bucket 表记录 bucket_name、bucket_id、owner_id、enable_versioning;object 表记录 bucket_name、object_name、object_version、object_id。桶数量有限,单库即可容纳;对象表规模巨大,按 hash(bucket_name, object_name) 分片,因为绝大多数查询都基于对象 / 桶名。 bucket 表 object 表 bucket 桶元数据 object 对象元数据 bucket_name bucket_id owner_id enable_versioning bucket_name object_name object_version object_id object 表按 hash(bucket_name, object_name) 分片 按 diagram-design 重绘 查看原图 我们需要支持的查询:
按名称查找对象 ID
根据名称插入/删除对象
列出桶中具有相同前缀的对象
用户可创建的桶数量通常有限,因此 buckets 表很小,可以放在单个数据库服务器中。
但我们仍需要扩展服务器以提高读吞吐量。
不过,object 表很可能无法放入单个数据库服务器。因此,我们可以通过分片来扩展该表:
按 bucket_id 分片会导致热点问题,因为一个桶可能有数十亿个对象
按 bucket_id 分片使负载更均匀,但查询会变慢
我们选择按 hash(bucket_name, object_name) 分片,因为大多数查询都基于对象/桶名。
然而,即使采用这种分片方案,列出桶中的对象仍然会很慢。
列出桶中的对象 在单个数据库中,基于前缀(看起来像目录)列出对象的工作方式如下:
SELECT * FROM object WHERE bucket_id = "123" AND object_name LIKE `abc/%`
数据库分片后,这很难实现。为了实现它,我们可以在每个分片上运行查询并在内存中聚合结果。
但分页变得困难,因为不同分片包含的结果大小不同,我们需要为每个分片维护单独的 limit/offset。
我们可以利用对象存储通常不针对列出对象进行优化这一事实,因此可以牺牲列出性能。
我们还可以创建一个用于列出对象的非规范化表,按桶 ID 分片。
这将使我们的列出查询足够快,因为它被隔离在单个数据库实例中。
对象版本控制 版本控制通过增加一个 object_version 列来实现,该列类型为 TIMEUUID,使我们能够根据它排序记录。
每个新版本都会生成一个新的 object_id:
对象版本管理 用一个 TIMEUUID 类型的 object_version 列即可按时间排序记录。每次覆盖写入都产生一个新的 object_id:同一对象名 script.txt 下依次出现 version = fas3(当前)、bn31、1ag1(历史),各自指向数据存储里不同的对象 ID。 元数据存储 数据存储 version = fas3 script.txt id 0xM13n version = bn31 script.txt id 0x12Ha version = 1ag1 script.txt id 0x91b4 对象 id 0xM13n 对象 id 0x12Ha 对象 id 0x91b4 当前版本 历史版本 按 diagram-design 重绘 查看原图 删除对象会创建一个新版本,其 object_id 特殊,表示该对象已被删除。对其的查询返回 404:
删除带版本的对象 删除对象并不真的抹掉数据,而是新建一个带特殊 object_id 的版本,标记为 Delete Marker(version = kk1h),表示对象已删除。此后按名查询该对象会返回 404,而历史版本(fas3、bn31、1ag1)与其对象 ID 仍然保留在数据存储里,可按版本号访问。 元数据存储 数据存储 Delete Marker version = kk1h version = fas3 script.txt id 0xM13n version = bn31 script.txt id 0x12Ha version = 1ag1 script.txt id 0x91b4 对象 id 0xM13n 对象 id 0x12Ha 对象 id 0x91b4 当前版本:Delete Marker(查询返回 404) 历史版本仍保留,可按版本号访问 按 diagram-design 重绘 查看原图 优化大文件上传 可以通过分片上传来优化大文件上传——将大文件拆分成多个块,独立上传:
分片上传大文件 大文件用分片上传:① 客户端先向数据存储发起上传;② 数据存储返回唯一标识 upload_id;③ 客户端把大文件拆成多个分片,用 upload_id 各自独立上传;每个分片上传成功后数据存储返回一个 etag(该分片的 MD5 校验和);全部上传完再发起 complete,携带 upload_id、分片号与所有 etag,数据存储据此重组对象。 客户端 数据存储 分片 1 分片 2 分片 8 ETag 1 ETag 2 ETag 8 ① 初始化 ② 上传 大文件拆成多个分片独立上传 ③ complete 携带 upload_id 与各 ETag,重组对象 ETag = 分片的 MD5 按 diagram-design 重绘 查看原图
客户端调用服务以启动分片上传
数据存储返回一个上传 ID,用于唯一标识该上传
客户端将大文件拆分为多个块,并使用上传 ID 独立上传
当某个块上传后,数据存储返回一个 etag,它是标识该上传块的 md5 校验和
所有分片上传完成后,客户端发送完成分片上传请求,其中包括 upload_id、分片编号和所有 etag
数据存储由其分片重新组装对象。该过程可能需要几分钟。完成后,向客户端返回成功响应。
此时可以移除不再有用的旧分片。我们可以引入垃圾收集器来处理它。
垃圾收集 垃圾收集是回收不再使用的存储空间的过程。数据变成垃圾有几种方式:
延迟对象删除 - 对象被标记为已删除,但实际上并未删除孤儿数据 - 例如上传中途失败,旧分片需要删除损坏数据 - 未能通过校验和验证的数据
垃圾收集器还负责回收副本中未使用的空间。
对于复制,数据会从主库和从库中删除。对于纠删码(8+4),数据会从所有 12 个节点中删除。
为了便于删除,我们将使用一种称为压缩的过程:
垃圾收集器将未删除的对象从 "data/b" 复制到 "data/d"
复制完成后,使用数据库事务更新 object_mapping 表
为避免产生过多小文件,压缩只对超过一定阈值的文件进行
压缩回收空间 垃圾回收负责回收不再使用的空间:惰性删除标记过的对象、上传中断留下的孤儿数据、校验失败被判定损坏的数据,以及副本上的冗余。为方便删除,用压缩过程整理文件:① 把未被删除的对象从 data/b 复制到 data/d;② 复制完成后用一次数据库事务更新 object_mapping 表;为避免产生过多小文件,压缩只在文件增长超过阈值时进行。 压缩前 压缩后 object_mapping obj_id / 文件 / 偏移 / 大小 只读文件 /data/b Object 2 / 3 / 5 object_mapping obj_id / 文件 / 偏移 / 大小 只读文件 /data/d Object 3 ① 复制存活对象 ② 更新映射 Object 2 / 5 已删除 存活对象被复制过来 压缩在文件增长超过阈值时进行 按 diagram-design 重绘 查看原图 第 4 步:总结
我们涵盖的内容:
设计类 S3 对象存储
比较对象存储、块存储和文件存储之间的差异
涵盖桶中对象的上传、下载、列出和版本控制
深入设计——数据存储和元数据存储、复制和纠删码、分片上传、分片
第 25 章:实时游戏排行榜
引言
我们将为一款在线手机游戏设计一个排行榜 :
排行榜界面 排行榜展示名次、玩家与积分三列,默认取前 10 名;前三名带星标。数据需实时刷新,不接受批量历史结果。 名次 玩家 积分 1 Aquaboys 976 2 B team 956 3 Berlin's Angels 890 4 GrendelTeam 878 前三名带星标;实时刷新,不用批量历史 5mil DAU / 25mil MAU,每赢一局得 1 分 按 diagram-design 重绘 查看原图 第 1 步:理解问题并确定设计范围
C:排行榜的分数是如何计算的?
I:用户每次赢得一场比赛就会获得一分。
C:所有玩家都包含在排行榜中吗?
I:是的。
C:排行榜是否关联某个时间段?
I:每个月都会开始一场新的锦标赛,并开启一个新的排行榜。
C:我们能否假设只关心前 10 名用户?
I:我们希望显示前 10 名用户,以及特定用户的名次。如果时间允许,可以讨论在排行榜中显示特定用户附近的用户。
C:一场锦标赛有多少用户?
I:5mil DAU 和 25mil MAU。
C:锦标赛期间平均进行多少场比赛?
I:每个玩家平均每天玩 10 场比赛。
C:如果两名玩家分数相同,如何确定名次?
I:这种情况下他们的名次相同。如果时间允许,可以讨论打破平局。
C:排行榜需要实时吗?
I:是的,我们希望呈现实时结果或尽可能接近实时。展示批量结果历史是不可接受的。
功能需求
在排行榜上显示前 10 名玩家
显示用户的特定名次
显示给定用户前后各四名的用户(加分项)
非功能需求
分数实时更新
分数更新实时反映在排行榜上
一般的可扩展性、可用性、可靠性
粗略估算 如果 DAU 为 50mil,并且游戏在 24 小时内的玩家分布均匀,每秒平均会有 50 个用户。
但由于分布通常不均匀,我们可以估计峰值在线用户为每秒 250 个用户。
用户得分的 QPS——平均每天 10 场比赛,50 用户/秒 * 10 = 500 QPS。峰值 QPS = 2500。
获取前 10 名排行榜的 QPS——假设用户平均每天打开一次该页面,QPS 为 50。
第 2 步:提出高层设计并获得认可
API 设计 我们需要的第一个 API 用于更新用户的分数:
POST /v1/scores
该 API 接受两个参数——user_id 和赢得比赛所得的 points。
该 API 应仅对游戏服务器开放,而不是终端客户端。
下一个 API 用于获取排行榜前 10 名玩家:
GET /v1/scores
响应示例:
{
  "data": [
    {
      "user_id": "user_id1",
      "user_name": "alice",
      "rank": 1,
      "score": 12543
    },
    {
      "user_id": "user_id2",
      "user_name": "bob",
      "rank": 2,
      "score": 11500
    }
  ],
  ...
  "total": 10
}
还可以获取特定用户的分数:
GET /v1/scores/{:user_id}
响应示例:
{
    "user_info": {
        "user_id": "user5",
        "score": 1000,
        "rank": 6,
    }
}
高层架构
排行榜高层架构 玩家赢一局后,客户端把结果报给游戏服务;游戏服务校验后调用排行榜服务更新分数,排行榜服务再写入排行榜存储。玩家查询榜单与个人排名时,直接走排行榜服务。 客户端 游戏服务 排行榜服务 排行榜存储 ① 赢一局 ② 更新分数 ③ 更新分数 ④ 取榜单 写路径:赢局 → 游戏服务 → 排行榜服务 → 存储 读路径:客户端直接向排行榜服务取榜单与排名 按 diagram-design 重绘 查看原图
当玩家赢得比赛时,客户端向游戏服务发送请求
游戏服务验证胜利是否有效,并调用排行榜服务更新玩家分数
排行榜服务在排行榜存储中更新用户分数
玩家调用排行榜服务获取排行榜数据,如排名前 10 的玩家和给定玩家的名次
曾考虑过另一种设计,即客户端直接在排行榜服务中更新自己的分数:
当前方案 vs 备选方案 当前方案里客户端只报给游戏服务,由服务端校验赢局后再更新分数;备选方案让客户端直接向排行榜服务写分数,省一跳但可被中间人代理篡改,不安全。 当前方案 备选方案 客户端 游戏服务 排行榜服务 客户端 排行榜服务 ① 赢一局 ② 更新分数 直接上报 服务端校验赢局,客户端改不了分 客户端直连排行榜:可被中间人篡改 按 diagram-design 重绘 查看原图 该选项不安全,容易受到中间人攻击。玩家可以设置代理并随意更改自己的分数。
另一个注意事项是,对于由服务器管理游戏逻辑的游戏,客户端无需显式调用服务器来记录获胜。
服务器会根据游戏逻辑自动完成此操作。
还有一个考虑是,是否应该在游戏服务器和排行榜服务之间放置消息队列。如果其他服务对游戏结果感兴趣,这会很有用,但到目前为止面试中并未明确要求,因此设计中未包含它:
基于消息队列的通信 在游戏服务与排行榜服务之间插入 Kafka:游戏服务只写一次主题,排行榜服务、分析服务、推送服务各自订阅。只有当其他服务也关心对局结果时才值得引入。 游戏服务 Kafka 排行榜服务 分析服务 推送服务 写入 只有其他服务也关心对局结果时,才加这一层队列 三个下游各自订阅同一主题 按 diagram-design 重绘 查看原图 数据模型 我们来讨论存储排行榜数据的选项——关系型数据库、Redis、NoSQL。
NoSQL 解决方案将在深入探讨部分讨论。
关系型数据库解决方案
如果规模无关紧要,且用户数量不多,关系型数据库就能很好地满足我们的需求。
我们可以从一张简单的排行榜表开始,每个月一张(个人备注——这没什么意义,只需添加一个 month 列,避免每个月维护新表的麻烦):
leaderboard 表结构 最简方案:一张 leaderboard 表,user_id 为主键,score 为整数分数。原书按月建表,更省事的做法是加一个 month 列。 leaderboard user_id varchar score int 每月一张表,或加 month 列免去维护负担 user_id 为键,score 是待排序字段 按 diagram-design 重绘 查看原图 表中还可以包含其他数据,但这些数据与我们运行的查询无关,因此省略。
当用户赢得一分时会发生什么?
用户得分时写库 用户赢分时,排行榜服务向数据库写入:用户不存在则 INSERT 一行,已存在则把 score 加 1。 排行榜服务 DB 插入或更新 不存在则 INSERT,已存在则 score = score + 1 每赢一局 +1 分 按 diagram-design 重绘 查看原图 如果用户尚不在表中,我们需要先插入他们:
INSERT INTO leaderboard (user_id, score) VALUES ('mary1934', 1);
在后续调用中,我们只需更新其分数:
UPDATE leaderboard set score=score + 1 where user_id='mary1934';
如何查找排行榜的前几名玩家?
查询榜单名次 取前 N 名要按 score 倒序排序:直接全表排序会做一次表扫描,代价高;给 score 加索引再用 LIMIT 10 可避免扫描全部记录。但查询非头部用户的排名仍会退化成全表扫描。 排行榜服务 DB 排序取前 N 全表排序代价高;score 加索引 + LIMIT 10 优化 非头部用户排名仍要扫描,扩展性差 按 diagram-design 重绘 查看原图 我们可以运行以下查询:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC;
但这并不能提供高性能,因为它会对数据库表中的所有记录进行表扫描并排序。
我们可以通过在 score 上添加索引并使用 LIMIT 操作来避免扫描所有内容,从而进行优化:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 10;
然而,如果用户不在排行榜顶部,而你想定位其名次,这种方法就无法很好地扩展。
Redis 解决方案
我们希望找到一种解决方案,即使面对数百万玩家也能良好运行,而无需依赖复杂的数据库查询。
Redis 是一种内存数据存储,因其在内存中工作而速度极快,并且具有适合我们需求的数据结构——有序集合。
有序集合是一种类似于编程语言中集合的数据结构,它允许你根据给定的标准保持数据结构有序。
在内部,它使用哈希表来维护键(user_id)和值(score)之间的映射,并使用跳表按排序顺序将分数映射到用户:
Redis 有序集合 一个键对应一个有序集合:member 是 user_id,按 score 升序维护。底层用哈希表维护 user_id→score 映射,再用跳表按分数排序,因此插入与查找都是 O(logN)。 leaderboard_feb_2021 score member 99 user10 97 user20 94 user105 92 user45 90 user7 86 user101 83 user9 82 user302 79 user200 72 user309 有序集合 member = user_id(24 字符) 25mil 用户 ≈ 650MB,单机即可容纳 按 diagram-design 重绘 查看原图 跳表如何工作?
它是一种链表,可以快速搜索
它由排序的链表和多级索引组成
跳表结构 跳表 = 有序基础链表 + 多级索引。查找时从最高层索引出发,能跳就跳,跳到不能再跳就下降一层,最终在基础链表里定位目标,避免逐节点遍历。 1 15 60 1 8 15 36 60 1 4 8 10 15 26 36 45 60 68 L2 索引 L1 索引 基础链表 从 L2 跳到 15,再逐层下降,最终在基础链表定位 45 按 diagram-design 重绘 查看原图 当数据集足够大时,这种结构使我们能够快速搜索特定值。
在下面的示例中(64 个节点),在基础链表中查找给定值需要遍历 62 个节点,而在跳表中只需遍历 11 个节点:
跳表的查找性能 以 64 个节点为例:在基础链表上逐节点查找需要遍历 62 个节点;跳表借助多级索引只需 11 跳,橙色路径即实际查找轨迹。 1 2 3 4 5 6 7 8 9 10 11 12 1 3 5 7 9 11 1 5 9 基础链表逐节点遍历:62 步 跳表逐层下降:只需 11 跳 按 diagram-design 重绘 查看原图 有序集合比关系型数据库性能更高,因为数据始终保持在排序状态,代价是添加和查找操作的时间复杂度为 O(logN)。
相比之下,下面是在关系型数据库中查找给定用户排名所需运行的嵌套查询示例:
SELECT *,(SELECT COUNT(*) FROM leaderboard lb2
WHERE lb2.score >= lb1.score) RANK
FROM leaderboard lb1
WHERE lb1.user_id = {:user_id};
在 Redis 中运行排行榜需要哪些操作?
ZADD - 如果用户不存在,则将其插入集合;否则更新分数。O(logN) 时间复杂度。ZINCRBY - 将用户分数增加给定数量。如果用户不存在,分数从零开始。O(logN) 时间复杂度。ZRANGE/ZREVRANGE - 获取按分数排序的一组用户。我们可以指定顺序(ASC/DESC)、偏移量和结果大小。O(logN+M) 时间复杂度,其中 M 是结果大小。ZRANK/ZREVRANK - 按 ASC/DESC 顺序获取给定用户的位置(排名)。O(logN) 时间复杂度。
当用户得分时会发生什么?
ZINCRBY leaderboard_feb_2021 1 'mary1934'
每个月都会创建一个新的排行榜,旧的排行榜会被移至历史存储中。
当用户获取前 10 名玩家时会发生什么?
ZREVRANGE leaderboard_feb_2021 0 9 WITHSCORES
示例结果:
[(user2,score2),(user1,score1),(user5,score5)...]
用户获取自己的排行榜位置呢?
展示用户附近的排名 除前 10 名外,还要展示指定用户前后各 4 名。已知用户排名后,用 ZREVRANGE 取一段区间即可一次拿回这一窗口,无需全表排序。 名次 玩家 积分 267 Aquaboys 876 258 B team 845 259 Berlin's Angels 832 360 GrendelTeam 799 361 Mallow007 785 362 Woo78 743 363 milan~114 732 364 G3^^^^2 726 365 Mailso_91_ 712 高亮行为目标玩家,展示前后各 4 名 ZREVRANGE 取 [357, 365] 区间一次拿回 按 diagram-design 重绘 查看原图 知道用户的排行榜位置后,可以通过以下查询轻松实现:
ZREVRANGE leaderboard_feb_2021 357 365
用户的位置可以通过 ZREVRANK <user-id> 获取。
让我们探讨一下存储需求:
假设最坏情况下,给定月份所有 25mil MAU 都参与游戏
ID 是 24 字符字符串,分数是 16 位整数,我们需要 26 字节 * 25mil = ~650MB 的存储空间
即使由于跳表的开销将存储成本翻倍,这仍然可以轻松放入现代 Redis 集群
另一个需要考虑的非功能需求是支持每秒 2500 次更新。这完全在单个 Redis 服务器的能力范围内。
其他注意事项:
我们可以启动一个 Redis 副本,以避免 Redis 服务器崩溃时丢失数据
我们仍然可以利用 Redis 持久化,在崩溃时避免数据丢失
我们需要在 MySQL 中使用两个辅助表来获取用户详细信息(如用户名、显示名称等),以及存储例如用户赢得比赛的时间
MySQL 中的第二张表可用于在基础设施故障时重建排行榜
作为一项小的性能优化,我们可以缓存前 10 名玩家的用户详细信息,因为它们会经常被访问
第 3 步:设计深入探讨
使用云服务提供商还是自行管理 我们可以选择自行部署和管理服务,也可以使用云服务提供商代为管理。
如果我们选择自行管理服务,将使用 Redis 存储排行榜数据、MySQL 存储用户资料,如果希望扩展数据库,还可以加入用户资料缓存:
自建服务方案 自建方案:客户端经负载均衡打到 Web 服务器;榜单用 Redis 有序集合,用户资料与积分放 MySQL,另用一层 Redis 缓存常被访问的 Top 10 用户资料。 客户端 负载均衡 Web 服务器 Redis 榜单有序集合 MySQL 资料 + 积分 Redis Top10 资料缓存 请求 分发 榜单读写 Top10 缓存 自建:Redis 存榜单,MySQL 存资料,再加一层缓存 Top10 资料常被访问,单独缓存 按 diagram-design 重绘 查看原图 或者,我们可以使用云产品来管理大量服务。例如,我们可以使用 AWS API Gateway 将 API 调用路由到 AWS Lambda 函数:
API 与 Lambda 的映射 API 网关按路由把请求分派给不同 Lambda:取 Top 10 走 LeaderboardFetchTop10,取个人排名走 LeaderboardFetchPlayerRank,更新分数走 LeaderboardUpdateScore。 APIs Lambda 函数 GET /v1/scores LeaderboardFetchTop10 GET /v1/scores/{:user_id} LeaderboardFetchPlayerRank POST /v1/scores LeaderboardUpdateScore API 网关按路由把请求映射到 Lambda 每个 Lambda 只处理一种榜单操作 按 diagram-design 重绘 查看原图 AWS Lambda 使我们无需自行管理或配置服务器即可运行代码。它仅在需要时运行并自动扩展。
用户得分的示例:
得分链路(Serverless) 赢一局的写路径:排行榜服务把请求交给 API 网关,网关触发 Lambda;Lambda 用 ZINCRBY 更新 Redis 里的榜单分数,同时把这一局记进 MySQL 的积分表。 排行榜服务 API 网关 Lambda Redis 排行榜 MySQL 积分表 赢一局 转发 ZINCRBY 插入积分 无需管理服务器:按需运行、自动扩缩 按 diagram-design 重绘 查看原图 用户获取排行榜的示例:
取榜单链路(Serverless) 读路径:Lambda 用 ZREVRANGE 从 Redis 取回榜单与排名,再从 MySQL 取用户资料,结果经 API 网关返回排行榜服务。请求方向相反但走同一走廊,此处只画返回方向。 排行榜服务 API 网关 Lambda Redis 排行榜 MySQL 用户资料 ① 返回榜单 返回 ZREVRANGE ② 取资料 读路径:先取 Top10 与排名,再补用户资料 请求方向相反、走同一走廊,此处只画返回路径 按 diagram-design 重绘 查看原图 Lambda 是无服务器架构的一种实现。我们无需管理扩展和环境配置。
作者建议,如果我们从头开始构建游戏,应采用这种方法。
扩展 Redis 凭借 5mil DAU,从存储和 QPS 的角度来看,单个 Redis 实例就足够了。
然而,如果设想用户基数增长 10 倍至 500mil DAU,那么我们需要 65GB 的存储空间,QPS 将达到 250k。
这种规模将需要分片。
实现分片的一种方法是按范围分区数据:
按分数范围分区 按分数区间把数据切成多个 Redis 有序集合分片,分片映射存在应用或 MySQL 里。取 Top 10 只需查最高分片;取某用户排名则要算本分片内排名,再累加更高分片的用户数(O(1))。 [1, 100] Sorted set [101, 200] Sorted set [201, 300] Sorted set [901, 1000] Sorted set …… 按分数区间分片,分片映射存应用或 MySQL 取 Top10 只查最高分片 [901, 1000] 取用户排名需累加更高分片的用户数 按 diagram-design 重绘 查看原图 在此示例中,我们将根据用户分数进行分片。我们将在应用程序代码中维护 user_id 与分片之间的映射。
我们可以通过 MySQL 或另一个缓存来实现该映射本身。
要获取前 10 名玩家,我们将查询分数最高的分片([900-1000])。
要获取用户的排名,我们需要计算用户在其分片内的排名,并加上其他分片中分数更高的所有用户。
后者是 O(1) 操作,因为每个分片的总记录数可以通过 info keyspace 命令快速获取。
或者,我们可以通过 Redis Cluster 使用哈希分区。它是一个代理,根据类似于一致性哈希的分区机制(但不完全相同)将数据分布到各个 Redis 节点上:
哈希分区(Redis Cluster) Redis Cluster 用代理按槽位分布数据:槽位 = CRC16(key) % 16384。每个分片一主两从,主节点处理写入、从节点提供副本;分片内再按分数有序排列。 Redis Cluster Shard 1 Shard 2 Shard 3 客户端 代理 主节点 [0, 5500] 副本 副本 主节点 [5501, 11000] 副本 副本 主节点 [11001, 16383] 副本 副本 Slot = CRC16(key) % 16384,代理按槽位路由 每分片一主两从:写入主节点,读可走从节点 按 diagram-design 重绘 查看原图 使用这种设置计算前 10 名玩家具有挑战性。我们需要获取每个分片的前 10 名玩家,然后在应用程序中合并结果:
哈希分区下算 Top 10 哈希分区下无法直接定位最高分:必须让每个分片各返回自己的 Top 10,再在应用层归并排序。K 越大、分片越多,取回的数据量与延迟越高。 Shard 0 Top 10 Shard 1 Top 10 Shard 2 Top 10 归并排序 scatter-gather Top 10 榜单 合并 每个分片各取 Top10,再在应用层归并 K 越大、分片越多,延迟越高 示例:99 user10 / 97 user20 / 94 user105 按 diagram-design 重绘 查看原图 哈希分区存在一些局限:
如果需要获取前 K 名用户,且 K 值很大,则延迟会增加,因为我们需要从所有分片获取大量数据
延迟随着分区数量的增加而增加
没有直接的方法来确定用户的排名
基于以上原因,作者倾向于使用固定分区来解决此问题。
其他注意事项:
最佳实践是为写密集型 Redis 节点分配两倍于所需的内存,以便在需要时容纳快照
我们可以使用名为 Redis-benchmark 的工具来跟踪 Redis 设置的性能,并做出数据驱动的决策
替代方案:NoSQL 另一种可考虑的方案是使用合适的 NoSQL 数据库,针对以下方面进行了优化:
DynamoDB、Cassandra 或 MongoDB 都是不错的选择。
在本章中,作者决定使用 DynamoDB。它是一种全托管的 NoSQL 数据库,提供可靠的性能和出色的可扩展性。
当我们需要查询不属于主键的字段时,它还支持使用全局二级索引。
NoSQL 方案:DynamoDB 备选的 NoSQL 方案用 DynamoDB 这类全托管数据库:适合高写入,并能在同一分区内按分数排序;需要查非主键字段时用全局二级索引。 排行榜服务 API 网关 Lambda DynamoDB 请求 调用 读写 全托管 NoSQL:高写入,同分区内按分数排序 用全局二级索引查非主键字段 按 diagram-design 重绘 查看原图 让我们从存储国际象棋游戏排行榜的表开始:
国际象棋榜表结构(主键) DynamoDB 主表:主键是 user_id + score,属性列放邮箱、头像、榜单名。这样按用户查很方便,但按分数查询无法扩展。 主键 属性 user_id score email profile_pic leaderboard_name lovelove 309 love@test.com https://cdn.example/3.png chess#2020-02 i_love_tofu 209 test@test.com https://cdn.example/p.png chess#2020-02 golden_gate 103 gold@test.com https://cdn.example/2.png chess#2020-03 pizza_or_bread 203 piz@test.com https://cdn.example/31.png chess#2021-05 ocean 10 oce@test.com https://cdn.example/32.png chess#2020-02 … … … … … 主键 = user_id + score;属性列可扩展 按 diagram-design 重绘 查看原图 这样做效果不错,但如果需要按分数查询,就无法很好地扩展。因此,我们可以将分数作为排序键:
国际象棋榜表结构(二级索引) 为了按分数查询,把 score 放进排序键:分区键用 chess#月份,排序键用 score,就能在分区内按分数区间查。但按月分区会让最新月份成为热点。 全局二级索引 属性 分区键 (PK) 排序键 (score) user_id email profile_pic chess#2020-02 309 lovelove love@test.com https://cdn.example/3.png chess#2020-02 209 i_love_tofu test@test.com https://cdn.example/p.png chess#2020-03 103 golden_gate gold@test.com https://cdn.example/2.png chess#2020-02 203 pizza_or_bread piz@test.com https://cdn.example/31.png chess#2020-02 10 ocean oce@test.com https://cdn.example/32.png … … … … … 把 score 放进排序键,即可按分数区间查询 按月分区 → 最新月份成热点 按 diagram-design 重绘 查看原图 这种设计的另一个问题是我们按月进行分区。这会导致热点分区,因为与其他月份相比,最新月份会被不均匀地访问。
我们可以使用一种称为写入分片的技术,为每个键附加一个分区号,通过 user_id % num_partitions 计算得出:
国际象棋榜表结构(写分片) 用写分片打散热点:在分区键后追加 user_id % N 得到的分区号。分区越多写入扩展性越好,但读取要查更多分区做 scatter-gather,读扩展性变差。 全局二级索引 属性 分区键 (PK) 排序键 (score) user_id email profile_pic chess#2020-02#p0 309 lovelove love@test.com https://cdn.example/3.png chess#2020-02#p1 209 i_love_tofu test@test.com https://cdn.example/p.png chess#2020-03#p2 103 golden_gate gold@test.com https://cdn.example/2.png chess#2020-02#p1 203 pizza_or_bread piz@test.com https://cdn.example/31.png chess#2020-02#p2 10 ocean oce@test.com https://cdn.example/32.png … … … … … 写分片:分区键追加 user_id % N 的分区号 分区越多写越快,读越慢(需 scatter-gather) 按 diagram-design 重绘 查看原图 一个重要的权衡是应该使用多少个分区:
分区越多,写入可扩展性越高
然而,读取可扩展性会下降,因为我们需要查询更多分区来收集聚合结果
使用这种方法需要我们使用前面看到的“分散-收集”技术,其时间复杂度会随着分区数量的增加而增长:
Scatter-gather 取全局 Top 10 写分片后,每个分区键各存一段榜单。取全局 Top 10 时要向所有分区散开(scatter)各取前 10,再汇总归并(gather)成一个全局榜单;分区越多,查询越慢。 Partition 0 chess#2020-02#p0 Partition 1 chess#2020-02#p1 Partition 2 chess#2020-02#p2 汇总归并 scatter-gather Top 10 榜单 gather gather 合并 散开:各分区各取 Top10 汇总:合并后得到全局 Top10 按 diagram-design 重绘 查看原图 要对分区数量做出良好的评估,我们需要进行一些基准测试。
这种 NoSQL 方法仍有一个主要缺点——很难计算用户的具体排名。
如果我们的规模足以需要分片,那么也许可以告诉用户他们处于哪个分数“百分位”。
可以定期运行一个 cron 作业来分析分数分布,据此确定用户的百分位,例如:
10th percentile = score < 100
20th percentile = score < 500
...
90th percentile = score < 6500
第 4 步:总结
如果时间允许,可以讨论的其他事项:
更快的检索 - 我们可以通过 Redis 哈希缓存用户对象,映射为 user_id -> user object。与查询数据库相比,这能加快检索速度。打破平局 - 当两名玩家分数相同时,我们可以根据最后一场比赛的时间对它们进行排序,从而打破平局。系统故障恢复 - 在发生大规模 Redis 故障时,我们可以通过遍历 MySQL 预写日志条目,并通过临时脚本来重建排行榜。
第 26 章:支付系统
简介
本章我们将设计一个 支付系统 ,它是所有现代 电子商务 的基础。
支付系统 用于结算金融交易,转移货币价值。
第 1 步:理解问题并确定设计范围
C:我们要构建的是哪种支付系统?
I:一个类似 Amazon.com 的电商系统支付后端。它处理所有与资金流动相关的事务。
C:支持哪些支付方式——信用卡、PayPal、银行卡等?
I:系统在现实中应支持所有这些方式。为了面试,我们可以使用信用卡支付。
C:我们自己处理信用卡交易吗?
I:不,我们使用第三方提供商,如 Stripe、Braintree、Square 等。
C:我们会在系统中存储信用卡数据吗?
I:出于合规原因,我们不直接在系统中存储信用卡数据。我们依赖第三方支付处理商。
C:应用是全球化的吗?是否需要支持不同货币和国际支付?
I:应用是全球化的,但为了面试,我们假设只使用一种货币。
C:每天支持多少笔支付交易?
I:每天 1mil 笔交易。
C:是否需要支持付款流程,例如每月向收款人付款?
I:是的,需要支持。
C:还有什么需要我注意的吗?
I:我们需要支持对账,以修复与内部和外部系统通信中的任何不一致。
功能需求
收款流程——支付系统代表商家从客户处接收资金。
付款流程——支付系统将资金发送给世界各地的卖家。
非功能需求
可靠性和容错。失败的支付需要被谨慎处理。
需要在内部系统和外部系统之间建立对账机制。
粗略估算 系统每天需要处理 1mil 笔交易,即每秒 10 笔交易。
这对任何数据库系统来说都不算高吞吐量,因此不是本次面试的重点。
第 2 步:提出高层设计并获得认可
在高层面上,有三个参与资金流动的角色:
三方资金流转 资金流转只有三方参与:买方用信用卡付款(Pay-in)进电商网站的银行账户,电商再把钱结算(Pay-out)给卖方的银行账户。中间的电商网站是资金的中转枢纽。 买方 付款 电商网站 收款 卖方 结算 信用卡 银行账户 电商 银行账户 卖方 付款 Pay-in 结算 Pay-out 三方参与资金流转:买方 → 电商 → 卖方 买方信用卡扣款进平台账户,平台再结算给卖方 按 diagram-design 重绘 查看原图 收款流程 以下是收款流程的高层概览:
Pay-in 高层流程 用户点击下单,支付事件进入支付服务;支付服务落库后把支付单交给支付执行器,执行器落库并调用外部 PSP,PSP 再经卡组织完成信用卡扣款。随后支付服务更新钱包、登记账本,各服务把余额与流水写入各自的库。左侧为支付系统内部,右侧 PSP 与卡组织属外部。 支付系统(内部) 用户 支付事件 支付服务 协调支付 支付库 支付执行器 执行支付单 订单库 账本 钱包 账本库 钱包库 支付服务商 卡组织 ①支付事件 ②存事件 ③支付单 ④存单 ⑤调用 PSP ⑥更新钱包 ⑦存余额 ⑧记账 ⑨存账 内部服务全部落在支付系统边界内 外部:PSP 与卡组织 按 diagram-design 重绘 查看原图
支付服务——接受支付事件并协调支付流程。它通常还会通过第三方提供商进行风险检查,以识别反洗钱(AML)违规或犯罪活动。
支付执行器——通过支付服务提供商(PSP)执行单个支付订单。支付事件可能包含多个支付订单。
支付服务提供商(PSP)——将资金从一个账户转移到另一个账户,例如从买家的信用卡账户转移到电商网站的银行账户。
卡组织——处理信用卡业务的组织,例如 Visa、MasterCard 等。
账本——保存所有支付交易的财务记录。
钱包——保存所有商家的账户余额。
以下是一个收款流程示例:
用户点击“下单”,支付事件被发送到支付服务。
支付服务将事件存储在其数据库中。
支付服务为支付事件中的所有支付订单调用支付执行器。
支付执行器将支付订单存储在其数据库中。
支付执行器调用外部 PSP 处理信用卡支付。
支付执行器处理完支付后,支付服务更新钱包,记录卖家有多少钱。
钱包服务将更新后的余额信息存储在其数据库中。
支付服务调用账本记录所有资金变动。
支付服务的 API POST /v1/payments
{
"buyer_info": {...},
"checkout_id": "some_id",
"credit_card_info": {...},
"payment_orders": [{...}, {...}, {...}]
}
示例 payment_order:
{
  "seller_account": "SELLER_IBAN",
  "amount": "3.15",
  "currency": "USD",
  "payment_order_id": "globally_unique_payment_id"
}
注意事项:
payment_order_id 会转发给 PSP 以对支付去重,即它是幂等键。amount 字段是 string,因为 double 不适合表示金额。
GET /v1/payments/{:id}
该接口根据 payment_order_id 返回单笔支付的执行状态。
支付服务数据模型 我们需要维护两张表——payment_events 和 payment_orders。
对于支付,性能通常不是重要因素。强一致性才是。
选择数据库时的其他考虑因素:
有大量 DBA 人才市场可供招聘来管理数据库。
该数据库在其他大型金融机构中有经过验证的使用记录。
支持工具的丰富程度。
传统 SQL 优于 NoSQL/NewSQL,因为它提供 ACID 保证。
payment_events 表包含以下内容:
checkout_id——字符串,主键buyer_info——字符串(个人备注——可能使用外键指向另一张表更合适)seller_info——字符串(个人备注——同上)credit_card_info——取决于卡提供商is_payment_done——布尔值
payment_orders 表包含以下内容:
payment_order_id——字符串,主键buyer_account——字符串amount——字符串currency——字符串checkout_id——字符串,外键payment_order_status——枚举(NOT_STARTED、EXECUTING、SUCCESS、FAILED)ledger_updated——布尔值wallet_updated——布尔值
注意事项:
一个支付事件会关联多个支付订单。
收款流程不需要 seller_info;仅在付款流程中需要。
当调用相应的服务记录支付结果时,ledger_updated 和 wallet_updated 会被更新。
支付状态转换由后台作业管理,它会检查进行中支付的更新,并在支付未在合理时间内处理时触发告警。
复式记账账本系统 复式记账机制是任何支付系统的关键。它是一种跟踪资金变动的机制:始终将资金操作应用于两个账户,一个账户余额增加(贷记),另一个账户余额减少(借记):
所有交易条目的总和始终为零。这种机制提供了系统内所有资金变动的端到端可追溯性。
托管支付页面 为了避免存储信用卡信息以及遵守各种繁重法规,大多数公司更倾向于使用由 PSP 提供的小组件,由 PSP 为你存储和处理信用卡支付:
PSP 托管支付页 为避免存储卡号与繁重的合规负担,商户直接使用 PSP 提供的托管支付页:页面由 PSP 域名承载,用户在其中填写邮箱、密码等凭据并登录,卡片数据只提交给 PSP,商户系统完全不接触卡号。 PSP 托管支付页 PayPal 邮箱 / 手机号 密码 保持登录 登录并支付 卡片数据只提交到 PSP 域名,商户系统不接触卡号 登录后由 PSP 直接向发卡行发起扣款 按 diagram-design 重绘 查看原图 付款流程 付款流程的组件与收款流程非常相似。
主要区别:
资金从电商网站的银行账户转移到商家的银行账户。
我们可以使用第三方应付账款提供商,如 Tipalti。
关于付款还有许多记账和监管要求需要处理。
第 3 步:设计深入探讨
本节重点讨论如何让系统更快、更健壮、更安全。
PSP 集成 如果我们的系统可以直接连接到银行或卡组织,就可以在没有 PSP 的情况下完成支付。这类连接非常罕见,通常只有能够证明投资合理性的大公司才会使用。
如果走传统路线,PSP 的集成方式有两种:
通过 API,前提是我们的支付系统能够收集支付信息。
通过托管支付页面,以避免处理支付信息相关的法规。
以下是托管支付页面工作流程:
托管支付页工作流 用户在浏览器结算页点击结算,请求打到支付服务;支付服务带 nonce 向 PSP 建单,PSP 返回支付 token 并存入令牌库;随后用户被展示托管支付页并开始支付。支付完成后回跳完成页。异步的 token 返回、支付结果与 webhook 通知见下方说明。 客户端浏览器 支付系统 结算页 点击结算 托管支付页 PSP 页面 完成页 回跳结果 支付服务 协调流程 令牌库 PSP 支付服务商 ①结算 ④存令牌 ②建单 ⑤展示托管页 ⑥发起支付 ⑧跳转 托管页由 PSP 提供,商户不接触卡号 ③ PSP 返回支付 token ⑦ 支付结果回传托管页 ⑨ PSP webhook 通知结果 按 diagram-design 重绘 查看原图
用户在浏览器中点击“结账”按钮。
客户端携带支付订单信息调用支付服务。
收到支付订单信息后,支付服务向 PSP 发送支付注册请求。
PSP 收到货币、金额、有效期等支付信息,以及用于幂等的 UUID。通常使用支付订单的 UUID。
PSP 返回一个唯一标识支付注册的令牌。该令牌存储在支付服务数据库中。
一旦令牌被存储,就会向用户展示 PSP 托管的支付页面。该页面使用令牌以及成功/失败的重定向 URL 进行初始化。
用户在 PSP 页面上填写支付详情,PSP 处理支付并返回支付状态。
用户现在被重定向回 redirectURL。示例重定向 URL:https://your-company.com/?tokenID=JIOUIQ123NSF&payResult=X324FSa
PSP 异步通过 webhook 调用我们的支付服务,将支付结果通知我们的后端。
支付服务根据收到的 webhook 记录支付结果。
对账 上一节解释支付的正常路径。异常路径通过后台对账流程进行检测和对账。
每天晚上,PSP 会发送一个结算文件,我们的系统用它来比较外部系统状态和内部系统状态。
结算文件对账 每晚 PSP 下发结算文件,对账任务用它比对内部与外部状态:支付服务的支付库、支付执行器的订单库、账本库与钱包库的流水都要与 PSP 的结算记录核对,发现的差异进入对账环节,由财务团队按可分类与不可分类分别处理。 支付系统 用户 支付事件 支付服务 支付库 支付执行器 订单库 账本 钱包 账本库 钱包库 对账 核对差异 支付服务商 卡组织 ①支付事件 ②存事件 ③支付单 ④存单 ⑤调用 PSP ⑥记账 ⑦更新钱包 ⑧存账 ⑨存余额 核对 结算文件 每晚对账:以 PSP 结算文件为准 不可分类的差异由财务人工核查 按 diagram-design 重绘 查看原图 这个过程还可用于检测内部不一致,例如账本和钱包服务之间的不一致。
不匹配由财务团队手动处理。不匹配的处理方式如下:
可分类的,因此这是已知不匹配,可以使用标准流程进行调整。
可分类但无法自动化。由财务团队手动调整。
不可分类。由财务团队手动调查和调整。
处理支付处理延迟 有时支付可能需要数小时才能完成,尽管通常只需几秒钟。
这可能是由于:
支付被标记为高风险,必须有人工审核。
信用卡需要额外保护,例如 3D Secure 身份验证,需要持卡人提供额外信息才能完成。
这些情况通过以下方式处理:
等待 PSP 在支付完成时向我们发送 webhook;如果 PSP 不提供 webhook,则轮询其 API。
向用户显示“处理中”状态,并提供一个页面让他们查看支付更新。我们也可以在支付完成后向他们发送电子邮件。
内部服务之间的通信 服务之间有两种通信模式——同步和异步。
同步通信(即 HTTP)在小规模系统中运行良好,但随着规模增大会出现问题:
性能低——随着更多服务参与调用链,请求-响应周期会变长。
故障隔离差——如果 PSP 或任何其他服务失败,用户将无法收到响应。
紧耦合——发送方需要知道接收方。
难以扩展——由于没有缓冲,不容易支持流量的突然增加。
异步通信可以分为两类。
单接收方——多个接收方订阅同一主题,消息只被处理一次:
单接收者模式 多个服务订阅同一个 topic,但每条消息只被处理一次:消息 m1 投递给服务 A,消息 m2 投递给服务 B,各服务按自己的节奏消费,互不重复。 消息队列 同一 topic 服务 A 订阅者 服务 B 订阅者 m1 m2 同一 topic 多订阅者,每条消息只投递给一个服务 消息 m4→m3→m2→m1 依次出队 按 diagram-design 重绘 查看原图 多接收方——多个接收方订阅同一主题,消息会转发给所有接收方:
多接收者模式 多个服务订阅同一个 topic,同一条消息被转发给所有订阅者:支付事件经消息队列广播后,支付系统、分析服务与计费服务各收到一份 m1,各自触发自己的副作用。 事件源 支付事件 消息队列 同一 topic 支付系统 分析服务 计费服务 发布 m1 m1 m1 同一 topic 广播给所有订阅者,每条消息投递多份 一次支付触发多个副作用:支付、分析、计费 按 diagram-design 重绘 查看原图 后一种模型很适合我们的支付系统,因为一笔支付可以触发多个副作用,由不同服务处理。
简而言之,同步通信更简单,但不允许服务自主。异步通信用简单性和一致性换取可扩展性和弹性。
处理失败支付 每个支付系统都需要处理失败支付。以下是我们用来实现这一目标的一些机制:
跟踪支付状态——每当支付失败时,我们可以根据支付状态决定重试还是退款。
重试队列——将要重试的支付发布到重试队列。
死信队列——最终失败的支付被推送到死信队列,在那里可以调试和检查失败支付。
失败支付处理 失败支付先判定是否可重试:可重试的进入重试队列,由支付系统再次执行;再次失败后继续判定,仍可重试则回到重试队列,终态失败则进死信队列等待调试。不可重试的支付直接落库,交给人工排查。 失败 可重试? 重试队列 支付系统 仍失败 可重试? 死信队列 数据库 是 否 重试 仍失败 否 是 失败支付先判定可否重试 不可重试:落库待人工排查 终态失败:进死信队列 按 diagram-design 重绘 查看原图 精确一次投递 我们需要确保支付被精确一次处理,以避免向客户重复收费。
如果操作同时满足至少一次和至多一次,那么它就被精确一次执行。
为了实现至少一次保证,我们将使用重试机制:
重试机制 为实现至少一次投递,客户端在支付失败后按策略重试:前三次每次支付 10 元都被支付系统拒绝,客户端按指数退避的间隔再次发起,第四次请求终于成功。重试间隔可采用立即、固定、递增或指数退避等策略。 客户端 发起支付 支付系统 处理扣款 Pay $10 Pay $10 Pay $10 Pay $10 失败 失败 失败 成功 重试 重试 重试 按 diagram-design 重绘 查看原图 以下是决定重试间隔的一些常见策略:
立即重试——客户端在失败后立即发送另一个请求。
固定间隔——在重试支付前等待固定时间。
递增间隔——每次重试之间递增地增加重试间隔。
指数退避——在后续重试之间将重试间隔加倍。
取消——客户端取消请求。当错误是永久性的或达到重试阈值时会发生这种情况。
经验法则是默认使用指数退避重试策略。一个良好实践是服务器使用 Retry-After 头指定重试间隔。
重试的一个问题是服务器可能会处理同一笔支付两次:
客户端点击了两次“支付按钮”,因此被扣款两次。
支付已由 PSP 成功处理,但未被下游服务(账本、钱包)处理。重试会导致 PSP 再次处理该支付。
为了解决重复支付问题,我们需要使用幂等机制——即一个操作被多次应用时只被处理一次的特性。
从 API 的角度来看,客户端可以发出多个调用并产生相同结果。幂等由请求中的特殊头(例如 idempotency-key)管理,通常是一个 UUID。
幂等示例 首次请求携带 idempotency-key 建单,服务端扣款成功后返回结果。客户端超时后重试,携带同一个 key;服务端发现该 key 已处理过,直接返回上次的结果而不再扣款,从而避免重复收费。 首次请求 重试 客户端 发起支付 支付系统 幂等校验 客户端 支付系统 已见过该 key POST 建单 扣款成功 POST 相同 key 返回上次结果 Retry 重试携带相同 idempotency-key:服务端识别后直接返回上次结果,不再扣款 按 diagram-design 重绘 查看原图 可以通过数据库的添加唯一键约束机制来实现幂等:
服务器尝试在数据库中插入新行。
由于唯一键约束冲突,插入失败。
服务器检测到该错误,并改为将现有对象返回给客户端。
幂等也应用在 PSP 侧,使用前面讨论过的 nonce。PSP 会注意不会处理具有相同 nonce 的支付两次。
一致性 在支付生命周期中会调用多个有状态服务——PSP、账本、钱包、支付服务。
任何两个服务之间的通信都可能失败。我们可以通过实现精确一次处理和对账来确保所有服务之间的最终数据一致性。
如果使用复制,就必须处理复制延迟,这可能导致用户在主库和从库之间观察到不一致的数据。
为了缓解这个问题,我们可以让所有读写都从主库提供服务,只将从库用于冗余和故障转移。
或者,我们可以通过使用 Paxos 或 Raft 等共识算法来确保从库始终同步。我们还可以使用基于共识的分布式数据库,如 YugabyteDB 或 CockroachDB。
支付安全 以下是一些可以用来确保支付安全的机制:
请求/响应窃听——我们可以使用 HTTPS 来保护所有通信。
数据篡改——强制加密并进行完整性监控。
中间人攻击——使用带证书固定的 SSL。
数据丢失——跨多个区域复制数据并拍摄数据快照。
DDoS 攻击——实现限流和防火墙。
卡盗用——使用令牌,而不是在系统中存储真实卡信息。
PCI 合规——针对处理带品牌信用卡组织的安全标准。
欺诈——地址验证、卡片验证码(CVV)、用户行为分析等。
第 4 步:总结
其他讨论要点:
监控和告警。
调试工具——我们需要便于理解支付失败原因的工具。
货币兑换——设计国际化支付系统时很重要。
地域——不同地区可能有不同的支付方式。
现金支付——在印度和巴西等地非常常见。
Google/Apple Pay 集成。
第 27 章:数字钱包
引言
支付平台 通常都有钱包服务 ,允许客户端将资金存储在应用内,之后可以再提现。
你也可以用它来支付商品和服务,或向其他使用数字钱包 服务的用户转账。与通过传统支付渠道相比,这可能更快、更便宜。
数字钱包总览 用户在支付平台内开一个数字钱包:从银行卡充值(Deposit)把钱存进钱包,之后可以直接用钱包在电商网站支付,比走普通支付通道更快、更便宜。 银行卡 银行 数字钱包 支付系统 电商网站 充值 支付 钱包支持充值、提现、转账与支付 按 diagram-design 重绘 查看原图 步骤 1:理解问题并确定设计范围
C:我们是否只应关注数字钱包之间的转账?还需要支持其他操作吗?
I:我们先只关注数字钱包之间的转账。
C:系统需要支持每秒多少笔交易?
I:假设为 1mil TPS。
C:数字钱包对正确性有严格要求。我们能否假设事务性保证就足够了?
I:可以。
C:我们需要证明正确性吗?
I:我们可以通过对账来做,但那只检测差异,不能显示差异的根本原因。相反,我们希望能从一开始重放数据来重建历史。
C:我们能否假设可用性要求为 99.99%?
I:可以。
C:是否需要考虑外汇?
I:不需要,这超出了范围。
总结一下,我们需要支持以下内容:
支持两个账户之间的余额转账
支持 1mil TPS
可靠性为 99.99%
支持事务
支持可重现性
粗略估算 云上部署的传统关系型数据库可以支持约 1000 TPS。
为了达到 1mil TPS,我们需要 1000 个数据库节点。但如果每笔转账有两个分支,那么我们实际上需要支持 2mil TPS。
我们的设计目标之一是提高单节点可处理的 TPS,这样就能减少数据库节点数量。
Per-node TPS
Node Number
100
20,000
1,000
2,000
10,000
200
步骤 2:提出高级设计并获得认可
API 设计 在本次面试中,我们只需要支持一个端点:
POST /v1/wallet/balance_transfer - transfers balance from one wallet to another
请求参数:from_account、to_account、amount(字符串以避免精度丢失)、currency、transaction_id(幂等键)。
响应示例:
{
    "status": "success"
    "transaction_id": "01589980-2664-11ec-9621-0242ac130002"
}
内存分片方案 我们的钱包应用为每个用户账户维护账户余额。
一种合适的数据结构是 map<user_id, balance>,可以使用内存 Redis 存储来实现。
由于单个 Redis 节点无法承受 1mil TPS,我们需要将 Redis 集群分区到多个节点。
分区算法示例:
String accountID = "A";
Int partitionNumber = 7;
Int myPartition = accountID.hashCode() % partitionNumber;
Zookeeper 可用作高可用的配置存储,保存分区数量和 Redis 节点地址。
最后,钱包服务是无状态服务,负责执行转账操作。它可以轻松地水平扩展:
钱包服务与内存分片 无状态的钱包服务接收转账命令,按 accountID 哈希把账户分到多个 Redis 分片;分片数量与地址存在 Zookeeper 里。服务可水平扩展,但跨分片的转账无法原子执行。 转账命令 A −$1 → B 转账命令 钱包服务 钱包服务 Redis { A: 余额 } Redis { B: 余额 } Redis { C: 余额 } Zookeeper 分片信息 提交 提交 读分片 A −$1 B +$1 C +$1 按 accountID 哈希分片;跨分片转账无法原子完成 按 diagram-design 重绘 查看原图 尽管该方案解决了可扩展性问题,但它不允许我们原子地执行余额转账。
分布式事务 处理事务的一种方法是在标准的分片关系型数据库之上使用两阶段提交协议:
分片关系数据库上的分布式事务 把内存 Redis 换成可持久化的关系数据库分片,每个分片保存 ID / Balance 表。钱包服务仍按哈希路由,但跨分片转账需要在多个数据库上执行事务。 转账命令 A −$1 → B 转账命令 钱包服务 钱包服务 关系数据库 ID: A · 余额: 1 关系数据库 ID: B · 余额: 1 关系数据库 ID: C · 余额: 1 Zookeeper 分片信息 提交 提交 读分片 A −$1 B +$1 C +$1 事务要跨多个数据库,需要 2PC / TC-C 之类的协调 按 diagram-design 重绘 查看原图 两阶段提交(2PC)协议的工作原理如下:
两阶段提交(2PC) 协调者(钱包服务)依次向每个数据库发 canCommit?;只有全部回复 yes 后才发出 doCommit,再等所有数据库回 haveCommitted 才算成功;任一阶段失败则全部回滚释放锁。第二库走完全相同的 4 步。 协调者 钱包服务 数据库 A 4 步协议: ① 协调者 canCommit? → ② DB yes → ③ 协调者 doCommit → ④ DB haveCommitted 数据库 C 走完全相同的 4 步;任一阶段失败 → 全部回滚释放锁 按 diagram-design 重绘 查看原图
协调者(钱包服务)像平常一样在多个数据库上执行读写操作。
当应用准备好提交事务时,协调者要求所有数据库准备提交。
如果所有数据库都回复“是”,协调者再要求数据库提交事务。
否则,所有数据库都被要求中止事务。
2PC 方案的缺点:
使用 Try-Confirm/Cancel(TC/C)的分布式事务 TC/C 是 2PC 协议的一种变体,使用补偿事务:
协调者要求所有数据库为事务预留资源。
协调者收集数据库的回复:如果是“是”,数据库被要求尝试确认;如果是“否”,数据库被要求尝试取消。
TC/C 与 2PC 的一个重要区别是:2PC 执行的是单个事务,而 TC/C 中有两个独立事务。
下面是 TC/C 按阶段工作的方式:
阶段
操作
A
C
1
尝试
余额变动:-$1
不执行任何操作
2
确认
不执行任何操作
余额变动:+$1
取消
余额变动:+$1
不执行任何操作
阶段 1 —— 尝试:
TC/C 第一阶段:Try 协调者在 A 的数据库上开启本地事务,把 A 的余额减 $1 并加锁;C 的数据库收到 NOP 指令,什么都不做。 协调者 钱包服务 数据库 A 余额 $1 → $0 数据库 C 余额 $0 Try: A−$1 NOP A 扣款 $1 并加锁;C 收到 NOP 扣款先于加款,保证中间态不会凭空多钱 按 diagram-design 重绘 查看原图
协调者在 A 的数据库中启动本地事务,将 A 的余额减少 1$。
C 的数据库收到一个 NOP 指令,不执行任何操作。
阶段 2a —— 确认:
TC/C 第二阶段:Confirm 若第一阶段两个数据库都回复 yes,进入确认阶段:A 的数据库收到 NOP,C 的数据库被要求把余额加 $1(本地事务)。 协调者 第一阶段 Try 第二阶段 Confirm 数据库 A 余额 $1 数据库 C 余额 $0 Try: A−$1 Confirm: C+$1 A=$1 C=$1 两个独立事务:先扣 A,再确认给 C 加钱 按 diagram-design 重绘 查看原图
如果两个数据库都回复“是”,则确认阶段开始。
A 的数据库收到 NOP,而 C 的数据库被指示将 C 的余额增加 1$(本地事务)。
阶段 2b —— 取消:
TC/C 第二阶段:Cancel 若第一阶段任一步失败,进入取消阶段:A 的数据库被要求把余额加回 $1(补偿操作),C 的数据库收到 NOP。 协调者 第一阶段 Try 第二阶段 Cancel 数据库 A 余额 $0 数据库 C 余额 $0 Try: A−$1 Cancel: A+$1 A=$1 回滚 A=$1 用补偿事务撤销已提交的扣款;C 收到 NOP 按 diagram-design 重绘 查看原图
如果阶段 1 中任意操作失败,则取消阶段开始。
A 的数据库被指示将 A 的余额增加 1$,C 的数据库收到 NOP。
下面是 2PC 与 TC/C 的比较:
第一阶段
第二阶段:成功
第二阶段:失败
2PC
事务尚未完成
提交/取消所有事务
取消所有事务
TC/C
所有事务都已完成——已提交或已取消
如有必要,执行新事务
反转已提交的事务
TC/C 也被称为补偿式分布式事务。高层操作在业务逻辑中处理。
TC/C 的其他特性:
数据库无关,只要数据库支持事务即可
分布式事务的细节和复杂性需要在业务逻辑中处理
TC/C 故障模式 如果协调者在事务中途崩溃,它需要恢复其中间状态。可以通过维护阶段状态表来实现,这些表在数据库分片内原子更新:
用阶段状态表恢复中间态 协调者若中途宕机,需要恢复自己的中间状态。办法是在每个数据库分片内原子维护一张阶段状态表(记录事务内容、try 状态、第二阶段名与状态、乱序标志)。 转账命令 A −$1 → B 转账命令 钱包服务 钱包服务 数据库分片 阶段状态表 + 余额表 数据库分片 阶段状态表 + 余额表 数据库分片 阶段状态表 + 余额表 Zookeeper 分片信息 提交 提交 读分片 A −$1 B +$1 C +$1 表在分片内原子更新,供协调者重启后恢复 按 diagram-design 重绘 查看原图 该表包含什么:
分布式事务的 ID 和内容
尝试阶段的状态:未发送、已发送、已收到响应
第二阶段名称:确认或取消
第二阶段状态
乱序标志(稍后解释)
使用 TC/C 时需要注意的一点是:在分布式事务进行过程中,账户状态之间会短暂出现不一致:
分布式事务的中间不平衡态 事务在途时,各账户状态会短暂不一致:TC/C 开始时 A+C=$1,第一阶段之后变成 $0(少了 $1),第二阶段完成后又回到 $1。只要总能恢复、且用户无法动用中间态,就是可接受的。 TC/C 开始前 A + C = $1 第一阶段之后 A + C = $0 第二阶段之后 A + C = $1 损失 $1 恢复 $1 中间态总额少 $1,会被下一阶段补回 按 diagram-design 重绘 查看原图 只要我们总能从这个状态恢复,并且用户不能使用中间状态(例如用于消费),这就是可以接受的。始终先执行扣款再执行加款可以保证这一点。
尝试阶段选择
账户 A
账户 C
选择 1
-$1
NOP
选择 2(无效)
NOP
+$1
选择 3(无效)
-$1
+$1
注意,上表中的选择 3 是无效的,因为我们不能在不依赖 2PC 的情况下保证跨不同数据库的事务原子执行。
需要处理的一个边界情况是乱序执行:
乱序执行的处理 数据库可能先收到 Cancel 再收到 Try。此时在阶段状态表里置上乱序标志;之后 Try 到达时先检查该标志,若已置位就直接返回失败。 协调者 数据库 A Try 失败 数据库 C 先收到 Cancel 阶段状态表 out-of-order 标志 Try Cancel 先到 置位标志 Try 到达时若乱序标志已置位,直接返回失败 按 diagram-design 重绘 查看原图 数据库有可能在收到尝试操作之前先收到取消操作。可以通过在阶段状态表中添加乱序标志来处理这个边界情况。收到尝试操作时,我们先检查乱序标志是否被设置,如果已设置则返回失败。
使用 Saga 的分布式事务 另一种流行的方法是使用 Saga——一种在微服务架构中实现分布式事务的标准。
其工作原理如下:
所有操作按顺序排列。所有操作在各自的数据库中独立执行。
操作从第一个到最后一个执行。
当某个操作失败时,整个流程开始回滚,直到起点,并执行补偿操作。
Saga 事务 所有操作排成一条链、依次执行;一旦某步失败,就从当前步开始向前逐步执行补偿操作回滚。每一步都在自己的数据库里,失败时执行相反方向的补偿。 开始 A −$1 C +$1 成功 A +$1 C −$1 A +$1 成功 完成 失败 失败 失败 正向顺序执行;失败则逐步补偿回滚 按 diagram-design 重绘 查看原图 我们如何协调工作流?有两种方法:
Choreography——参与 Saga 的所有服务订阅相关事件,并在 Saga 中完成各自的部分
Orchestration——单个协调者指示所有服务按正确顺序完成工作
使用 Choreography 的挑战在于业务逻辑分散在多个服务中,服务之间异步通信。
Orchestration 方式能很好地处理复杂性,因此通常是数字钱包系统中的首选方法。
下面是 TC/C 与 Saga 的比较:
TC/C
Saga
补偿操作
在取消阶段
在回滚阶段
中心化协调
是
是(Orchestration 模式)
操作执行顺序
任意
线性
并行执行可能性
是
否(线性执行)
可能看到部分不一致状态
是
是
应用或数据库逻辑
应用
应用
主要区别在于 TC/C 可以并行执行,因此我们的决策取决于延迟要求——如果需要实现低延迟,就应该选择 TC/C 方案。
无论采用哪种方案,我们仍然需要支持审计和重放历史,以便从故障状态恢复。
事件溯源 在现实中,数字钱包应用可能会被审计,我们必须回答某些问题:
我们是否知道任意给定时间的账户余额?
我们如何知道历史和当前余额是正确的?
代码变更后,我们如何证明系统逻辑是正确的?
事件溯源是一种帮助我们回答这些问题的技术。
它包含四个概念:
命令(command)——来自现实世界的预期操作,例如从账户 A 向账户 B 转账 1$。命令需要具有全局顺序,因此会被放入 FIFO 队列。
与事件不同,命令可能失败,并且由于 IO 或无效状态等原因带有一定随机性。
命令可以产生零个或多个事件。
事件生成可能包含随机性,例如外部 IO。稍后会再次讨论。
事件(event)——系统中已发生的历史事实,例如“从 A 向 B 转账 1$”。
与命令不同,事件是在我们系统内已经发生的事实。
与命令类似,事件也需要有序,因此会被放入 FIFO 队列。
状态(state)——事件发生后发生变化的内容。例如账户与其余额之间的键值存储。
状态机(state machine)——驱动事件溯源过程。它主要验证命令并应用事件来更新系统状态。
状态机应该是确定性的,因此不应读取外部 IO 或依赖随机性。
事件溯源的四要素 命令是来自现实世界的意图(可失败、含随机性);状态机校验命令后产生事件;事件是系统里已经发生的事实;另一个状态机把事件应用到状态上,读写出账户余额。 命令 可失败 · 含随机 状态机 校验命令 事件 已发生的事实 状态机 应用事件 状态 余额 输入 校验 产出 读取 应用 命令可失败;事件是事实,状态机须确定性 按 diagram-design 重绘 查看原图 下面是事件溯源的动态视图:
事件溯源的动态视图 命令按时间顺序到达,经状态机校验后生成事件;事件再被应用到状态上,状态随之推进。如此循环,形成一条随时间前进的链路。 命令 事件 状态 命令 事件 状态 命令 事件 状态 校验 应用 校验 应用 校验 应用 命令 → 校验 → 事件 → 应用 → 状态,循环推进 按 diagram-design 重绘 查看原图 对于我们的钱包服务,命令就是余额转账请求。我们可以将它们放入 FIFO 队列,例如 Kafka:
命令队列 命令需要全局顺序,因此放进 FIFO 队列(如 Kafka)。转账命令从一端入队、按序从另一端出队,交给状态机处理。 命令队列 A −$1→ C A −$1→ C A −$1→ B A −$1→ D out in out 命令按全局顺序入队,保证先后一致 按 diagram-design 重绘 查看原图 完整架构如下图所示:
钱包服务状态机全景 状态机从命令队列读取命令,从数据库读取余额;命令通过校验后为两个账户各生成一个事件并写入事件队列;事件再被应用,更新数据库里的余额状态。 客户端 命令队列 Kafka 状态机 校验命令 事件队列 余额状态 A/B/C/D 状态机 应用事件 提交命令 读取 生成事件 读取余额 读取事件 更新余额 命令保序入队;校验后生成事件;事件再更新余额 按 diagram-design 重绘 查看原图
状态机从命令队列读取命令。
从数据库读取余额状态。
验证命令。如果有效,则为每个账户生成两个事件。
读取下一个事件,并通过更新数据库中的余额(状态)来应用事件。
使用事件溯源的主要优势在于其可重现性。在此设计中,所有状态更新操作都被保存为所有余额变更的不可变历史。
历史余额始终可以通过从一开始重放事件来重建。由于事件列表不可变且状态机是确定性的,我们保证能够成功重放任意中间状态。
重放事件重建历史状态 命令产生的事件写进事件队列,再按序应用到状态上;从事件列表开头重放,就能重建任意时刻的历史余额(如图所示逐次累积)。 命令队列 事件队列 A −$1→ C A −$1→ B A −$1→ D A:−$1 C:+$1 A:−$1 B:+$1 A:−$1 D:+$1 历史状态 1 A:$5 B:$4 C:$3 D:$2 历史状态 2 A:$4 B:$4 C:$4 D:$2 历史状态 3 A:$3 B:$5 C:$4 D:$2 事件不可变,从头重放即可重建任意时刻 按 diagram-design 重绘 查看原图 本节开头提出的所有审计相关问题都可以通过事件溯源来回答:
我们是否知道任意给定时间的账户余额?——可以从头开始重放事件,直到我们感兴趣的时间点。
我们如何知道历史和当前余额是正确的?——可以通过从头重新计算所有事件来验证正确性。
代码变更后,我们如何证明系统逻辑是正确的?——可以对事件运行不同版本的代码,并验证它们的结果是否一致。
回答客户端关于余额的查询可以使用 CQRS 架构——可以有多个只读状态机,负责基于不可变事件列表查询历史状态:
CQRS 读写分离架构 写路径:客户端提交命令,经命令队列与状态机校验后产生事件并写入事件队列,状态随之更新。读路径:事件被发布给查询服务,由它重建历史状态来回答客户端查询。 写路径 读路径 客户端 命令队列 状态机 事件队列 状态 查询服务 历史状态 提交 读取 生成事件 读取 发布事件 查询 读取 写路径产出事件;读路径消费事件并重建历史状态 按 diagram-design 重绘 查看原图 步骤 3:设计深入探讨
在本节中,我们将探讨一些性能优化,因为系统仍需要扩展到 1mil TPS。
高性能事件溯源 我们要探讨的第一个优化是将命令和事件保存到本地磁盘存储,而不是 Kafka 等外部存储。
这避免了网络延迟,而且由于我们只进行追加操作,这种操作在 HDD 上通常也很快。
下一个优化是将最近的命令和事件缓存在内存中,以节省从磁盘重新加载的时间。
在底层,我们可以通过使用 mmap 来实现上述优化,mmap 会将数据存储在本地磁盘并缓存在内存中:
mmap:内存与磁盘合一 用 mmap 把本地磁盘文件映射进内存:命令列表与事件列表既在内存里快速读写,又落盘持久化;只做追加写,对 HDD 也很快。 内存 磁盘 命令列表 状态机 事件列表 命令文件 事件文件 处理 产出 mmap mmap 内存与磁盘同一份数据;追加写免网络往返 按 diagram-design 重绘 查看原图 我们可以做的下一个优化是使用 SQLite(一种基于文件的本地关系数据库)将状态也存储在本地文件系统中。RocksDB 也是一个很好的选择。
为了满足我们的需求,我们选择 RocksDB,因为它使用日志结构合并树(LSM),针对写操作进行了优化。读性能则通过缓存进行优化。
RocksDB 存储状态 除了命令与事件,状态也存进本地文件系统。选用 RocksDB:它用 LSM-tree 优化写入,读性能则靠内存缓存来补。 内存 磁盘 命令列表 状态机 事件列表 状态 RocksDB 内存缓存 命令文件 RocksDB 文件 事件文件 处理 产出 读写 mmap mmap mmap LSM-tree 优化写;缓存优化读 按 diagram-design 重绘 查看原图 为了优化可重现性,我们可以定期将快照保存到磁盘,这样就不必每次从最开始重现给定状态。我们可以将快照作为大型二进制文件存储在分布式文件存储中,例如 HDFS:
用快照加速重建 定期把状态快照写成大二进制文件存进分布式文件存储(如 HDFS);只读状态机重建时先加载最近一份快照,再从快照之后重放事件,无需每次都从头重放。 对象存储 事件列表 不可变 只读状态机 重建历史状态 客户端 查询 快照 2020-03-03 快照 2020-03-02 读取事件 查询响应 加载快照 先加载最近快照,再重放之后的事件 快照定期写入对象存储 按 diagram-design 重绘 查看原图 可靠的高性能事件溯源 到目前为止所做的优化都很好,但它们使我们的服务变成有状态的。为了可靠性,我们需要引入某种形式的复制。
在此之前,我们应该分析系统中哪种数据需要高可靠性:
状态和快照始终可以通过事件列表重现生成。因此,我们只需要保证事件列表的可靠性。
有人可能认为我们总是可以从命令列表重新生成事件列表,但事实并非如此,因为命令是非确定性的。
结论是我们只需要确保事件列表的高可靠性。
为了实现事件的高可靠性,我们需要将列表复制到多个节点。我们需要保证:
没有数据丢失。
日志文件中数据的相对顺序在所有副本中保持一致。
为此,我们可以采用共识算法,例如 Raft。
在 Raft 中,有一个活跃的领导者(leader)和多个被动的跟随者(follower)。如果领导者宕机,其中一个跟随者会接替。只要超过半数的节点存活,系统就能继续运行。
Raft 复制事件列表 为事件列表做高可靠,需要跨节点复制。用 Raft:一个 Leader 主动、其余 Follower 被动;Leader 把事件复制给 Follower,只要过半节点存活系统就能继续。状态与快照可从事件重放得到,因此只需保证事件列表可靠。 Raft 节点组 客户端 写入 Follower Events 副本 Leader Commands → Events Follower Events 副本 只读状态机 只读状态机 只读状态机 查询 写入 Raft 复制 Raft 复制 同步 同步 同步 只需保证事件列表可靠;过半存活即可继续 按 diagram-design 重绘 查看原图 通过这种方法,所有节点基于事件列表更新状态。Raft 确保领导者和跟随者拥有相同的事件列表。
分布式事件溯源 到目前为止,我们设计出的系统具有较高的单节点性能且可靠。
我们还需要解决一些限制:
单个 Raft 组的容量是有限的。到某个阶段,我们需要对数据进行分片并实现分布式事务。
在 CQRS 架构中,请求/响应流程较慢。客户端需要定期轮询系统,才能知道钱包何时更新。
轮询不是实时的,因此用户可能需要一段时间才能得知余额更新。而且,如果轮询频率过高,可能会使查询服务过载:
轮询获取最新状态 CQRS 的请求 / 响应流较慢,客户端需要周期性轮询才能得知钱包已更新。轮询不是实时的,频率过高还会压垮查询服务。 客户端 Raft Leader 写入 只读状态机 写入 同步事件 周期性轮询 轮询非实时;频率过高会压垮查询服务 按 diagram-design 重绘 查看原图 为了减轻系统负载,我们可以引入反向代理,由它代表用户发送命令并轮询响应:
反向代理代发命令与轮询 引入反向代理:它代替用户发送命令,并代替用户轮询响应,可以用一次请求为多个用户取数,从而降低系统压力;但仍未解决实时性的问题。 用户 反向代理 代发命令 Raft Leader 写入 只读状态机 命令 转发 写入 轮询响应 批量代用户查询,降低系统压力 按 diagram-design 重绘 查看原图 这可以减轻系统负载,因为我们可以通过一个请求为多个用户获取数据,但仍然没有解决实时接收响应的问题。
我们还可以做最后一个改动:让只读状态机在响应可用时将其推送回反向代理。这可以让用户感觉更新是实时发生的:
只读状态机主动推送响应 让只读状态机在响应就绪后主动把结果推回反向代理,而不是等代理轮询,从而让用户感觉更新是实时发生的。 用户 反向代理 代发命令 Raft Leader 写入 只读状态机 命令 转发 写入 实时推送 响应就绪即推送,用户感知为实时 按 diagram-design 重绘 查看原图 最后,为了进一步扩展系统,我们可以将系统分片为多个 Raft 组,并在其上使用协调者通过 TC/C 或 Saga 实现分布式事务:
分片 Raft 组 + 协调者 为继续扩展,把系统拆成多个 Raft 组(分片),组内各自用 Raft 复制、组间用 TC/C 或 Saga 编排分布式事务。协调者把每个操作路由到对应分片,分片的只读状态机把响应推回反向代理。 分片 1(账户 A) 分片 2(账户 C) TC/C 协调者 Saga 阶段状态表 反向代理 Raft 组 分片 1 只读状态机 反向代理 Raft 组 分片 2 只读状态机 命令 A−1 命令 C+1 写入 事件 推送响应 写入 事件 推送响应 记录状态 每个操作路由到对应分片,跨分片用 TC/C 或 Saga 编排 按 diagram-design 重绘 查看原图 以下是最终系统中余额转账请求的示例生命周期:
用户 A 向 Saga 协调者发送一个分布式事务,其中包含两个操作:A-1 和 C+1。
Saga 协调者在阶段状态表中创建一条记录,以跟踪事务状态。
协调者确定需要向哪些分区发送命令。
分区 1 的 Raft 领导者收到 A-1 命令,验证它,将其转换为事件,并在 Raft 组中的其他节点上复制。
事件结果同步到只读状态机,只读状态机将响应推送回协调者。
协调者创建一条记录,表明该操作成功,并继续执行下一个操作:C+1。
下一个操作与第一个操作类似:确定分区、发送命令、执行,只读状态机推送回响应。
协调者创建一条记录,表明操作 2 也成功,并最终将结果告知客户端。
步骤 4:总结
以下是我们的设计演进过程:
我们从使用内存 Redis 的解决方案开始。这种方案的问题在于它不是持久化存储。
随后转向使用关系型数据库,并在其上使用 2PC、TC/C 或分布式 Saga 执行分布式事务。
接下来,我们引入事件溯源,使所有操作都可审计。
我们最初使用外部数据库和队列将数据存储到外部存储,但性能不佳。
接着我们改为将数据存储在本地文件存储中,利用追加操作的性能。我们还使用缓存优化读路径。
之前的方案虽然性能好,但不持久。因此,我们引入了带复制的 Raft 共识来避免单点故障。
我们还采用 CQRS 与反向代理,代表用户管理事务生命周期。
最后,我们将数据分区到多个 Raft 组,并通过分布式事务机制(TC/C 或分布式 Saga)进行编排。
第 28 章:证券交易所
引言
本章我们将设计一个电子证券交易所 。
它的基本功能是高效地撮合买方和卖方。
主要的证券交易所包括 NYSE 、NASDAQ 等。
全球主要交易所 按市值划分的全球主要交易所:美洲有 NYSE、NASDAQ、TMX;欧洲/中东/非洲有伦敦证交所、泛欧交易所、德意志交易所、SIX 瑞士交易所;亚太有上交所、深交所、日本交易所集团、港交所、韩国交易所。气泡越大代表市值越高。 美洲 欧洲 / 中东 / 非洲 亚太 NYSE NASDAQ TMX 集团 伦敦证交所 泛欧交易所 德意志交易所 SIX 瑞士交易所 上交所 深交所 日本交易所集团 港交所 韩国交易所 气泡越大代表市值越高 交易所的基本职能:高效撮合买卖双方 按 diagram-design 重绘 查看原图 第 1 步:理解问题并确定设计范围
C:我们要交易哪些证券?股票、期权还是期货?
I:为简单起见,只交易股票
C:支持哪些订单类型——下单、取消、替换?限价单、市价单、条件单呢?
I:我们需要支持下单和取消订单。订单类型只考虑限价单。
C:系统需要支持盘后交易吗?
I:不需要,只支持正常交易时间
C:能描述一下交易所的基本功能吗?
I:客户可以实时下达或取消限价单,并接收匹配成交。客户还应能实时查看订单簿。
C:交易所的规模如何?
I:数万名用户同时交易,约 100 个标的。每天数十亿笔订单。我们还需要支持合规风控检查。
C:需要哪些风控检查?
I:先做简单的风控检查——例如限制用户一天最多只能交易 100 万股苹果股票。
C:用户钱包如何接入?
I:我们需要确保客户在下单前有足够的资金。未完成订单所占用的资金需要被冻结,直到订单最终完成。
非功能需求 面试官提到的规模暗示我们要设计一个中小型交易所。我们还需要确保灵活性,以便未来支持更多标的和用户。
其他非功能需求:
可用性——至少 99.99%。停机可能损害声誉。
容错——需要容错和快速恢复机制,以限制生产事故的影响。
延迟——往返延迟应在毫秒级,重点关注 99 百分位。持续较高的 99 百分位延迟会给少数用户带来糟糕体验。
安全——应有账户管理系统。为了合规,需要支持 KYC 验证用户身份。还应保护公开资源免受 DDoS 攻击。
粗略估算
100 个标的,每天 10 亿笔订单
正常交易时间为 09:30 到 16:00(6.5 小时)
QPS = 10 亿 / 6.5 / 3600 = 43000
峰值 QPS = 5 * QPS = 215000
市场开盘时交易量会显著更高
第 2 步:提出高层设计并获得认可
业务知识入门 让我们讨论一些与交易所相关的基本概念。
经纪商在交易所和最终用户之间充当中介——例如 Robinhood、Fidelity 等。
机构客户使用专门的交易软件进行大宗交易。他们需要特殊处理。例如,大宗交易时需要拆分订单,以避免冲击市场。
订单类型:
限价单——以固定价格买入或卖出。可能不会立即成交,也可能部分成交。
市价单——不指定价格,立即以当前市场价格成交。
价格:
Bid——买方愿意买入一只股票的最高价格。
Ask——卖方愿意卖出一只股票的最低价格。
美国市场有三档报价——L1、L2、L3。
L1 市场数据包含最佳买价/卖价和数量:
L1 行情 L1 行情只包含最优买价与最优卖价及其数量。以 APPLE 为例,最优卖价(ask)为 100.10、数量 1800;最优买价(bid)为 100.08、数量 2000。卖价始终高于买价,二者之差即买卖价差。 APPLE 股票 最优卖价 100.10 · 1800 最优买价 100.08 · 2000 L1 只含最优买卖价与数量 卖价高于买价,价差为 0.02 按 diagram-design 重绘 查看原图 L2 包含更多价格档位:
L2 行情 L2 行情在 L1 基础上展开多档价格:卖盘从最优卖价 100.10 向上到 100.13,买盘从最优买价 100.08 向下到 100.05,每档给出挂单数量。价差仍是 0.02,但可以看到更深的挂单分布。 卖盘(卖价由高到低) 买盘(买价由高到低) 100.13 300 100.12 1500 100.11 2000 100.10 最优卖价 1800 100.08 最优买价 2000 100.07 800 100.06 2000 100.05 600 L2 展示多档价格与每档数量 按 diagram-design 重绘 查看原图 L3 显示各档位以及每个档位的排队数量:
L3 行情 L3 行情在每个价位上进一步列出排队中的每一笔挂单数量。以卖盘 100.11 为例,队列为 900、700、400;买盘 100.06 的队列为 1100、400、300、200。它揭示了同一价位内部的挂单顺序。 卖盘(卖价由高到低) 买盘(买价由高到低) 100.12 600 · 900 100.11 900 · 700 · 400 100.10 最优卖价 200 · 400 · 1100 · 100 100.08 最优买价 500 · 600 · 900 100.07 100 · 700 100.06 1100 · 400 · 300 · 200 L3 列出每个价位上排队中的每一笔挂单 按 diagram-design 重绘 查看原图 K 线图显示给定时间区间内的开盘价和收盘价,以及最高价和最低价:
蜡烛图的构成 一根蜡烛图记录区间内的四个价格:最高价与开盘价之间是上影线,开盘价与收盘价之间是实体,收盘价与最低价之间是下影线。图中用竖排的价格节点示意这一结构。 最高价 High 开盘价 Open 收盘价 Close 最低价 Low 上影线 实体 下影线 蜡烛图四价 影线=最高/最低,实体=开盘/收盘 按 diagram-design 重绘 查看原图 FIX 是用于交换证券交易信息的协议,大多数供应商都使用它。示例证券交易:
8=FIX.4.2 | 9=176 | 35=8 | 49=PHLX | 56=PERS | 52=20071123-05:30:00.000 | 11=ATOMNOCCC9990900 | 20=3 | 150=E | 39=E | 55=MSFT | 167=CS | 54=1 | 38=15 | 40=2 | 44=15 | 58=PHLX EQUITY TESTING | 59=0 | 47=C | 32=0 | 31=0 | 151=15 | 14=0 | 6=0 | 10=128 |
高层设计
交易所高层设计 交易流(关键路径):客户端经经纪商下单,客户端网关做校验/限流/鉴权后转给订单管理器;订单管理器做风控校验、核对钱包,再把订单交给定序器,定序器定序后送撮合引擎撮合。撮合引擎把成交流交给行情发布器,行情发布器生成行情给数据服务;订单管理器把订单与成交交给报告器落库。 客户端 下单 经纪商 客户端网关 限流/鉴权 订单管理器 钱包 定序器 撮合引擎 订单簿 聚合风控 行情发布器 数据服务 报告器 数据库 订单 / 成交 下单 转发 校验 订单 定序 风控 放行 成交流 行情 回报 落库 交易流在关键路径上,其余流程非关键 按 diagram-design 重绘 查看原图 交易流程:
客户通过交易界面下单。
经纪商将订单发送到交易所。
订单通过客户端网关进入交易所,网关负责校验、限流、认证等。订单随后转发给订单管理器。
订单管理器根据风控管理器设定的规则执行风控检查。
通过风控检查后,订单管理器验证钱包中是否有足够资金用于该订单。
订单发送到撮合引擎。发现匹配后,撮合引擎为买方和卖方生成两笔执行(称为成交回报)。买卖订单都会被排序,以保证确定性。
成交回报返回给客户。
行情数据流(M1-M3):
撮合引擎生成执行流,发送给行情数据发布器。
行情数据发布器构建 K 线图并发送到数据服务。
行情数据存储在专门的实时分析存储中。经纪商连接到数据服务以获取及时行情。
报告流(R1-R2):
报告器从订单和执行中收集所有必需的申报字段,并写入数据库。
申报字段 - client_id、price、quantity、order_type、filled_quantity、remaining_quantity
交易流位于关键路径上,而其他流不在,因此它们之间的延迟要求不同。
交易流程
交易流位于关键路径上,因此应针对低延迟进行高度优化。
撮合引擎是其核心,也称为交叉引擎。主要职责:
维护每个标的的订单簿——即某个标的的买入/卖出订单列表。
撮合买入和卖出订单——一次匹配会产生两笔执行(成交回报),买卖双方各一笔。该功能必须快速且准确。
将执行流作为行情数据分发。
匹配必须按确定性顺序产生。这是高可用的基础。
接下来是排序器——它通过对每个入站订单和出站成交回报加盖序列 ID,使撮合引擎具有确定性。
定序器 定序器是让撮合引擎具备确定性的关键组件:订单管理器把入站订单交给入站定序器,入站定序器打上序列号后送撮合引擎;撮合产生的成交由出站定序器打号后回到订单管理器。两端各有一个定序器,保证入站与出站的事件顺序一致。 订单管理器 入站定序器 撮合引擎 出站定序器 订单 定序 成交 回报 入站与出站各一个定序器,保证事件顺序一致 按 diagram-design 重绘 查看原图 我们为入站订单和出站成交回报加盖序列 ID 有几个原因:
从概念上讲,我们可以使用 Kafka 作为排序器,因为它实际上就是一个入站和出站消息队列。但是,为了实现更低的延迟,我们将自己实现。
订单管理器管理订单状态。它还和撮合引擎交互——发送订单并接收成交回报。
订单管理器的职责:
发送订单进行风控检查——例如验证用户交易量少于 100 万。
根据用户钱包检查订单,验证有足够资金执行订单。
将订单发送到排序器,再传给撮合引擎。为减少带宽,只把必要的订单信息传给撮合引擎。
成交回报从排序器接收回来,然后通过客户端网关发送给经纪商。
实现订单管理器的主要挑战是状态转移管理。事件溯源是一种可行方案(在深入探讨部分讨论)。
最后,客户端网关接收用户订单并将其发送给订单管理器。其职责如下:
客户端网关的职责 客户端网关接收用户的订单并转交给订单管理器,自身承担鉴权、校验、限流、规范化与 FIXT 协议支持等职责。由于它处在关键路径上,必须保持轻量。 网关 鉴权 校验 限流 规范化 FIXT 支持 网关在关键路径上,须保持轻量 职责:鉴权、校验、限流、规范化、FIXT 按 diagram-design 重绘 查看原图 由于客户端网关位于关键路径上,它应保持轻量。
可以为不同客户端部署多个客户端网关。例如,colo 引擎是经纪商在交易所数据中心租用的交易引擎服务器:
多客户端网关 交易所针对不同客户提供不同的接入网关:交易所网站/App 经 HTTP 走 App/Web 网关;经纪商/自营商走支持 FIX/非 FIX 的 API 网关;其他 API 用户可走托管引擎(colo engine,券商租用的交易服务器)。各网关再汇入后端的共享服务。 交易所 交易所网站 / App 经纪商 / 自营商 其他 API 用户 App/Web 网关 API 网关 FIX / 非 FIX 托管引擎 分片服务 HTTP FIX 其他 转发 转发 不同客户走不同网关 托管引擎:券商租用的交易服务器 按 diagram-design 重绘 查看原图 行情数据流
行情数据发布器从撮合引擎接收成交回报,并根据执行流构建订单簿/K 线图。
这些数据被发送到数据服务,数据服务负责向订阅者展示聚合数据:
行情数据流 撮合引擎把订单与撮合结果送给行情发布器(MDP)。MDP 为每个标的维护订单簿,并从成交流重建蜡烛图;蜡烛图再写入持久化存储,最终由数据服务对外展示聚合后的行情。 行情发布器 MDP 撮合引擎 订单簿 订单簿 订单簿 蜡烛图 按时间窗聚合 持久化 数据服务 订单 / 成交 聚合 发布 订单簿按标的维护 按 diagram-design 重绘 查看原图 报告流
报告器不在关键路径上,但它仍然是一个重要组件。
报告流 报告器从订单管理器收集订单与成交信息,生成执行报告,分发给结算与清算、账簿与记录两条下游路径,最终汇总为监管报送并落库。报告流不在关键路径上,准确与合规比延迟更重要。 撮合管理器 订单管理器 报告器 ExecutionReport 结算与清算 账簿与记录 监管报送 数据库 成交 订单 订单 / 成交 结算 记账 报送 报送 报告流不在关键路径,重准确与合规 结算/记账汇总到监管报送后落库 按 diagram-design 重绘 查看原图 它负责交易历史、税务报告、合规报告、结算等。延迟不是报告流的关键要求。准确性和合规性更为重要。
API 设计 客户通过经纪商与证券交易所交互,进行下单、查看成交、行情数据、下载历史数据进行分析等。
客户端网关和经纪商之间使用 RESTful API 通信。
对于机构客户,使用专有协议以满足其低延迟要求。
创建订单:
POST /v1/order
参数:
symbol - 股票代码。String
side - 买入或卖出。String
price - 限价单价格。Long
orderType - 限价或市价(我们的设计仅支持限价单)。String
quantity - 订单数量。Long
响应:
id - 订单 ID。Long
creationTime - 订单系统创建时间。Long
filledQuantity - 已成功成交的数量。Long
remainingQuantity - 尚未成交的数量。Long
status - new/canceled/filled。String
其余属性与输入参数相同
获取成交:
GET /execution?symbol={:symbol}&orderId={:orderId}&startTime={:startTime}&endTime={:endTime}
参数:
symbol - 股票代码。String
orderId - 订单 ID。可选。String
startTime - 查询开始时间(epoch)[11]。Long
endTime - 查询结束时间(epoch)。Long
响应:
executions - 数组,包含范围内的每笔成交(属性见下文)。Array
id - 成交 ID。Long
orderId - 订单 ID。Long
symbol - 股票代码。String
side - 买入或卖出。String
price - 成交价格。Long
orderType - 限价或市价。String
quantity - 成交数量。Long
获取订单簿:
GET /marketdata/orderBook/L2?symbol={:symbol}&depth={:depth}
参数:
symbol - 股票代码。String
depth - 每侧订单簿深度。Int
响应:
bids - 价格和数量数组。Array
asks - 价格和数量数组。Array
获取 K 线:
GET /marketdata/candles?symbol={:symbol}&resolution={:resolution}&startTime={:startTime}&endTime={:endTime}
参数:
symbol - 股票代码。String
resolution - K 线图窗口长度,单位秒。Long
startTime - 窗口开始时间(epoch)。Long
endTime - 窗口结束时间(epoch)。Long
响应:
candles - 数组,包含每根 K 线数据(属性如下)。Array
open - 每根 K 线的开盘价。Double
close - 每根 K 线的收盘价。Double
high - 每根 K 线的最高价。Double
low - 每根 K 线的最低价。Double
数据模型 我们的交易所主要有三类数据:
产品、订单、成交
产品描述交易标的的属性——产品类型、交易代码、UI 显示代码等。
这些数据不经常变化,主要用于 UI 展示。
订单代表买入/卖出指令。成交是出站的匹配结果。
数据模型如下:
订单、成交与产品数据模型 交易所的三类核心数据:Product 描述标的属性,Order 表示买卖指令,Execution 是撮合产出的成交结果。一笔订单可产生多笔成交(1 : 0..n),而每笔订单关联一个产品(1 : 1)。 Order orderID, price, qty, side Execution execID, orderID, price, qty Product productID, symbol, lotSize 1 : 0..n 1 : 1 订单、成交、产品三类数据 一笔订单可产生多笔成交 按 diagram-design 重绘 查看原图 我们在三个流程中都会遇到订单和成交:
在关键路径中,它们在内存中处理以获得高性能。它们存储在排序器中并从中恢复。
报告器将订单和成交写入数据库,用于报告用途。
成交被转发到行情数据,以重建订单簿和 K 线图。
订单簿
订单簿是某个金融工具的买入/卖出订单列表,按价格档位组织。
该模型的高效数据结构需要满足:
常数查找时间——获取某个价格档位或价格档位之间的数量。
快速添加/成交/取消操作。
查询最佳买价/卖价。
遍历价格档位。
订单簿执行示例:
订单簿撮合示例 当一笔买入 2700 股的市价单进入时,撮合引擎会逐档吃掉卖盘:200 + 400 + 1100 + 100 + 900 = 2700。大单吃穿多档后,最优卖价被推高、买卖价差走阔。 卖盘 Ask 买盘 Bid 100.12 600 · 900 100.11 900 · 700 · 400 100.10 最优卖价 200 · 400 · 1100 · 100 100.08 最优买价 500 · 600 · 900 100.07 100 · 700 100.06 1100 · 400 · 300 · 200 吃 2700 股 买入 2700 股逐档吃掉卖盘,价差走阔 按 diagram-design 重绘 查看原图 在完成这笔大订单后,由于买卖价差扩大,价格上涨。
订单簿实现的伪代码示例:
class PriceLevel{
    private Price limitPrice;
    private long totalVolume;
    private List<Order> orders;
}

class Book<Side> {
    private Side side;
    private Map<Price, PriceLevel> limitMap;
}

class OrderBook {
    private Book<Buy> buyBook;
    private Book<Sell> sellBook;
    private PriceLevel bestBid;
    private PriceLevel bestOffer;
    private Map<OrderID, Order> orderMap;
}
为了更高效的实现,我们可以使用双向链表代替普通链表:
下新订单是 O(1),因为我们将订单添加到链表尾部。
匹配一个订单是 O(1),因为我们从头部删除一个订单。
取消订单意味着从订单簿中删除一个订单。我们利用 orderMap 实现 O(1) 查找和 O(1) 删除(因为 Order 持有指向链表中前一个元素的引用)。
订单簿实现 订单簿用 limitMap 把价格映射到价位(PriceLevel),每个价位内部用双向链表保存该价位的订单;orderMap 则把 orderID 映射到订单,使撤单可 O(1) 定位。挂单加到链表尾、撮合从链表头删除,都是 O(1)。 买盘档位 limitMap 价格 → 档位 100.08 Order 500,600,900 100.07 Order 100,700,200 100.06 Order 1100,300,200 orderMap orderID → Order limitMap:价格映射到价位 每个价位内部是双向链表 orderMap 让撤单可 O(1) 定位 按 diagram-design 重绘 查看原图 该数据结构也用于行情数据服务中以重建订单簿。
K 线图
K 线数据在行情数据服务中基于处理某个时间间隔内的订单计算得出:
class Candlestick {
    private long openPrice;
    private long closePrice;
    private long highPrice;
    private long lowPrice;
    private long volume;
    private long timestamp;
    private int interval;
}

class CandlestickChart {
    private LinkedList<Candlestick> sticks;
}
为避免消耗过多内存,可做以下优化:
使用预分配的环形缓冲区保存 K 线,以减少分配次数。
限制内存中的 K 线数量,其余持久化到磁盘。
我们将使用内存列式数据库(例如 KDB)进行实时分析。收盘后,数据持久化到历史数据库中。
第 3 步:设计深入探讨
关于现代交易所,值得注意的一点是:与大多数其他软件不同,它们通常把所有东西都运行在一台巨大服务器上。
让我们深入探讨细节。
性能 对于交易所,让所有百分位的整体延迟都表现良好非常重要。
如何降低延迟?
减少关键路径上的任务数量。
通过减少网络/磁盘使用和/或减少任务执行时间来缩短每个任务的耗时。
为了实现第一个目标,我们将关键路径上所有无关职责都剥离掉,甚至移除了日志以实现最佳延迟。
如果按照原始设计,会有几个瓶颈——服务之间的网络延迟和排序器的磁盘使用。
在这种设计下,我们可以实现几十毫秒的端到端延迟。但我们希望实现几十微秒。
因此,我们会把所有内容放在一台服务器上,进程通过 mmap 作为事件存储进行通信:
单机 mmap 总线 现代交易所常把一切放在一台服务器上:订单管理器、撮合引擎、行情发布器各自跑在应用循环里,通过 mmap 事件总线通信;报告器、日志、聚合风控、持仓管理等下游进程同样订阅这条总线。进程间没有网络与磁盘访问,从而把端到端延迟压到微秒级。 单台服务器 订单管理器 应用循环 撮合引擎 应用循环 行情发布器 应用循环 mmap 事件总线 报告器 日志 聚合风控 持仓管理 写入 写入 写入 订阅 订阅 订阅 订阅 所有进程通过 mmap 共享内存通信,无网络与磁盘 按 diagram-design 重绘 查看原图 另一个优化是使用应用程序循环(执行关键任务的 while 循环),并固定到同一个 CPU 上以避免上下文切换:
应用循环 订单管理器内部用一个应用循环(while 循环执行关键任务)串起处理:输入线程收到订单后 dispatch 给应用循环线程,循环更新订单状态并把指令 dispatch 给输出线程。循环被绑定到同一个 CPU 上,避免上下文切换,也就没有锁竞争。 输入线程 Netloop 应用循环线程 绑定 CPU 1 输出线程 Netloop 订单状态 CPU 1 避免上下文切换 dispatch dispatch update 绑定 应用循环绑定同一 CPU,避免上下文切换 没有锁竞争:只有一个线程操作状态 按 diagram-design 重绘 查看原图 使用应用程序循环的另一个副作用是没有锁竞争——即多个线程争夺同一资源。
现在让我们看看 mmap 的工作原理——它是一个 UNIX 系统调用,把磁盘上的文件映射到应用程序内存。
我们可以使用的一个技巧是在 /dev/shm 中创建文件,它代表“共享内存”。这样一来,我们完全不需要访问磁盘。
事件溯源 事件溯源在数字钱包章节 中有深入讨论。所有细节请参考该章。
简而言之,我们不存储当前状态,而是存储不可变的状态转移:
事件溯源 传统方案只保存当前状态:订单表里 Order 从 V1/New 变成 V2/Filled,中间过程丢失。事件溯源改为保存不可变的状态迁移:事件表记录 100/NewOrderEvent、101/OrderFilledEvent,任何时刻都能重放事件重建出当前状态。 Order V1 New Order V2 Filled Order Version / Status Event Sequence / Type OrderFilled 非事件溯源:只存当前状态 事件溯源:存不可变事件 按 diagram-design 重绘 查看原图
到目前为止,我们的设计如下:
设计雏形 外部域通过 FIX 协议与网关交互,网关把 NewOrderEvent 写入 mmap 事件存储;撮合引擎内的订单管理器校验事件、更新订单状态并交给应用循环与撮合核心,撮合核心产生 OrderFilledEvent 写回事件存储。行情发布器与报告器各自订阅事件存储做后续处理。 撮合引擎 网关 FIX 订单管理器 撮合核心 应用循环 事件存储客户端 事件存储 mmap 行情发布器 报告器 NewOrderEvent 校验/更新 发送撮合 NewOrderEvent Events Events 设计雏形 外部域 (FIX) 行情 / 报告订阅事件 按 diagram-design 重绘 查看原图
外部域使用 FIX 协议与我们的客户端网关交互。
订单管理器接收新订单事件,验证后将其添加到内部状态。订单随后发送到撮合核心。
如果订单匹配成功,会生成 OrderFilledEvent 并通过 mmap 发送。
其他组件订阅事件存储并执行各自的处理。
另一个优化——所有组件都持有订单管理器的副本,它被打包成库,以避免管理订单时的额外调用。
在这个设计中,排序器不再作为事件存储,而是单一写入者,在将事件转发到事件存储之前对事件进行排序:
定序器深挖 在这个设计里定序器不再充当事件存储,而是作为单一写入者:网关与撮合引擎各自把数据写入环形缓冲,定序器从环形缓冲拉取、定序后写入 mmap 事件存储。这样事件存储只接受定序器的写入,顺序完全确定。 网关 撮合引擎 环形缓冲 环形缓冲 定序器 事件存储 mmap 写入 写入 写入 定序器从环形缓冲拉取数据 按 diagram-design 重绘 查看原图 高可用性 我们的目标是 99.99% 可用性——每天只有 8.64 秒停机时间。
为此,我们必须找出交易所架构中的单点故障:
为关键服务(如撮合引擎)设置备用实例,并保持待命。
积极自动化故障检测和故障转移到备用实例。
无状态服务(如客户端网关)可以通过增加服务器轻松水平扩展。
对于有状态组件,如果我们不是领导者,可以处理入站事件,但不发布出站事件:
主备选举 为实现高可用,撮合引擎部署热(Hot)与温(Warm)两个实例。热实例正常处理读写:从事件存储消费 NewOrderEvent、写回 OrderFilledEvent。温实例处于待命,只消费 NewOrderEvent 而不对外发布事件,一旦热实例失联即可接管。 撮合引擎(热) 撮合引擎(温) 事件存储 mmap NewOrderEvent OrderFilled NewOrderEvent 热实例处理读写,温实例仅接收订单 心跳检测主实例是否存活 按 diagram-design 重绘 查看原图 为了检测主副本是否宕机,我们可以发送心跳来检测它是否失效。
这种机制只在单个服务器的边界内有效。
如果我们想扩展它,可以将整台服务器设置为热/温副本,并在发生故障时进行故障转移。
为了在副本之间复制事件存储,我们可以使用可靠 UDP 以加快通信。
容错 如果连温备实例也宕机了怎么办?这是一个低概率事件,但我们应该做好准备。
大型科技公司通过将核心数据复制到多个城市的数据中心来应对这种问题,以减轻自然灾害等影响。
需要考虑的问题:
如果主实例宕机,我们如何以及何时故障转移到备用实例?
如何在备用实例之间选出领导者?
所需恢复时间是多少(RTO - 恢复时间目标)?
哪些功能需要恢复?系统能否在降级情况下运行?
如何应对这些问题:
系统可能因 bug 宕机(影响主副本和从副本)——我们可以使用混沌工程来暴露此类边界情况和灾难性后果。
不过,一开始可以手动执行故障转移,直到我们充分了解系统的故障模式。
领导者选举(例如 Raft)可用于在主节点宕机时决定哪个副本成为领导者。
以下是复制在不同服务器之间如何工作的示例:
跨服务器复制 事件存储跨多台服务器复制:主事件存储接收热撮合引擎的读写,并通过 AppendEntries RPC 把日志同步到各个副本;温撮合引擎只从事件存储消费 NewOrderEvent。多副本保证了即使主实例故障数据也不丢失。 撮合引擎(热) 撮合引擎(温) 事件存储 mmap(主) 事件存储 mmap(副本 1) 事件存储 mmap(副本 2) 事件存储 mmap(副本 3) NewOrderEvent OrderFilled NewOrderEvent AppendEntries 主副本通过 AppendEntries RPC 同步到其余副本 按 diagram-design 重绘 查看原图 领导者选举任期示例:
选举任期 Raft 把时间切成一个个任期:任期 1、2 以选举开始;任期 3 是稳定的正常运行期;任期 4 因选票分裂没有选出领导者,很快进入任期 5 重新选举。任期编号单调递增,是判断新旧信息的依据。 任期 1 选举 任期 2 选举 任期 3 正常运行 任期 4 选票分裂 任期 5 正常运行 时间轴:任期与选举 任期 4 因选票分裂重新选举 按 diagram-design 重绘 查看原图 有关 Raft 工作原理的详细信息,请查看此内容
最后,我们还需要考虑丢失容忍度——在事情变得严重之前,我们可以丢失多少数据?
这将决定我们备份数据的频率。
对于证券交易所,数据丢失是不可接受的,因此我们必须经常备份数据,并依靠 Raft 的复制来降低数据丢失的概率。
匹配算法 稍微偏离一下,通过伪代码了解匹配如何工作:
Context handleOrder(OrderBook orderBook, OrderEvent orderEvent) {
    if (orderEvent.getSequenceId() != nextSequence) {
        return Error(OUT_OF_ORDER, nextSequence);
    }

    if (!validateOrder(symbol, price, quantity)) {
        return ERROR(INVALID_ORDER, orderEvent);
    }

    Order order = createOrderFromEvent(orderEvent);
    switch (msgType):
        case NEW:
            return handleNew(orderBook, order);
        case CANCEL:
            return handleCancel(orderBook, order);
        default:
            return ERROR(INVALID_MSG_TYPE, msgType);

}

Context handleNew(OrderBook orderBook, Order order) {
    if (BUY.equals(order.side)) {
        return match(orderBook.sellBook, order);
    } else {
        return match(orderBook.buyBook, order);
    }
}

Context handleCancel(OrderBook orderBook, Order order) {
    if (!orderBook.orderMap.contains(order.orderId)) {
        return ERROR(CANNOT_CANCEL_ALREADY_MATCHED, order);
    }

    removeOrder(order);
    setOrderStatus(order, CANCELED);
    return SUCCESS(CANCEL_SUCCESS, order);
}

Context match(OrderBook book, Order order) {
    Quantity leavesQuantity = order.quantity - order.matchedQuantity;
    Iterator<Order> limitIter = book.limitMap.get(order.price).orders;
    while (limitIter.hasNext() && leavesQuantity > 0) {
        Quantity matched = min(limitIter.next.quantity, order.quantity);
        order.matchedQuantity += matched;
        leavesQuantity = order.quantity - order.matchedQuantity;
        remove(limitIter.next);
        generateMatchedFill();
    }
    return SUCCESS(MATCH_SUCCESS, order);
}
该匹配算法使用 FIFO 算法来确定在某个价格档位上先匹配哪些订单。
确定性 功能确定性通过我们使用的排序器技术得到保证。
事件实际发生的时间并不重要:
确定性 功能确定性由定序器保证:事件真实发生的时刻并不重要,重要的是定序器赋予它们的顺序。上排事件在真实时间里间隔不均,下排经定序器编号后间隔均匀,只要顺序一致,重放就能得到完全相同的结果。 事件 1 事件 2 事件 3 事件 4 事件 5 事件 6 事件 1 事件 2 事件 3 事件 4 事件 5 事件 6 真实发生时刻 定序器编号后 顺序由定序器决定,与真实时刻无关 按 diagram-design 重绘 查看原图 延迟确定性是必须跟踪的。我们可以基于监控 99 百分位或 99.99 百分位延迟来计算它。
可能导致延迟尖峰的因素包括例如 Java 中的垃圾收集事件。
行情数据发布器优化 行情数据发布器从撮合引擎接收匹配结果,并基于这些结果重建订单簿和 K 线图。
由于内存有限,我们只保留部分 K 线。客户可以选择所需信息的粒度。更细粒度的信息可能需要更高的价格:
行情发布器优化 行情发布器为每个标的维护订单簿,并基于成交流重建蜡烛图。蜡烛图按时间分辨率(1 分钟、1 小时、1 天)分别保存,用预分配的环形缓冲只保留最近 100 笔,避免频繁分配内存;再写入持久化并交给数据服务。 行情发布器 MDP 蜡烛图 撮合引擎 订单簿 订单簿 订单簿 1 分钟 1 小时 1 天 持久化 数据服务 订单 / 成交 聚合 发布 环形缓冲只保留最近 100 笔 按 diagram-design 重绘 查看原图 环形缓冲区(也称循环缓冲区)是一种固定大小的队列,头尾相连。其空间预先分配以避免运行中分配。该数据结构也是无锁的。
另一种优化环形缓冲区的技术是填充(padding),确保序列号不会与其他任何内容处于同一缓存行。
行情数据分发公平性与组播 我们需要确保订阅者同时收到数据,因为如果有人先收到数据,就会获得关键市场信息,并可能利用这些信息操纵市场。
为此,我们可以在向订阅者发布数据时使用基于可靠 UDP 的组播。
数据通过互联网传输有三种方式:
单播——一个源,一个目的地。
广播——一个源到整个子网。
组播——一个源到不同子网上的一组主机。
理论上,通过组播,所有订阅者应该同时收到数据。
然而 UDP 不可靠,数据可能无法到达所有接收者。不过可以通过重传来增强。
主机托管 交易所允许经纪商将服务器托管在与交易所相同的数据中心。
这大幅降低延迟,可视为一种 VIP 服务。
网络安全 由于交易所有一些面向互联网的服务,DDoS 是一个挑战。我们的选择如下:
将公共服务和数据与私有服务隔离,使 DDoS 攻击不会影响最重要的客户。
使用缓存层存储不经常更新的数据。
对 URL 进行加固以抵御 DDoS,例如优先使用 https://my.website.com/data/recent,而不是 https://my.website.com/data?from=123&to=456,因为前者更易缓存。
需要有效的允许列表/阻止列表机制。
可以使用限流来缓解 DDoS。
第 4 步:总结
其他值得注意的事项:
并非所有交易所都依赖把所有内容放在一台大服务器上,但有些仍然如此。
现代交易所更多依赖云基础设施,也依赖自动做市商(AMM)来避免维护订单簿。
这些笔记基于《系统设计面试》书籍——第 1 卷和第 2 卷第 2 版
在此查看笔记:https://pagefy.io/system-design/system-design-interview-by-alex-xu
**注意:**这些笔记仍在编写中。
其他资源
限流
一致性哈希
键值存储
唯一 ID 生成器
网络爬虫
聊天系统
搜索自动补全
Youtube
Google Drive